Anthropic Fable 5.2 真实自由职业任务完成率达 41%
Anthropic 新模型 Fable 5.2 在 Scale Labs 与 CAIS 的 Remote Labor Index 上以 41.3% 的完成率登顶,该基准衡量 AI 智能体能否以专业质量完成真实付费自由职业任务。一年前榜首 Manus 仅完成 2.5%,显示智能体在实用工作上的能力正快速跃升。
报道正文
本文目录3 个章节
Anthropic 的 Fable 5.2 可完成 41% 的真实自由职业工作,一年前仅为 2.5%
[Maximilian Schreiner](https://the-decoder.com/author/maximilian-schreiner/) [查看 Maximilian Schreiner 的 LinkedIn 个人资料](https://www.linkedin.com/in/maximilian-schreiner-b6a5171aa/) 2026 年 11 月 10 日 
由 THE DECODER 提示生成的 Nano Banana Pro
Anthropic 的新模型 Fable 5.2 在远程劳动指数(Remote Labor Index)上实现巨大飞跃,能以专业水准完成超过 41% 的真实自由职业项目。该系统将直接前代模型和整个竞争对手远远甩在身后。
在 Scale Labs 与人工智能安全中心(CAIS)发布的远程劳动指数(RLI)上,Anthropic 的新模型 Fable 5.2 以 41.3% 的成绩位居榜首。该测试衡量的是 AI 智能体完成真实自由职业工作的比例,且完成质量需达到付费客户愿意接受的程度。
这一进展表明 AI 智能体在实际工作上的追赶速度有多快。该基准大约一年前推出时,当时最强的系统 Manus 仅能完成 2.5% 的任务。如今 Fable 5.2 完成的专业工作数量已是当时的 16 倍以上。
与最近的测量结果相比,这一跃升同样显著。今年 7 月,同一家族中较旧的模型 Fable 5 仍以约 16% 的成绩领先。那个分数本身已是重大进步:最好的智能体在八个月内将能以专业质量完成的工作比例提高了四倍以上。四个月后,Fable 5.2 达到 41.3%,约为 Fable 5 七月得分的 2.5 倍。其直接前代 Fable 5.1 也以略低于 18% 的成绩远远落后,而 Fable 5.2 完成的工作量是其两倍以上。
 Fable 5.2 拉开与竞争对手的差距。 | 图片:Scale Labs
当前排行榜的下一批位置由 Anthropic 的 Opus 5.5 以 21.25% 占据,OpenAI 的 GPT 6 Astra 以 20.83% 紧随其后。Fable 5.2 的成功率几乎是市场上次优系统的两倍。谷歌在测试中最强的模型 Gemini Argon 4 以 17.08% 位列第五,而 GPT-5.2 或 Gemini 3 Pro 等较旧模型则低于 3%。
Fable 5.2 在 3D 模型、音频和建筑领域取得突破
Scale Labs 在 X 上表示,Fable 5.2 进步最大的领域是音频和音乐编辑、建筑与室内空间设计,以及 3D 模型创建。该智能体还能处理此前排名靠前的模型经常失败的长期复杂项目。
Fable 5.2 近 50 项成功完成的任务,是测试中此前没有任何 AI 智能体解决过的工作。Scale Labs 表示,该 AI 在其他任务上仍几乎无能为力,尤其是工业产品设计和动画。研究人员称,当 AI 智能体在测试中失败时,它们通常交付业余水准的作品、不完整的结果、损坏的文件或自相矛盾的设计。
价值 14.4 万美元的真实工作
与通常只考察孤立技能的传统 AI 测试不同,RLI 研究论文涵盖完整的工作任务。该数据集包含来自 Upwork 平台上 358 位经过验证的专业人士的 240 个已完成项目。这些工作合计价值约 14.4 万美元。
单个项目平均费用为 632.60 美元,人类自由职业者平均需要近 29 小时完成。任务范围从视频编辑到 CAD 设计、游戏开发和数据分析。为了完成这些工作,AI 智能体可以使用一个虚拟工作区,其中包含 Blender、GIMP 或 Audacity 等常用专业软件,以及用于图像、音频和视频生成的专用 AI 工具。
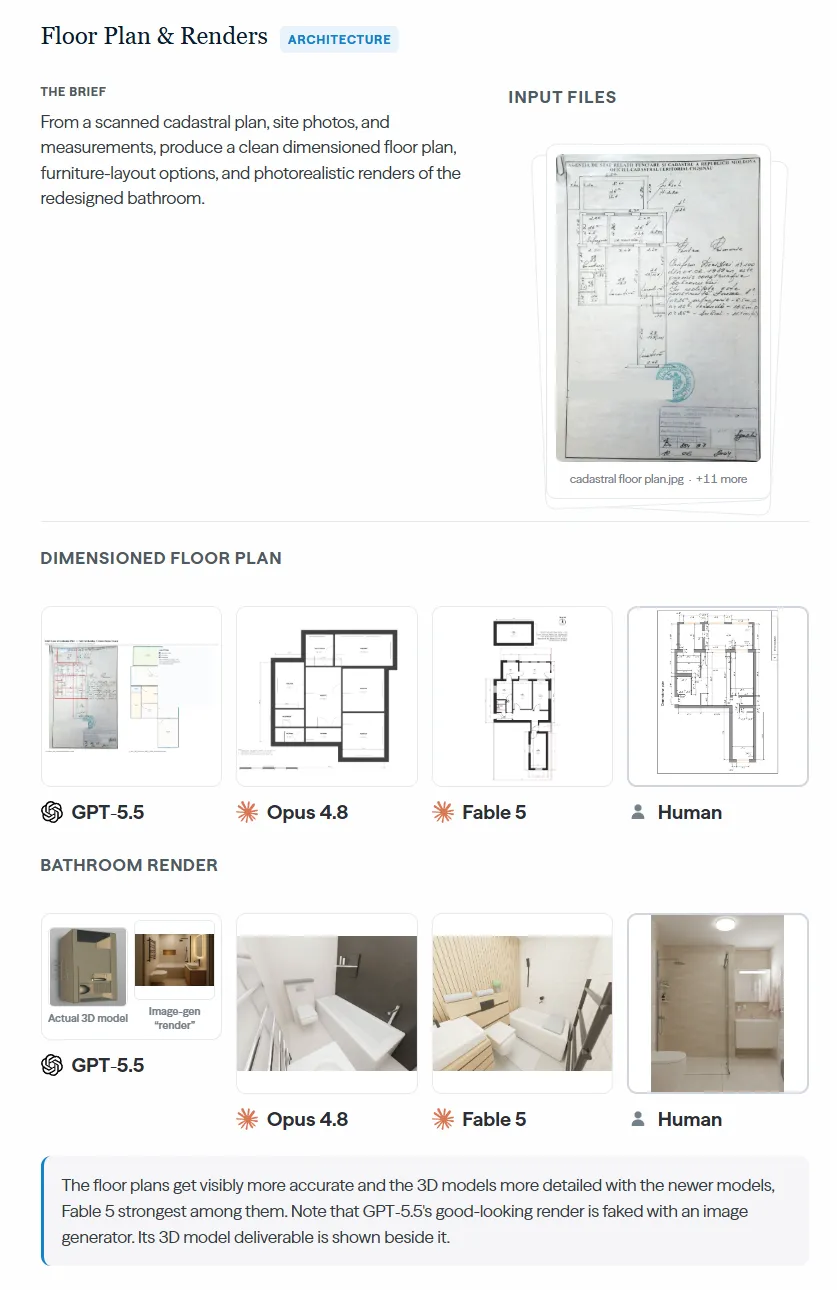
一个示例任务:创建平面图、家具布置方案和照片级逼真的浴室渲染图。图中展示的是较旧模型的结果。该帖子尚未更新。| 图片:Safe.ai
训练有素的人类专家会手动检查 AI agent 是否成功完成了一项工作。他们会在相关的专业软件中打开提交的文件,并将 AI 的输出与人类自由职业者交付的工作直接进行比较。CAIS 试图用另一个 AI 来自动化这项劳动密集型的审查工作,但迄今为止都失败了。因为 AI 审查员自己几乎无法操作这些专业软件,它们会被那些表面上看起来光鲜亮丽但技术上存在缺陷的提交内容所蒙蔽,从而对模型的评价过于宽松。