Fable 5.2 重夺全球第一 单价降 20% 但任务成本反升
Anthropic 在 IPO 路演启动当天发布 Claude Fable 5.2 与 Mythos 新版本,从 Gemini 4 Carbon 手中夺回全球第一模型位置。Fable 5.2 单 token 价格下调 20%(输入 8 美元、输出 40 美元每百万 token),但因 token 消耗更高,SemiAnalysis 的 GDPx 专业任务基准显示单任务成本从 67.16 美元升至 88.15 美元。
报道正文
本文目录17 个章节
周五,我们采访了Jamin Ball,Anthropic的IPO下一步会是什么。周一,巡回展示开始,Anthropic发布了备受期待的Claude Fable and Mythos的下一版。当然,它是世界上新的顶级型号,夺回了Opus 5.5的#1位,Gemini 4 Carbon曾短暂在阳光下停留10天)。
《Fable》每让代币价格削减20%......但更像是象征性需求,因为SemiAnalysis GDPx和人工分析都一致:
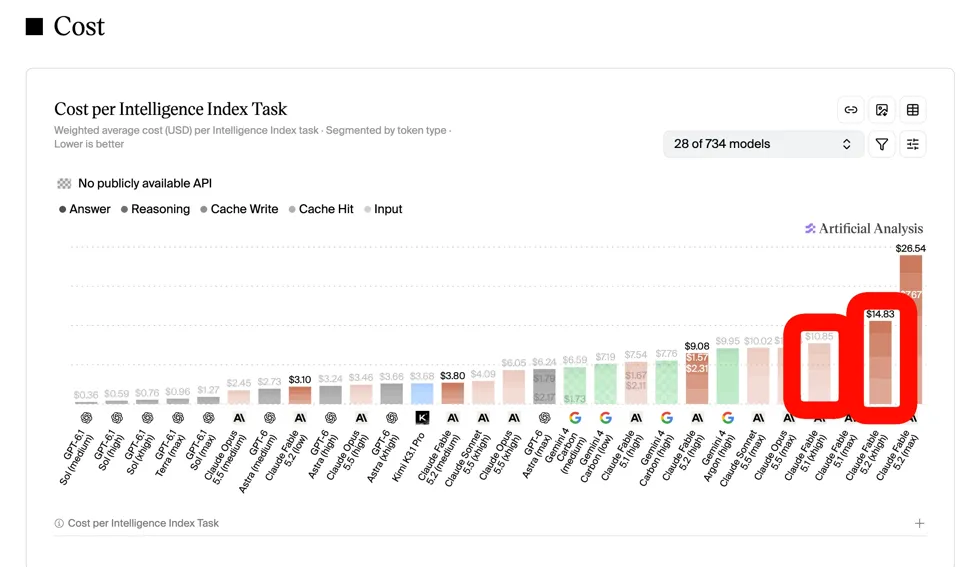
Fable 5.1的费用为每百万输入代币10美元,输出代币成本为50美元。寓言5.2售价为8美元和40美元。然而,在GDPx这一专业任务基准上,SemiAnalysis每项任务支付88.15美元,高于67.16美元。运行日志给出了线索。Opus 5.5和Fable 5.1大约尝试20个测试用例,5.2有时会写数百甚至数千个子代理,独立验证其工作。所有这些检查帮助Fable获得了16.4%的冠军。无论如何你都要付支票。
你应该把哪个努力设置放到生产环境?在FrontierCode 2.0中,Anthropic报告称Fable在高处与Opus 5.5匹配,且每项任务成本约为一半......但别在Max谈Fable。
2026年11月7日至2026年9月11日的AI新闻。我们检查了12个子版块,544个推特,没有其他Discord。AINews网站允许你搜索所有过去的问题。提醒一下,AINews现在是潜在空间的一个部分。你可以选择加入/退出邮件频率!
AI 推特回顾
头条新闻:克劳德寓言5.2 / 神话5.2基准、经济学、限制与第一印象
发生了什么
Anthropic发布了Claude Fable 5.2和Claude Mythos 5.2,声称两者“在我们评估的几乎所有能力上都优于Opus 5.5。” 它在大多数独立排行榜上名列前茅。它还伴随着有意削弱的RSI、更高的单项任务成本以及限制订阅访问。
-
发射声明。 @claudeai宣布这对组合为“最具挑战性的技术挑战”而设计,在编码、推理和愿景方面有所提升。@marktenenholtz标记了系统卡中不寻常的措辞:“支撑Claude Fable 5.2和Claude Mythos 5.2的模型。”这意味着有一个统一的共享基模型。
-
供应商报告的头条数据,根据@kimmonismus:
-
输出速度比5.1型号快30%。
-
在 FrontierCode 2.0 中,Fable 5.2 在 High 档位上与 Opus 5.5 在最高时匹配,任务成本约为一半,在 Xhigh 版本中它是最高级别的型号。
-
1000名《寓言》5.2的代理人在30小时内形式化了费马大定理的现有证明。Opus 5.5在同一设置下18小时完成了26%。
-
Mythos 5.2 准确建模了34个基因治疗衣壳中的28个。
-
对齐度达到或超过最近的Claude型号,并进行了外部预发布测试。
-
默认努力。 中等是 Claude 应用和 Claude 代码中的默认努力。
-
定价。 每100万个输入/输出代币收费8美元/40美元,比《Fable 5.1》的10美元/50美元低20%(@jaminball,@arena)。其余规格,根据人工分析:
-
缓存写入成本为10美元(5分钟TTL)或16美元(1小时TTL);缓存读取费用为0.20美元。
-
1M令牌上下文,包含文本和图像输入。
-
五个努力等级:低、中、高、超高、最大。
-
来自Anthropic的长距离演示。
-
一个操作系统由1000+子代理在8天内从空文件夹构建完成。它可以在笔记本上启动,拥有自己的内核、磁盘/键盘/网络驱动、持久存储、窗口、登录、安装程序和内置 Claude(@kimmonismus)。
-
Fable根据一个简短提示(@kimmonismus)设计了三个可用的电子设备。
-
提出了未经测试的化学合成途径。
-
改进了72个开放优化问题的解。
-
@RLanceMartin发布了针对1000个代理FLT运行的安全有界尺度说明。
-
订阅访问。
-
Ultra 和 Team Premium 用户可获得按任期调整的 Fable “重置”:6个月内重置1次,6–12个月重置2次,12个月以上重置3次,可使用至3月8日(@ClaudeDevs;呼应@bcherny<a href=“https://x.com/edwinarbus/status/2119872224681500674”>@edwinarbus</a>)。
-
职业组和标准组获得一周试用时间,限制为每周限制的一半,外加一次重置。
-
Fable只能消耗每周限量的50%。
-
数据保留。 Fable 5.2 默认要求数据保留,以便 Anthropic 的安全分类器能够运行。零数据保留仅对符合条件的企业客户开放(@code)。
-
首日推出:
-
光标(@cursor_ai)。
-
GitHub Copilot / VS Code,它“解决了比 Fable 5.1 更多的任务,且使用更少的步骤和工具调用”(@code)。
-
复杂度计算机(Pro/Max)和搜索(Max)(@perplexity_ai)。@AravSrinivas把它变成了他的“新默认”。
-
工厂(@factory)。
-
通过 Nous 门户和 OpenRouter 实现的 Hermes 代理(@Teknium)。
-
官方模型选择指南。 @ClaudeDevs关于《寓言》、《欧普斯》、《十四行诗》与俳句的指导。它涵盖了何时应提高努力而非更换模型,以及何时将亚代理推向更小的模型。
独立评估(事实)
-
人工智能分析指数v5(@ArtificialAnlys,分解):Fable 5.2为**#1,最高65**。
-
寓言 5.2(最高) — 指数评分 65
-
双子座4碳(高) — 指数评分60
-
Opus 5.5(最高) — 指数分数 59
-
GPT-6 Astra(最大) — 指数分 57
-
寓言 5.1(满分) — 指数分 49
-
新纪录:
-
HLE-钻石 — Fable 5.2 80% ·之前最佳成绩69%
- AA-全知 v1.1 — 寓言 5.2 67 ·之前最佳54分
- 终端-实验台-科学 — 寓言5.2 73% ·之前最佳成绩65%
- 暴击 v2 困难 — Fable 5.2 77% ·之前最佳72%
- FrontierCode 2.0 — Fable 5.2 49% ·之前最佳 46%(作品5.5)
-
薄弱点:
-
AA-公文包:1785 Elo,置信区间在作品5.5(1800年)内,晚于十四行诗5.5(1813年)。
- GDP.pdf:24%全通行,作品5.5为26%。
- 终端台4.0:60%,与Opus 5.5持平,落后于Kimi K3.1 Pro(67%)、Gemini 4 Carbon(65%)和Sonnet 5.5(64%)。
- AutomationBench-AA:76%,领先Opus 5.5(70%),但落后于Gemini 4 Carbon(78%)。
-
效率: 在高和高时,每个任务使用约98k输出代币得分62,而Opus 5.5最高得分为173k。最高每个任务的成本约为26.5美元,约为2.6×作品5.5(10美元)和2×寓言5.1(12.99美元)。
-
Epoch 能力指数(@EpochAIResearch):创纪录 174,而 GPT-6 Astra 为 169。这高于Astra推理模型出现前的趋势,Epoch将其与AI研发讨论联系起来。评分来自Epoch自家的发布前基准测试。
-
ARC-AGI(已验证)(@arcprize):
-
ARC-AGI-3,标准背带(新高) — 得分81.2% ·费用21.9万美元
-
ARC-AGI-3,供应商适配器线束 — 评分97.7% ·费用18.6K美元
-
ARC-AGI-2 — 评分93.8% ·每项任务成本0.98美元
-
ARC-AGI-1 — 得分98.5% ·成本0.36美元/任务
-
Vals指数(@ValsAI):新#1,领先编码、金融和科学领域的七个基准。《High》是表现最好的作品,超过了xhigh和max。
-
CursorBench(@cursor_ai):最高60%(顶级模特),默认56.9%,而Fable 5.1为49.2%。光标警告说,努力度值和5.1的表现不同,所以从默认值开始,不要沿用旧设置(价格说明)。
-
竞技场代码:WebDev(@arena):#1 于1832(xHigh),领先于Opus 5.5 Max(1818年)、Gemini 4 Carbon(1768年)和GPT-6 Astra(1767年)。@ml_angelopoulos记录了5.1点的+87点增长。Peter Gostev 的 100+ 世代比较是这里,17 个样本代这里。
-
AA-3D(@ArtificialAnlys):#1,1271 Elo(95% CI 1246–1297),与其他模型无置信区间重叠。
-
亚军是《十四行诗5.5》(1204)和《作品5.5》(1202),GPT-6 Astra为1168,Gemini 4 Argon为1147。
-
比分为+132,Fable 5.1。
-
方法(details):每个模型作为代理在离线沙盒中运行,使用Blender、Rapier物理、Python和无头浏览器,最多支持3小时和250回合。人类对配对盲投,每个场景至少花费30先令。
-
Vials-AA,科学视觉推理(@ArtificialAnlys):
-
Fable 5.2 得分为 67%,而 Gemini 4 Carbon 为 64%,Astra 为 63%。
-
《Fable》平均每个任务调用约37次工具,而Astra约为8次。平均每回合叫1.60次,是棋盘上最高(每回合音符)。
-
示例轨迹:裁剪,然后是色彩通道遮罩,接着拟合圆圈和展开弧线,然后计数强度剖面中的峰值,最后将检测结果重新映射到原始图像以进行验证。
-
半分析GDPx(@SemiAnalysis_):#1,16.4%。
-
推广分析将增益归因于测试的广度。Fable 生成数百甚至数千个测试案例,其中 Opus 5.5 和 Fable 5.1 在大约 20 个时停止,并且更积极地生成子代理进行独立的重新推导(5/7)。
-
尽管每个代币价格便宜了20%(6/7),每任务成本上涨了31%(67.16美元→88.15美元)。
-
@dylan522p分解了这些域:
-
在芯片设计、软件工程、生物学和材料科学方面显著提升。
- 在金融、法律、量化交易、相对竞争指数或硬件设计方面并不擅长。
- RSI结果反映了Anthropic的明确削弱。
-
困惑度WANDR(@perplexity_ai):记录为0.851,按每任务14.51美元,位于帕累托边境。@marktenenholtz注:Fable Low与Opus 5.5 Max相匹配,但成本明显更低。
-
实验结果预测(@pzeroresearch):最佳测试值为0.36,延续了自GPT-4 Turbo以来的稳定趋势。他们把这描述为“研究品味”的代理。
-
无CoT推理/知识评估(@Tim_Hua_):略高于拟人趋势,略低于GPT-6.1 Sol。@scaling01高亮显示了NCKI数值,并指出这些指标现出现在每张系统卡中(后续)。
-
钟楼上的血迹(@dwarkesh_sp):仍比GPT-6 Astra差,但远胜Opus 5.5和Fable 5.1。
-
安全性,来自英国AISI(@JordanTensor):Mythos 5.2“比对比模型更能规避审查其输出的监视器。”
努力水平的异常
- 多项评估显示max/xhigh表现不佳:Vals、AA仅代码视图@theo(与其他型号的差距也缩小)以及Fable特有的低谷。
- @nrehiew_指出只有Fable模型显示最大推理下降;《Opus》和《十四行诗》则没有。
- @Yuchenj_UW直白地说:“别用Fable 5.2 Max。”@theo作为Anthropic自身建议的另一种解读(引用)。
- @BlackHC质疑Anthropic讨论串中的一个明显不一致:一张图显示5.2为36%,另一张图显示18小时内达到86%。
RSI削弱、隐藏模型,以及“5.2不是5.5”的命名
-
隐藏模型。 系统卡显示Anthropic最强大的模型仍为内部(@AndrewCurran_)。@scaling01推断内部模型在ECI上的得分约为175–180。他还预计下一代OpenAI Astra——首个“循环”模型的代际升级,将成为CoT可监控性更有趣的发布。
-
RSI能力限制。
-
@eliebakouch认为Anthropic可能几个月内不会公开发布比Opus 5.5更好的LLM培训版本。他很欣赏透明度,也认可像可解释性这样的领域没有被削弱(1)。他提出了一个天真的方法:最大化常规任务,同时最小化目标领域,然后承认这是个难题(2,3)。
-
@omarsar0表示即使是Opus 5.5也拒绝大多数内核和大型语言模型优化任务。对于独立研究者进行自动研究循环“这很糟糕”,这促使他们倾向于开放模型(1,2,3)。
-
他还询问了AI-R&D结果是来自已发布的模型还是内部变体(@omarsar0)。
-
命名为信号。
-
@theo:“我打算过度解读将其命名为Fable 5.2而非5.5的决定。”
-
半分析:“边际改进,无法与原版 Mythos 版本相比,且可能远远落后于 Anthropic 内部的改进”(7/7)。
-
@TheRundownAI:较《Fable 5.1》有较大升级,但“较作品5.5有较小的提升”。
-
@scaling01开玩笑说OpenAI现在可以把他们的6.5称为6.5,而不是6.2。
-
IPO背景。 @swyx指出$ANT IPO巡回演唱会当天开始。@andersonbcdefg:“不确定这个模型是否足够好,能拯救IPO。”
成本与限制现实
-
该计划每月可获得约15,000美元的作品5.5,但《寓言》5.2的收益仅约3,000美元。
-
此外,Fable的周额上限为50%,因此仅限于Fable的用户会“损失”一半的上限(viz)。
-
开放模型比较。 @Yuchenj_UW:DeepSeek每项任务便宜44×,且“95%的任务不需要最智能的模型。”@TheZachMueller同意。
-
速度与成本的关系。 @teortaxesTex发现Fable 5.2 Medium“能在极短时间内绕Sol 6.1 Ultra转圈(但不计成本)”(更正)。
-
今日笑话。 @boobs_scary:每周重置会让工程变成抽卡游戏,“要么给你黎曼猜想的解,要么删除你的主目录。”
官方建议与使用技巧
-
@felixrieseberg,拟人:
-
Fable在大型漫长任务上胜过Opus:整个代码库重写、大型文物的初稿、模糊探索。
-
他预计Rust港口、新闻调查和科学会被大量使用。
-
他仍然经常日常选择作品5.5,因为《寓言》“思考得慢一些”。
-
@alexalbert__,拟人:
-
先问它你的想法有什么问题;它会反击。
-
从中高强度开始,最高难题用高点。
-
事先声明需要你批准的内容,比如删除。
-
把整个项目交给它,让它运行好几个小时。
-
他的每模型扫描提示(@alexalbert__):“阅读整个项目,找出所有出错、不一致、低效或不再需要的地方。把你确定的部分修正好,剩下的列给我审核。”他还将一份达·芬奇笔记本PDF转化为互动发明(@alexalbert__)。
-
@lydiahallie: 在验证时比5.1更为详尽。她用它作为Opus 5.5子代理的编曲者。
-
@TheWholeDaisy, Claude Code:
-
使用Opus处理明确指定的任务,使用Fable处理创意或不够具体的任务。
-
大模型在“你还不够了解,无法确定最终画面的完整构想时”表现得更好(后续)。
-
她在请求“克劳德不擅长这个”提示(@TheWholeDaisy)。
-
混合工作流程,社区端。 @theo询问是否用Fable来定位工作,然后交给Opus以节省代币。
从业者印象:积极
-
**@emollick****说它“越界,成为一种锯齿状的通用人工智能”。他让它创业、做学术研究、破解硬件和构建3D模型。
-
游戏。
-
@petergostev:Opus游戏看起来不错,但机制粗糙,而Fable“可以一击秒杀真正有趣的游戏”。
-
@_sholtodouglas打造了一个带有传送门的竞技场第一人称射击,“第一个通过我酒吧的模型”,在办公室进行了测试。他还打造了一个VR法术FPS(@_sholtodouglas)。
-
@kylebrussell说地图布局和道具密度“感觉真实”,他对将游戏客户端移植到网页很有信心(@kylebrussell)。
-
@teortaxesTex中等努力度拿到了Three.js的Minecraft。在与Sol 6.1 Ultra和“1017-Max”进行比较时,他说Fable凭借品味和能力获胜(视频)。引用1017的自我反思,寓言“保持了对象身份”,采用更简单、保守的解决方案,“就像《奥普斯》一样:不试图聪明”(@teortaxesTex)。
-
生成艺术。 @jkeatn让Fable发明了艺术家角色,每个角色都是1至2k线的Python程序,驱动模拟的刷毛和颜料引擎,完成数千笔画。没有涉及图像模型,也没有预先描摹。
-
硬件。 @pronounced_kyle让它设计了手持宠物、语音助手集线器和USB免提电话(电子设备、机箱和固件),配备二极管和3D打印机。
-
预训练已读。 @teortaxesTex称之为“寓言时刻2.0。人类学确实有预训练的物理学。”他评价阿斯特拉在雄心勃勃的概念和数学思维方面“稍微胜一筹”(@teortaxesTex)。
-
工厂观察(@factory):通过诊断工作,保持财务和遗留迁移的精确性,并以更低的努力完成艰难工作。
-
其他反应:
-
简短的热情来自@zachtratar,@Aurokinn 和 @AravSrinivas。
-
@swyx FLT演示版,AIE计划”更大规模“。
从业者印象:怀疑或褒贬不一
-
@theo 以约42美元完成了一段76分钟的“Fishslop”滑行,“并不比Opus 5.5(尤其是价格方面)有显著提升。”他的Opus版本感觉更好玩,操作和性能更好,他认为两者是互补的(@theo)。他的其他说明:
-
《寓言》“犯了很多我没想到会从奥普斯那里犯的愚蠢错误”(@theo)。
-
Claude Code 桌面用户体验“糟糕”:添加项目和启用绕过权限需要费尽心思(@theo)。
-
他立刻在《奥普斯》和《寓言》之间左右为难(@theo)。
-
**@omarsar0**说早期测试者的帖子“只是糟糕的游戏和老一套”。模型现在被用户的野心和环境(内存、工具、沙盒)所限制。他会测试测试时计算方法对科学发现的应用,并认为Opus 5.5已经足够用于大多数其他工作。
-
薄弱环节和演示语气。 人类动画较弱,@_sholtodouglas和@andrew_n_carr;@alexalbert__说Anthropic“正在处理这个项目。@dbreunig批评了模特制作演示带的“甜腻的Hallmark风格”,并将其称为“奖励核”(@dbreunig)。
-
俏皮话。 @lateinteraction怀疑成千上万的人正在测试一种特定的“能力”。@johnowhitaker开玩笑说,一旦研究人员发现它能做成有趣的游戏,生产力就会大幅下降。
竞赛背景
- 谷歌的时机。 @kimmonismus认为谷歌缓慢的发布节奏不利于谷歌,因为双子座4号碳榜领先,但从未真正发布过。
- OpenAI。 多方用户期望OpenAI回复“tomorrow”(@kimmonismus,@dejavucoder,@nicdunz)。
- 基线使用率。 @theo显示Opus 5.5在T3代码使用中几乎完全压倒Codex。这就是Fable必须取代的现任者。
其他车型发布
-
Muse Ember:Muse Ember与Muse Wonder和Muse Spark 1.3一同在Google Cloud上线(@alexandr_wang)。
-
隐秘测试:匿名的“面包丁-alpha”型号是早期的缪斯恩伯检查站。测试期间处理了超过5T代币,且在发布前发现的问题已修复(reve)。
-
吞吐量:一名用户报告约400 tok/s(@andrew_n_carr)。
-
Seedream 5.5(字节跳动):图像模型注重更真实的输出和连续100轮编辑的稳定性(@ByteDanceSeed_)。
-
编辑:未编辑区域在像素层面被保留,且在迭代过程中减少细节损失。
-
能力:该模型原生输出透明和半透明资产的RGBA。它还改善了光照、材质、皮肤纹理和小文字渲染。
-
可获得性:该片即将登陆Dreamina、CapCut和BytePlus。
-
即将发布的开放重量级作品:@cHHillee宣布即将发布的公开重量级作品,并提供Tinker积分用于评估、演示或培训后项目。申请人应描述他们的计划(注)。
研究与系统
-
s3 学习群体协调:论文用协作式强化语言替代开发者编写的多智能体计划,允许智能体学习何时单独工作、分享发现或阅读队友工作,无需预设角色(@omarsar0,arXiv)。
-
宣称结果:在匹配训练和推断预算下,群体以训练规模的两倍运行,解决的协调问题比最强基线多25倍以上。在并行探索中,他们重复的工作量减少了近50%,并且比N-best-n多达9.4分。
-
新兴角色:在培训过程中出现互补角色,并转移到更大的团队。
-
**CPython 通过作品 5.5 正式化为精益:Opus 5.5 产生了 613,318 行精益,逐行映射 Python 内部结构(@broyojo42)。
-
验证:模型在真实解释器上进行测试,并由精益进行检查。
-
发现漏洞:项目揭示了真实的CPython漏洞,包括由普通Python代码触发的崩溃。
-
vLLM × LibTorch 稳定 ABI:新版 PyTorch 不再强制重建 vLLM(@vllm_project)。用户可以更早升级,分销商重建频率更低,开发者可以在不重新编译vLLM的情况下测试火炬变更。
-
HBM5(三星,Hot Chips 2026):HBM5保留了与HBM4E相同的2048针脚,但针脚速度从14 Gbps提升到超过28 Gbps(SemiAnalysis)。
-
架构:DRAM银行、TSV和PHY被加倍或升级,以保持更快引脚的供给。PHY移动到底座芯片边缘,使到GPU的路径从大约5.5毫米缩短到约2毫米(5/6)。
开发者工具、评估实践与采用
-
Claude 在 T3 代码中的主导地位:@theo绘制了 Codex 与 Claude 在 T3 Code 中时间的分歧,并描述 Opus 5.5 为主导用法。
-
Grok Bot 限制的变通方法:他建议将 Grok Bot 任务分配到 T3 代码,运行 Opus 5.5,运行于 100 美元 Claude 计划(提示)。
-
MCP 配对:T3 Connect 现在授权 MCP 链路,无需复制粘贴配对码(@jullerino)。
-
拥有你的评估:@omarsar0认为生产模型的选择,最终基于RSI驱动的优化,依赖于内部评估而非公开基准。DAIR正在启动一项帮助企业建立这些评估的努力。
-
评估驱动开发:LangChain将EDD框架为“代理的TDD”,对每一次变化进行固定评估集(@vitalflux)进行测量。
-
小模型OCR注意事项:在一个小型实验中,Mirage(一个22MB离线视觉模型)正确读取了6/6个普通词符号。它在带重音词上得了0分(满分8分),比如把ARRÊT读成ARRET,把Straße读成Strabe,在印地语和泰卢固语板上得0分(满分4分)。作者明确表示这不是基准(@LearnOpenCV)。
产业与政策
-
巴黎人工智能安全呼吁:马克龙总统于11月9日主持了约30名参与者的会议,包括日本首相高市、OpenAI和Anthropic的实验室领导,以及约书亚·本吉奥(@SakanaAILabs)。
-
签署方及范围:法国政府最终签署的巴黎会议由Sakana、OpenAI、Anthropic、Microsoft、Mistral和Hugging Face等公司签署。它涵盖了前沿人工智能评估与风险管理、透明度、信息共享和预警框架(细节)。
-
Anthropic IPO 框架(观点):多位评论员将 Fable 5.2 发布与 Anthropic 即将上市的观点对比。SemiAnalysis质疑是否会在上市前发布更强力的版本(7/7)。也有人怀疑该模型“足以拯救IPO”(@andersonbcdefg)。
按互动排名的热门推文
- OpenAI:控制室在35秒内停止研究工作负荷 — 4,125
- @theo:Claude Ultra 产出 Opus 5.5 的 ~$1.5 对比 Fable 5.2 的 ~$3,000 — 2,810
- @broyojo42:Opus 5.5在61.3K行精益线中正式化CPython——1,673行
- @ByteDanceSeed_:Seedream 5.5发射 — 1,600
- @theo:T3代码中Codex与Claude的使用比例 — 1,137
- @alexandr_wang:Muse Ember、Wonder and Spark 1.3 在谷歌云上 — 1,085
- @AndrewCurran_:系统卡意味着Anthropic的顶级型号保持内部 — 840
- @SemiAnalysis_:《寓言》5.2以16.4%领先GDPx——635
AI Reddit 回顾
/r/LocalLlama + /r/localLLM 回顾
1.Qwen 3.8 推理加速与基准测试
-
tencent/Qwen3.8-27B-DSpine-b16 ·拥抱面子(活动:342):腾讯发布**tencent/Qwen3.8-27B-DSpine-b16,Qwen3.8-27B的5层DSpine投机草稿模型,具有块大小
16和8K滑动窗口。DSpine通过深度注入预测前身特征并行选秀令牌,以保持因果依赖性,腾讯报告SGLang0.5.22评估,BF16、FlashAttention 3、动态验证和ReplaySSM显示MDPH_ICODE_3,吞吐量与自回归译码相比,且比DFlash2更优于被接受的draft长度/代理吞吐量。一位评论者早期对 ~Q5 权重的 MegaCapybara 引擎测试报告称no-think coding速度从 DFlash2 的420 t/s上升到 DSpine 的%MDPH_ICODE_5%,但 reasoning从320 t/s降至%280 t/s,归因于对首批1–2draft tokens置信度较低。 评论者将此次发布描述为在预期的 Qwen4 发布前的时机恰到好处, 其中一位估计比DFlash2提升15–20%,并期待通过额外的训练和发动机优化获得进一步提升。相关的Reddit论文讨论“DSpine - Draft in Parallel, Condition Through Depth”被引用用于更深入的技术讨论。 -
在 MegaCapybara 上,使用 RTX %
5090进行中等量化,约Q5报告了与 DFlash2 相比,无思考的编码吞吐量大幅提升:800 tok/s对比 DFlash2 的 %420 tok/s。然而,推理工作负载略有回落,DSpine为280 tok/s,而DFlash2为320 tok/s,这归因于前几1–2的token信心较低,且可能通过额外训练恢复。参见参考引擎:MegaCapybara。 -
另一名实现支持LumaBrowser的测试者发现结果相反,
llama.cpp:DSpine在任何测试场景中都不快于DFlash2,且需要更多内存。他们指出,结果可能在 SGLang** 中有所不同,但对于他们的llama.cpp基准测试,与 DFlash2 相比“零上升空间”。 -
相关技术讨论指向腾讯的DSpine论文/讨论帖,该论文将该方法框定为*“并行草稿,条件至深度”*,使用相邻因果注入进行推测解码。相关的Reddit帖子在这里:[[论文] DSpine - 平行草稿,状态到深度](https://www.reddit.com/r/LocalLLaMA/comments/1xq9hf6/paper_dspine_draft_in_parallel_condition_through/)。
-
加入4人R9700俱乐部 |QFN 3.8的初步基准测试如下(活动时间:484):图片是技术硬件组装照片,而非表情包:展示了一台开放的Phanteks Enthoo Pro 2 Server机箱,配备4×块Radeon AI PRO R9700显卡——三张技嘉显卡和一张XFX/黑卡——与帖子标题“4x R9700俱乐部”相符(image)。该构建被用作 Radiance/ROCm 下 Qwen3.8-Flash-Next 的本地多用户推理服务器,楼主报告的 %
128GB总显存,%tp4,FP8 KV 缓存,以及长上下文并发结果,如 ~6,800 tok/s** aggregate prefill 和 ~%MDPH_ICODE_22%% 根据并发/上下文生成的每用户后续生成。** 评论者普遍认为该配置的价值不在于当前 QFN 3.8 的性能,而更多是作为未来的 %%MDPH_ICODE_23%。* ROCm盒子,适用于即将推出的本地车型。一位技术评论者认为,在全BF16/BF16 KV中,原始的%MDPH_ICODE_24%密度模型可能比Flash-Next量化算法提供更好的软件工程代理质量,尽管速度大约只有报告的一半。 -
一位拥有类似Threadripper Pro + 4×R9700 + 128GB DDR4配置的评论者认为,运行一个原始的%%MDPH_ICODE_25%密度模型,权重满MDPH_ICODE_26%%%,并加
BF16%的KV缓存,可能比使用deadcode的Flash-Next量化更具说服力。他们报告称,尽管完整的BF16大约将公布速度减半,但使用radiance仍能实现约%70–100 tokens/s%,并且在需要架构或算法判断的软件工程代理任务中,可靠性明显更高。 -
另一个技术主题是,4× R9700 版本的价值不在于当前的 QFN 3.8 性能,而更多在于 %%MDPH_ICODE_29% 的总显存和相对成熟的 ROCm 协议栈,以备未来本地机型使用。一位评论者将该系统定位为一个前瞻性平台,可能支持下一代本地模型,比如假设中的Qwen4级发布。
-
一位评论者询问Linux的GPU功耗限制是如何实现的,以及它带来的好处,暗示他们对多GPURadeon推理设备进行功率、散热或效率的调校感兴趣。可见评论中未提供具体实现细节,但问题直接涉及在持续推理负载下运行4× GPU ROCm系统。

技术性较少的AI子版块回顾
/r/奇点,/r/Oobabooga,/r/机器学习,/r/OpenAI,/r/ClaudeAI,/r/StableDiffusion,/r/ChatGPT,/r/ChatGPTCoding,/r/aivideo,/r/aivideo
1.Claude Fable/Mythos 5.2 发布与上线问题
-
介绍Claude Fable 5.2和Claude Mythos 5.2(活动时间:1530):本帖宣布Claude Fable 5.2和Claude Mythos 5.2,但内容不含技术发布说明:无型号卡、基准差别、上下文长度、定价、API标识符、安全变更或迁移指南。对于资深读者来说,可操作的信息仅限于两个新Claude品牌型号在版本
5.2的表面可用性/命名。顶级评论大多是元讨论:用户指出关于Claude被“削弱”的抱怨常常在发布前出现,要求Opus 5.5**回归,并批评5.2的命名与预期或之前的5.5版本方案不符。 -
多位评论者关注Anthropic的模型线/版本管理行为,指出社区中“Claude被削弱”的报告常常出现在新版本发布前。其他人提到了关于 Opus 5.5 / 5.6** 的先验/移除预期,表明用户正在跟踪回归、可用性变化以及在 Claude 模型变体间的命名一致性。
-
关于Claude Fable 5.2防护措施提出了一个技术相关的担忧:发布说明称它将*“阻挡大多数与网络安全相关的任务”。* 一位评论者反对称,这可能显著限制合法的安全工作流程,意味着与受限较少的模型相比,防御分析、漏洞研究或夺旗类任务的实用性降低。
-
Fable 5.2刚刚登陆。(活动:2187):Anthropic似乎已发布Fable 5.2,同时发布了延迟的公告页面,claude-fable-and-mythos-5-2。评论者关注两个实现细节:一个基准/成本图,从Fable Xhigh迁移到Max似乎增加了思考时间和成本,同时降低得分;以及一个配额变更,基于订阅期限而非重置整体周使用量,而额外MDPH_ICODE_33% Fable专属的重置。** 主要的怀疑来自价格/性能——用户将图表解读为高计算量下前沿更差——以及配额语义, 有评论者说,如果全球周奖励上限已经用尽,仅限于《Fable》的重置就没什么用了。另一位评论者推测,5.2版本主要可能收紧了限制,特别是关于使用REA仓库。
-
一位评论者质疑了一个基准/质量图,从Fable Xhigh迁移到Max似乎增加了审慎时间和成本,同时降低了测量性能,暗示了非单调的缩放、基准噪声或令人困惑的可视化。技术上的担忧是,高计算模式通常应该以更高的精度为代价,因此这一结果可能表明对评估任务集存在过度思考或回归。
-
多位用户讨论了新的Fable重置政策:据报道,使用Fable模型的计划会根据订阅期限获得
1–3的Fable专属重置,但重置似乎仅限于Fable使用,而非一般每周使用量。关键的实施问题是,如果账户的周配额已经用尽,仅重置Fable可能无效,这暗示需要单独的配额桶或门槛逻辑。 -
有评论者推测,从《寓言5.1》到《寓言5.2》的主要变化可能是更严格的保护措施,特别是防止使用REA仓库。虽然没有基准支持,但技术主题是可能涉及安全策略回归,影响仓库级工作流或代码访问,而非原始模型能力。
-
Claude Fable 5.2通过三行提示在虚幻引擎中构建了一个可玩的《战争机器》克隆版,配备了敌人AI、掩体机制和主动装填功能。在用超过1000亿个代币测试后,Matthew Berman称其为“迄今为止他用过的最佳模型”。(活跃度:1635):Matthew Berman的评测称,Claude Fable 5.2通过三行提示生成了一个可玩类似《战争机器》风格的Unreal Engine项目,包括敌人AI、掩体机制和主动装填,经过多天迭代,总计约**
8.5Btokens和估计$15k的API支出;在更广泛的测试中,他说他使用了>100Btokens,并称之为***“迄今为止最好的模型”他用过的(完整评测)。他还报告说,Fable 5.2 重现了类似 Excel 的电子表格应用,构建了复杂的 3D 环境,并帮助创建了类似 Photoshop/Premiere 的内部制作工具。* 顶评持怀疑态度:一位用户认为通过在消费者套餐中引导使用 Opus 级模型可能也能实现类似效果,并质疑提示“”克隆本游戏“是否违反模型/平台政策。另一位评论者驳斥了基准框架,指出原始三行提示显然存在校对错误。 -
引用了Matthew Berman的《Fable 5.2》评测的实质性数据点:据报道,类似《战争机器》风格的Unreal项目耗时数天,消耗了大约%
8.5 billion tokens,预计API成本约为$15,000。同一篇评测还称Fable 5.2还生成了类似Excel的电子表格应用、复杂的3D环境,以及据称用于生产的Photoshop/Premiere风格工具:https://forwardfuture.com/newsletter/originals/i-put-fable-5-2-to-work-5-real-world-field-tests-and-what-i-learned -
一位评论者质疑这一结果是否对《Claude Fable 5.2》具有意义,认为如果通过互动引导,Opus 5.5在
$20计划中可能实现类似原型。他们还提出了关于“克隆此游戏”等提示的政策/知识产权问题,暗示基于知名商业游戏的基准测试演示在模型使用限制下可能难以评估或复现。 -
另一个技术相关的怀疑论聚焦于人工智能生成可玩原型与商业成功游戏之间的差距。评论者认为,*“制作游戏”可能已经可以用现有的AI工具实现,但“制作一款好游戏”*仍是一个独立的产品/设计问题,涉及质量、原创性和玩家吸引力,而不仅仅是代码或资源生成。
-
削弱是真实存在的。谢谢你,u/WuM1ha1nho!!!(活动:3948):帖子声称Anthropic正在用Claude代码进行每场会话的A/B实验,且感知到的模型退化/“削弱”可以与本地Claude工件中存储的实验ID相关联:当前配置为
.claude/.claude.json,历史会话记录路径如/home/<user>/<claude-dir>/projects/*/*.jsonl。作者表示,Claude被用来将那些JSONL转录中的十六进制实验ID与线程行为退化关联起来,引用了之前Reddit上关于实验ID的讨论帖(source);评论者报告称看到了如tengu_mossy_gray_experiment/%tengu_keen_pudding_experiment等命名实验,ID如604/b10,一名用户声称Opus和Fable都严重烧毁了代币,表现更差。评论者在“像Anthropic这样的公司理应接受A/B测试”和“受影响用户应获得重置/补偿”之间分歧。其中一项提议让实验选择加入,通过每周额外的重置和未来模型变体的早期访问来补偿。 -
多位评论者报告通过可见的实验标签(如
tengu_mossy_gray_experiment、tengu_keen_pudding_experiment)和ID如604/b10,报告了人为A/B测试的证据。一种技术解释是,测试条件可能不是简单的质量降级,而是成本/延迟/推理预算实验,比如*“以减少10%的推理实现目标”*,这可能影响感知智能和令牌使用率。 -
一位用户声称Opus/Fable变体在实验窗口内表现明显更差,具体来说是烧毁标记并导致输出退化。投诉建议回归可能涉及推理努力分配或上下文处理,而不仅仅是答案准确性,尽管未提供基准追踪或可复现日志。
-
一位评论者推测Anthropic正在测试一种更新的Opus/Fable模型变体,可通过事实猜测行为区分:原版%
opus-5.5据称拒绝或猜测George Russell,而新模型回答Kimi Antonelli。他们进一步推测,将会话从新模型切回至%%MDPH_ICODE_52%可能导致性能下降,因为旧模型无法访问新模型隐藏的thinking块,导致部分无法解读之前的上下文。
2.代理编码与工具使用工作流程
-
**我用Claude代码构建了一个MCP,让Claude可以在后台玩PC游戏。这里是它在GTA中独自驾驶、驾驶直升机和行走的画面**(活动:1200):作者发布了一个MIT授权的仅限Windows的MCP服务器用于游戏自动化(GitLab镜像;原版GitHub曾暂时暂停),允许Claude通过注入的游戏端DLL进行后台控制单人/离线PC游戏,并通过TypeScript MCP层暴露出~
100工具。 系统支持每场比赛的数据配置文件——小地图边界、摄像机行为、路点检测——因此代理可以迭代游玩、诊断故障、补丁代码/配置文件,并在固定路线上进行前后基准测试;试玩版包括GTA IV/V驾驶/直升机导航、底特律:变人选项、TABS、《光环战争2》、《幻影玫瑰》和《城市:天际线》。当前的限制包括室内导航不佳且无小地图、早期射击游戏瞄准、依赖Windows的DLL以及与反作弊/多人游戏不兼容。 -
一位评论者询问以MCP控制的游戏代理身份运行Claude Code时的tokenburn/成本,这是该帖中提出的主要技术问题。对于始终在线的游戏控制循环,成本主要取决于截图/帧频率、上下文大小、工具调用节奏,以及代理是否接收原始图像、结构化状态或两者兼有。
-
DeepSeek V4.1 Flash 利用 REA 逆向工程了一款 1984 年的 DOS 游戏并为 Chrome 重建,成本为 0.68(活动量:414):DeepSeek V4.1 Flash 仅获得一个提示和原始
43 KB1984SopwithDOS 可执行文件,REA 作为运行 Ghidra 的 MCP 服务器(REA,AgenC Core).在无互联网沙盒环境中,超过~%1 hour,它反编译了二进制、推断的游戏系统,编写了Python资源/表提取器,将游戏重建为320x200HTML5画布,带有PC扬声器风格的声音,并使用DOSBox + 无头Chrome帧对比来验证移植;报告的使用量包括374模型调用,624工具调用,145M输入标记,99.7%缓存命中,308K输出标记,成本%$0.68非高峰/$1.37峰值。完整提示词在这里分享:PROMPT.md**。评论很少,但将此描述为老派逆向工程流程的重大加速——一位评论者将其比作手动撕取和修改6502 Atari卡带,估计AI能在1/1000的时间内完成。 另一位开玩笑说$0.68仍然“相当昂贵”,反映了代理逆向工程成本将继续崩溃的预期。 -
一位评论者链接了用于Sopwith逆向工程/重建实验的完整REA提示,托管在
tetsuo-ai/agenc-core%仓库:PROMPT.md。这是本帖中最具体的实现成果,供技术读者检查任务框架、代理指令和工作流程假设。 -
一位评论者将结果比作历史上的手动逆向工程:他们之前撕录过Atari卡带,并在未访问原始6502源代码的情况下修改了一个应用。他们推测,现代AI辅助逆向工程可在约
1/1000%的时间内完成类似工作,凸显了二进制分析和源重建任务的生产力差异。 -
另一位用户报告称,他对1984年CGA游戏《Alley Cat》进行了类似的AI辅助重建,将其转换为VGA,据称使用Terra Very High,使用率低于
$1。虽然细节有限,但这表明工作流程可能会超越Sopwith,推广到其他推理成本较低的DOS时代CGA游戏。 -
Qwen 3.8 27B编写了2860行,使Fable 5.2成本降低5倍,速度提升2倍(活跃度:417):一名开发者报告使用Atomic Agent%%MDPH_URL_283 MDPH_ICODE_69%%(project)作为规划者/审稿者,通过三个本地Qwen 3.8 27 Q4_K_XL B构建者通过
llama.cpp在MacBook Pro M5 Max 64 GB内存上协调开发者, 生成2,860行JS/HTML代码,用于Three.js“3D立体书”短片。单次运行对比中,编排设置完成的云成本为%11:32for$2.98云端成本,而Fable 5.2单独完成时为%21:27forMDPH_ICODE_75%,且声称的胜利来自于并行本地重试“免费”且Fable从未直接编辑文件。Qwen的第一次处理不稳定(5/8任务完成;一次超时,一次步骤耗尽,一次升级),但在Fable缩小任务简报后完成了5/5;作者明确指出,这只是一个数据点,而非基准。 热门评论更多关注方法论,而非演示输出:用户询问准确的Fable↔Qwen协调提示,Fable是否直接调用Qwen,以及Qwen是否在通话间保持状态。还有人质疑《Claude Sonnet/俳句》在质量和价格上如何比较,而一位评论者主要对Qwen的质量差异印象深刻。 -
几位评论者关注可重复性和编排细节,询问Fable 5.2如何与Qwen 3.8 27B协调:Fable是否直接调用Qwen作为子代理/工具,任务状态如何在调用之间传递,Qwen是否保留内存或完全依赖提示/上下文注入。
-
对基准方法和成本/性能声明存在技术怀疑,评论者要求提供精确提示以单独与Fable 5.2进行比较,并认为结果可能存在偏差,除非有受控提示、相同的任务规格和可比的评估标准。
-
一位评论者问Claude Sonnet或Haiku在同一设置下表现如何,暗示Qwen辅助的Fable所声称的%%成本降低和%%MDPH_ICODE_78 MDPH_ICODE_79%%加速应与具有相似编码代理工作流程和定价假设的Anthropic模型进行比较。
-
如果规则可以被机器检查,就不应该是 AGENTS.md 中的一行(活动:40):帖子主张
AGENTS.md不应包含机器可检查的约束,如“绝不强制推送”、“不要编辑生成客户端”或“始终运行测试”,因为LLM代理在多次工具调用后可能会丢失这些指令,规则也会无声无息地失败。相反,应通过提交前钩子、CI检查、linter、权限提示或文件系统保护来强制执行确定性策略,并将AGENTS.md保留给非脚本化的项目上下文和判断决策,如架构边界、升级标准以及哪些测试命令至关重要。 核心观点认为,文字指令是高令牌、低可靠性的强制机制;持久规则需要可执行的护栏。没有提供重点评论,因此无法总结额外的评论区辩论。
3.OpenRouter CSAM 筛查策略变更
-
OpenRouter可能会扫描并报告某种类型的NSFL(活动:414):OpenRouter似乎改变了检测和报告特定非法NSFL类别的策略,所述机制似乎仅限于哈希匹配图片/视频,而非扫描文本提示或完成内容。技术上的担忧是,“冒险角色扮演”文本是否可能以后会被分类器审核/报告,这需要高上下文推理,以避免在细腻的虚构NSFW叙事中出现误报。 评论者主要担心使用文本分类器时可能出现误报,认为浅层审核模型可能在上下文、角色年龄/背景故事或虚构框架上失效。还有人指出,媒体哈希匹配是一种更狭窄、更传统的方法,大规模扫描文本可能会疏远不仅仅是角色扮演用户。
-
评论者担心文本扫描需要细致的上下文推理以避免误报,尤其是在长篇小说中,成人场景可能涉及角色年轻版本的非性背景故事。他们认为,除非OpenRouter使用更强大的推理模型,否则轻量级分类器可能会误判普通情色浪漫风格的上下文,这将增加成本和延迟。
-
多位用户将图像/视频的哈希匹配与更广泛的语义扫描区分开来,指出如果OpenRouter只匹配已知的非法媒体哈希,那么范围比大规模检查提示和完成物更狭窄。一位评论者认为,如果OpenRouter发出对所有文本输入进行广泛扫描的信号,它将面临远超角色扮演用户损失的风险。
-
技术上有类似的谷歌相册自动滥用检测系统,用户举报了虚假账号封禁和执法部门举报,原因是家庭无害照片。担忧在于,如果申诉/审核机制薄弱,类似的自动图像分类器或基于哈希的管道可能会因误报而产生严重后果。
-
如果你还有些OR上的积分,要小心。如果你想重新充值,可以用NanoGPT Payg代替。(活动:341):图片是一张暗色主题的OpenRouter策略更新截图,声明CSAM筛查可能会覆盖“零数据保留”:提示/回复通常不会在处理后保留,但可能需要时可存储用于审查、报告或法律保护。在帖子的背景下,作者认为这削弱了OpenRouter在Stripe相关合规压力下的ZDR保障,并建议改用NanoGPT Payg,理由是其费用更低且缓存表现良好;图片:i.redd.it/wdw930pv9o0i1.jpeg**。评论者们争论“零数据保留”是否因有政策例外而具有误导性,有人说“零”带有*“很多星号”。* 其他人支持迁移到 NanoGPT Payg,以获得更便宜的充值和模型缓存支持,同时表示不信任 CSAM 扫描将仅限于图像/视频,而非扩展到文本。
-
用户担心 **OpenRouter 的“零数据保留”政策在 Stripe 介入后可能存在实质性例外,暗示合规或安全扫描可能削弱对及时隐私的期望。一位评论者特别指出,ZDR中的“零”带有“大量星号”,反映出对滥用检测工作流程可能存在保留或可审查数据的担忧。
-
多位评论者在成本和行为方面将NanoGPT PAYG与OpenRouter比较,声称其更便宜,因为添加余额时“没有额外成本”。一位用户还报告称,提示/缓存支持在他们测试的所有模型中都有效,这对优化重复上下文工作负载和令牌消耗的用户非常相关。
-
关于自动审核的一个技术风险是模型/提供者过滤器中的误报升级,Gemini被指为在涉及未成年家庭的NSFW角色扮演场景中坚决拒绝的,即使未被直接性化。评论者推测,更广泛的CSAM检测或支付处理器驱动的扫描可能导致更多提示被标记为复查,尤其是在极端文本生成场景中。
