Claude Fable 5.2 登顶生命科学视觉推理榜
Artificial Analysis 基于 Handshake AI 的 VIALS 基准构建 VIALS-AA,评测凝胶印迹、质粒图谱、系统发育树等生命科学图像的视觉推理能力。Claude Fable 5.2 以 67% 居首,领先 Gemini 4 Carbon 的 64% 与 GPT-6 Astra 的 63%。更值得关注的是其工具调用策略:Fable 平均每任务约 37 次调用并大量批处理,而 Astra 仅约 8 次,显示推理型模型正走向多步工具编排而非单次作答。
报道正文
Artificial Analysis (@ArtificialAnlys) · 2026-11-10 03
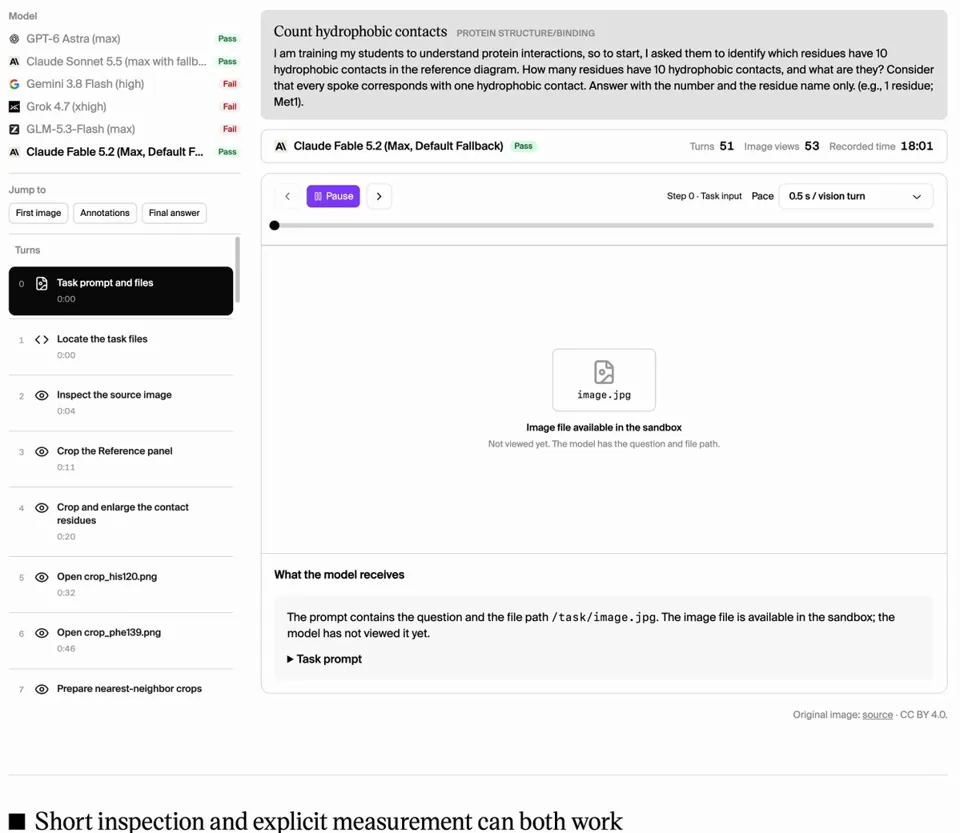
Claude Fable 5.2 在科学视觉推理基准 VIALS-AA 中领先;它发起的工具调用次数超过任何其他 Anthropic 模型,而 OpenAI 模型则相反——越智能,工具调用越少
VIALS-AA 是我们对 @joinHandshakeAI 的 VIALS 基准的实现,用于评估生命科学研究中的视觉推理能力,涵盖凝胶印迹、质粒图谱和系统发育树等图像材料。Claude Fable 5.2(max 并启用 fallback)在 VIALS-AA 上得分 67%,领先于 Gemini 4 Carbon(high)的 64% 和 GPT-6 Astra(max)的 63%。Fable 平均每个任务约进行 37 次工具调用,而 Astra 平均约 8 次,是我们测试过的所有模型中最少的。
在这个蛋白质相互作用任务的第 4 轮,Fable 创建裁剪图并请求查看它们。在第 10 轮,它通过对颜色通道做阈值处理构建颜色掩码。在第 17 轮,它为每段弧拟合一个圆,并将弧展开成直条。在第 31 轮,它把条带作为强度剖面中的峰值进行计数。在第 41 轮,它将检测到的每根辐条映射回原始图像以核验其工作。Fable 在其 51 轮中有 28 轮进行了批量调用,平均每轮 1.75 次工具调用,而 Sonnet 5.5 为 1.12 次。