Artificial Analysis 推出 VIALS-AA 科学图像推理基准
Artificial Analysis 基于 Handshake AI 的 VIALS 数据集实现了 VIALS-AA 评测,用 161 道任务各跑三次,检验模型能否读懂科学图像并依据图中证据作答。结果显示模型即便反复查看图像仍常答错,且通往正确答案的推理路径差异明显。
报道正文
本文目录29 个章节
2026年11月6日
VIALS-AA:通往科学图像推理的不同路径
VIALS-AA 是我们对 Handshake AI 的 VIALS 基准的实现,用于测试语言模型能否解读科学图像,并回答关于图像中所含证据的问题。模型通往正确答案的路径各不相同,而且即使在充分检查图像之后,也常常答错问题。
VIALS-AA 排行榜阅读方法论探索推理轨迹本文为发布文章,展示截至 2026 年 11 月 6 日的 VIALS-AA 结果。如需查看当前结果,请参阅 VIALS-AA 排行榜。
概述
VIALS-AA 测试模型能否解读科学图像,并回答关于图像中所含证据的问题。我们使用开源参考测试框架 Stirrup 对其 161 项任务各运行三次,为模型提供代码执行和图像检查工具。结果显示,模型在可靠的任务成功率以及为得出答案所付出的工作量方面均存在差异。
主要发现
- Gemini 4 Carbon(high)以 64% 的得分领先。 在 161 项任务中,有 103 项在三次重复中全部答对,比 GPT-6 Astra(max)多两项。Gemini 4 Carbon(high)、GPT-6 Luna(max)、GPT-6.1 Sol(max)、GPT-6.1 Terra(max)和 GPT-6 Astra(max)构成了所测试模型中的得分–成本帕累托前沿
- 更多轮次和视觉检查并不总能带来更好的结果。 Claude Sonnet 5.5(max,带 fallback)和 GPT-6.1 Sol(max)在 VIALS-AA 上得分相近(分别为 60% 和 59%),但 Claude Sonnet 5.5 每项任务的工具调用次数是后者的 3.6 倍
- 一致性区分了 pass@3 率相近的模型。 Kimi K3.1 Pro(max)和 GPT-6 Astra(max)各自至少一次解决了约四分之三的任务。要求三次重复全部成功则拉开了二者的得分差距:Kimi K3.1 Pro(max)为 45%,而 GPT-6 Astra(max)为 63%。我们要求三次全部成功,因为在科学工作中,运行之间会变化的结果无法依赖
- 每项任务成本相差近 99 倍。 从 GPT-6 Luna(max)的 $0.02 到 Grok 4.7(xhigh)的 $1.77 不等。GPT-6.1 Sol(max)以每项任务 $0.06 的成得到 59% 的得分,在性能相近(61%)的情况下,成本约为 Claude Opus 5.5(max,带 fallback)的三十分之一
VIALS-AA:得分
三次重复中全部答对的任务占比(pass^3)无公开可用 API{"@context":"https://schema.org","@type":"Dataset","name":"VIALS-AA: Score","creator":{"@type":"Organization","name":"Artificial Analysis","url":"https://artificialanalysis.ai"},"description":"三次重复中全部答对的任务占比(pass^3)· 由 Artificial Analysis 独立测量的评估结果","variableMeasured":[{"@type":"PropertyValue","name":"V I A L S- A A"}],"measurementTechnique":"由 Artificial Analysis 在专用硬件上独立运行的测试。","spatialCoverage":"Worldwide","keywords":["analytics","llm","AI","benchmark","model","gpt","claude"],"license":"https://artificialanalysis.ai/docs/legal/Terms-of-Use.pdf","isAccessibleForFree":true,"citation":"Artificial Analysis (2025). LLM benchmarks dataset. https://artificialanalysis.ai"}
VIALS-AA:得分与每项任务成本对比
VIALS-AA 得分 · 每项任务成本(美元)最具吸引力的象限帕累托线AnthropicDeepSeekGoogleZ AIOpenAISpaceXAIKimiXiaomiMiniMaxMistralMetaAlibaba
每项任务评估成本
成本根据输入、缓存读取、缓存写入、推理和回答的 token 价格计算,再除以任务数量。Token 用量按每个任务 3 次独立重复取平均值,并使用各模型具有代表性的缓存命中率。成本仅包含参赛模型的调用,不包含评判模型的调用。
示例轨迹:通过科学图像的不同路径
第一个任务要求模型在凝胶电泳图像中定位蛋白质斑点 22,并根据纵轴估算其分子量范围。模型采取了不同的路径:简短的视觉检查、显式测量,或借助标注和处理后的视图进行反复核对。在使用 Grok 4.7 (xhigh) 时,我们看到大量的检查和标注最终仍然得出了错误答案。
任务 1 蛋白质斑点 22 任务 2 验证 FMO 对照 任务 3 读取质粒酶切 任务 4 统计疏水接触 任务 5 寻找共同祖先
简短检查与显式测量都可以奏效
简短的视觉检查
GPT-6 Astra (max) 检查图像尺寸,打开原图,制作 4 倍放大图并打开它。随后它写出正确答案,并在六轮内完成。它没有进行像素测量或对比度调整,也没有绘制参考线,而是依靠其视觉准确性在无需额外工具使用的情况下正确作答。
- 第 1 轮
检查图像文件
total 78
drwxr-xr-x 1 root root    70 Nov  3 04:55 .
drwxr-xr-x 1 root root   100 Nov  3 07:47 ..
-rw-r--r-- 1 root root     0 Nov  3 04:57 answer.txt
-rw-r--r-- 1 root root 78963 Nov  3 04:55 image.jpg
(412, 409)
记录的工具输出摘录 2. 第 2 轮
打开原图
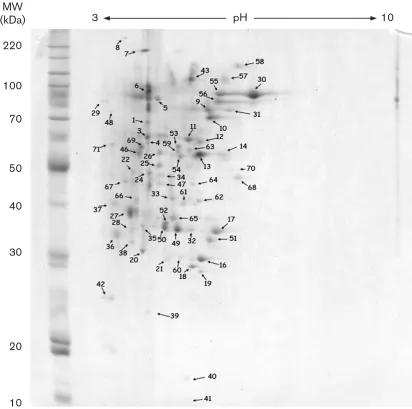
image.jpg · 412 × 409 px 3. 第 3 轮
创建 4 倍放大图
enlarged.png
1648 × 1636 px
已创建,尚未查看 4. 第 4 轮
检查放大图
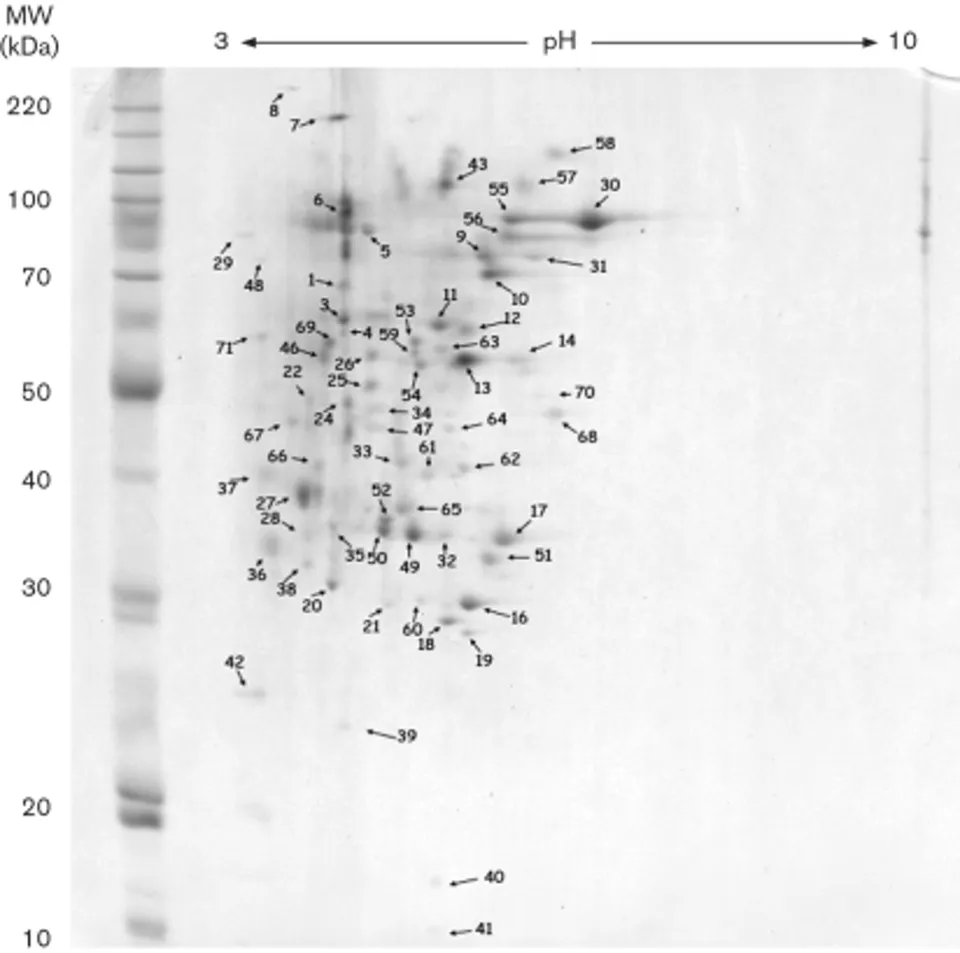
enlarged.png · 1648 × 1636 px 于第 3 轮创建 5. 第 5 轮
提交答案
40-50 kDa
通过
参考:40-50 kDa
显式测量与计算
Claude Sonnet 5.5 (max) 放大凝胶并裁剪斑点 22 周围的区域。它测量分子量标记条带,检查箭头附近的像素,绘制参考线,增强对比度,并插值计算分子量。这些显式测量将斑点的位置与分子量标记进行核对,支持了 40-50 kDa 的答案。它在 18 轮内完成。
- 第 4 轮
检查 3 倍放大图
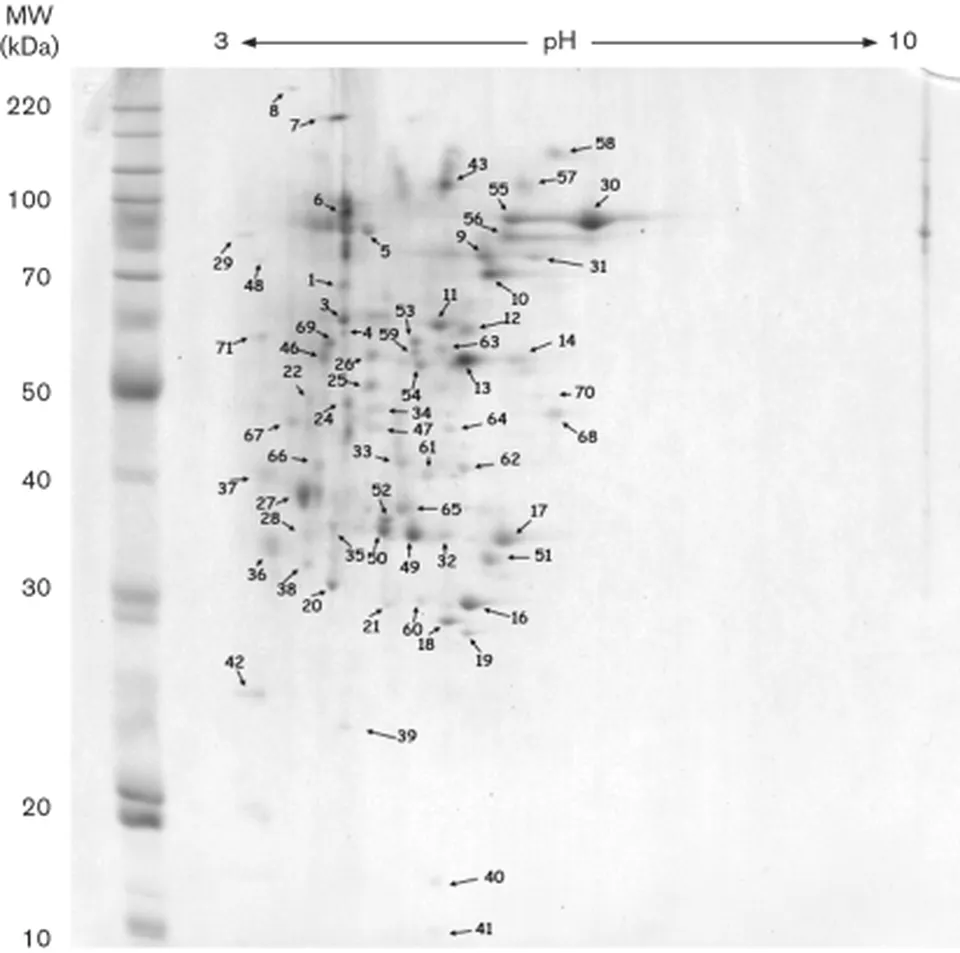
big.png · 1236 × 1227 px,创建于第 3 轮 2. 第 6 轮
检查 6 倍裁剪图
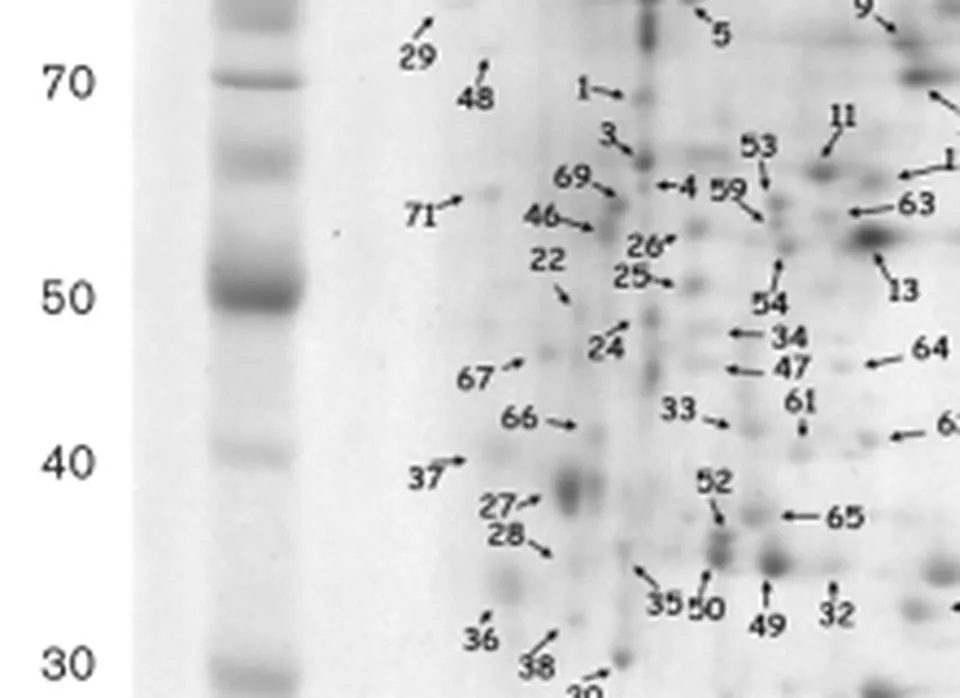
crop22.png · 1320 × 960 px,创建于第 5 轮 3. 第 15 轮
增强对比度并检查参考线
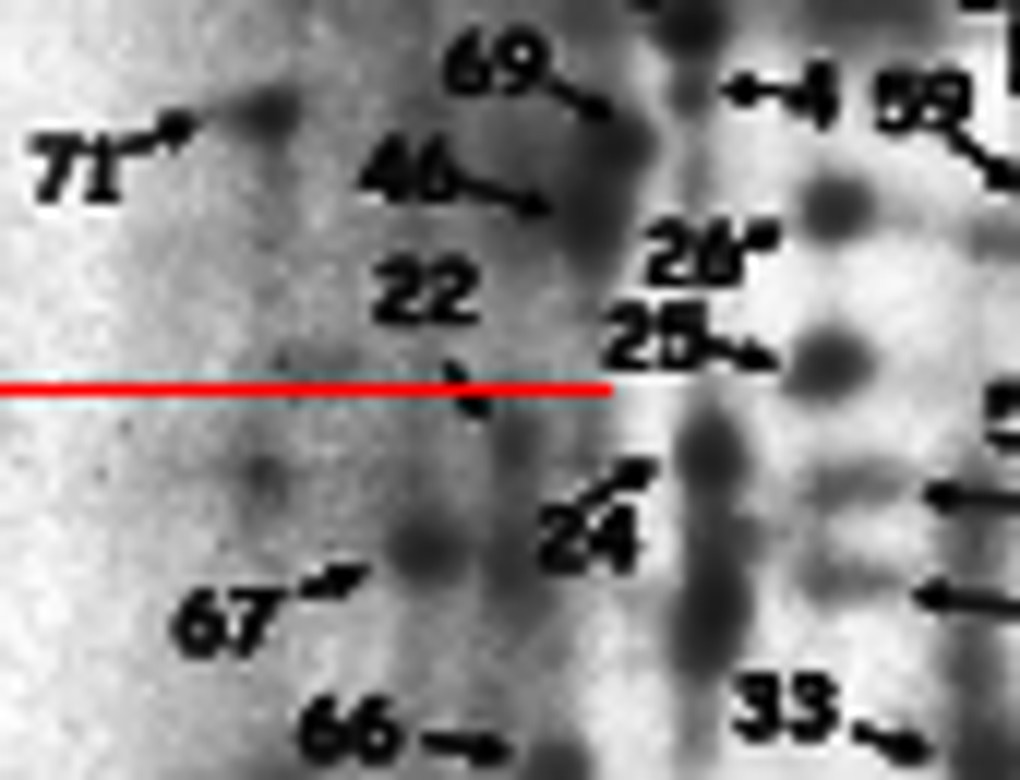
clahe22.png · 1020 × 780 px,创建于第 14 轮 4. 第 16 轮
插值计算分子量
22 number label centre     y= 159.0  MW(log-linear)= 53.0 kDa   MW(pchip)= 52.7 kDa
arrowhead tip              y= 168.5  MW(log-linear)= 49.7 kDa   MW(pchip)= 49.7 kDa
faint spot centre          y= 172.0  MW(log-linear)= 48.7 kDa   MW(pchip)= 48.6 kDa
spot lower extent          y= 174.0  MW(log-linear)= 48.1 kDa   MW(pchip)= 48.0 kDa
记录的工具输出摘录 5. 第 17 轮
提交答案
40-50 kDa
通过
参考答案:40-50 kDa
反复检查(最终导致视觉错误)
Grok 4.7(xhigh)使用网格、阈值、参考线和标注像素反复检查该区域。它用了 27 轮、查看了 20 次图像,但回答的是 50-70 kDa。在其最终标注视图中,Grok 用橙色圈出印刷的“22”,用红色圈出箭头尖端,并将尖端放在其绿色的 50 kDa 参考线上。其最终答案引用标签和引导线来论证 50-70 kDa。这表明它把范围锚定在标注上,而不是微弱的蛋白质斑点。Claude Sonnet 5.5(max)通过插值将标签(约 53 kDa)与斑点(约 48.7 kDa)区分开来,支持 40-50 kDa 的参考范围。
- 第 9 轮
检查坐标网格
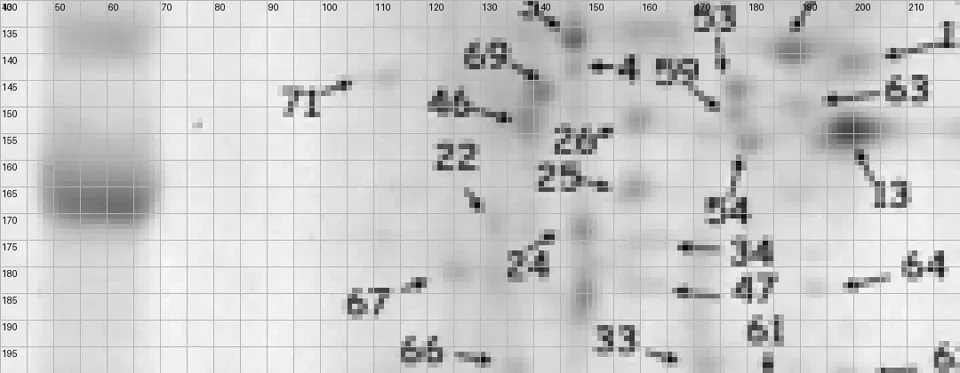
z22.png · 1080 × 420 px,创建于第 8 轮 2. 第 16 轮
检查分子量参考线
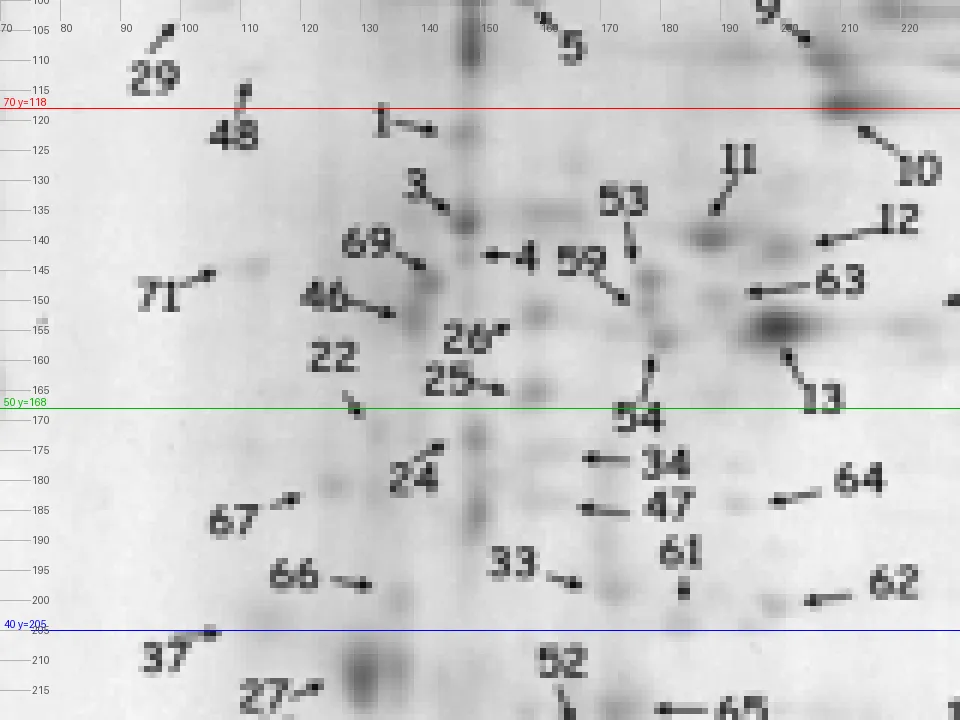
z22_lines.png · 960 × 720 px,创建于第 15 轮 3. 第 19 轮
标注单个像素
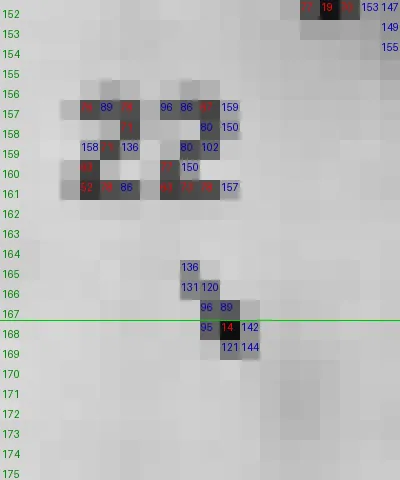
pixel22.png · 400 × 480 px,创建于第 18 轮 4. 第 25 轮
检查标签和箭头尖端
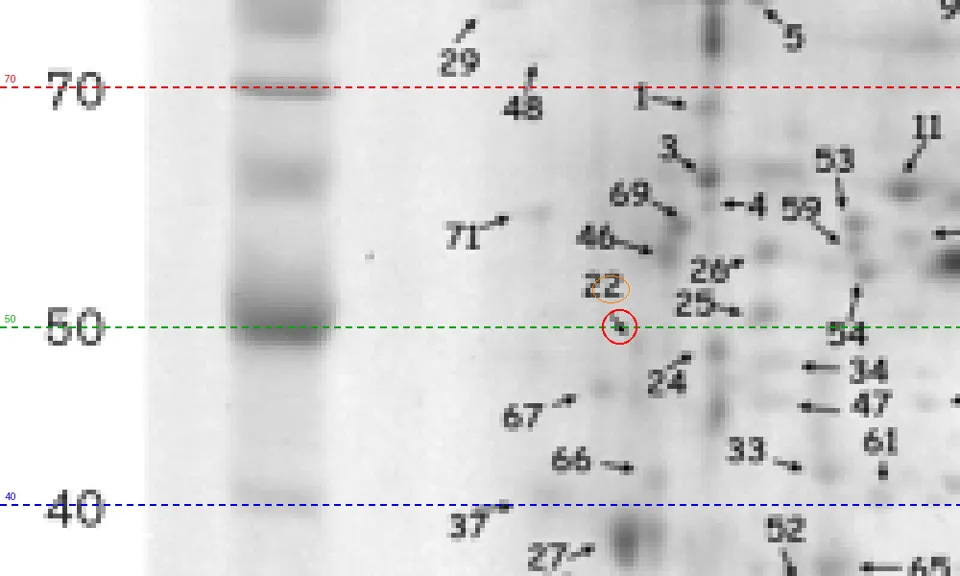
decision.png · 1000 × 600 px,在第 24 轮创建 5. 第 26 轮
提交错误区间
50-70 kDa
失败
参考:40-50 kDa
在没有原生视觉能力的情况下解读图像
具备视觉能力的模型天然适合 VIALS-AA:它们可以查看科学图表、读取其标签,并将视觉特征与问题关联起来。我们还希望测试一个没有原生视觉能力的模型会如何应对这些任务。我们给 GLM-5.3 (max) 提供了相同的图像文件和代码执行能力,让它通过工具来研究图表。
在没有原生视觉能力的情况下,模型依赖代码从图像中提取证据。在下面的 spot-22 轨迹中,GLM-5.3 (max) 将图像加载到数组中,放大并对区域进行阈值处理以进行 OCR,比较像素强度,并打印图像的坐标和文本映射。它利用这些输出来定位标签、测量分子量刻度,并选择一个候选斑点。每一轮代码都会返回另一条证据,供模型解读和修正。
这组选定的配对展示了所涉及的额外工作及其局限。GLM-5.3-Flash (max) 将代码与十次图像查看相结合,在 30 轮内完成并给出了正确区间。GLM-5.3 (max) 则用了 54 轮和 57 次代码调用,没有进行任何图像查看,最终给出了错误答案。
不同模型之间的工具使用差异巨大
我们对原始测试集中全部 19 个模型的工具调用进行了分类,覆盖 9,177 次运行。大多数调用都与视觉证据有关。38.3% 的工具调用是查看图像,而 47.3% 是准备或测量图像,包括创建裁剪图、增强视图以及从像素中提取测量值。对于 GPT-6 Astra (max) 和 GPT-6.1 Sol (max),图像测量仅占工具调用的 5–6%,而 Claude Opus 5.5 (max) 和 Claude Sonnet 5.5 (max) 则为 25–27%。
每任务调用次数 调用占比
VIALS-AA:每任务工具调用次数
每个任务的平均工具调用次数,基于三次独立重复取平均值。无公开可用的 API 图像查看 图像准备 图像测量 评论 / 无操作 其他{"@context":"https://schema.org","@type":"Dataset","name":"VIALS-AA: Tool Calls per Task","creator":{"@type":"Organization","name":"Artificial Analysis","url":"https://artificialanalysis.ai"},"description":"每个任务的平均工具调用次数,基于三次独立重复取平均值 · 由 Artificial Analysis 独立测量的评估结果","variableMeasured":[{"@type":"PropertyValue","name":"Image_viewing"},{"@type":"PropertyValue","name":"Image_preparation"},{"@type":"PropertyValue","name":"Image_measurement"},{"@type":"PropertyValue","name":"Commentary_noop"},{"@type":"PropertyValue","name":"Other"}],"measurementTechnique":"由 Artificial Analysis 在专用硬件上独立进行的测试运行。","spatialCoverage":"Worldwide","keywords":["analytics","llm","AI","benchmark","model","gpt","claude"],"license":"https://artificialanalysis.ai/docs/legal/Terms-of-Use.pdf","isAccessibleForFree":true,"citation":"Artificial Analysis (2025). LLM benchmarks dataset. https://artificialanalysis.ai"}
评估工具调用
完成或放弃任务的调用不计入工具调用次数。每个任务的值在已记录的重复中取平均值,每个模型最多有 483 次观测。每轮工具调用次数等于计入的工具调用总数除以已完成的模型轮次总数。没有记录轮次计数的重复(例如立即触发的安全拦截)会被排除。
我们如何对工具调用进行分类
| 类别 | 包含内容 |
|---|---|
| 图像查看 | 原始图像;裁剪及其他处理后的视图 |
| 图像准备 | 裁剪;缩放/调整尺寸;旋转;对比度/亮度调整;标注与辅助线;掩膜/伪彩色;ASCII 渲染 |
| 图像测量 | 对象计数;面积;条带强度;强度分布;坐标;距离;结构关系;测量图表 |
| 评论 / 无操作 | 注释;空代码;静态叙述或推理 |
| 其他 | - OCR: 从像素中提取文本和标签 - 计算: 数值、统计、符号或科学计算 - 检查/设置: 文件、尺寸、元数据、依赖项、已保存结果、辅助脚本 - 答案撰写: 最终答案文件创建、格式化、回读 - 其他/不明确: 未分类活动或证据不足 |
每次调用只归入一个主要类别,依据其主要活动确定。
图像查看来自 view_image 工具;其他活动组则对 code_exec 调用进行分类。“其他”包括文件与环境检查、答案撰写、计算、OCR 以及无法明确归类的活动。OCR 占“其他”调用的 12.4%;Gemini 3.8 Flash (high) 占 OCR 调用的 21%。
并非每次代码执行都在做分析
Gemini 3.8 Flash (high) 占该队列中被归类为 commentary/no-op 调用的 86.7%。这相当于其工具调用的 5.6%,即在其每任务 67.5 次调用中约占 3.8 次。
commentary/no-op 工具调用涵盖静态叙述、注释或打印文本,不涉及新的计算或文件分析。在 Protein spot 22 中,一次 commentary/no-op 工具调用打印了对 spot 标签的解读。代码执行工具充当了记事本:模型写出自己的解读,文本会在下一次模型请求中返回。
更智能的模型往往调用更少的工具
在 VIALS-AA 上,Artificial Analysis Intelligence Index 得分更高的模型通常进行的工具调用更少。
但相似的 VIALS-AA 得分可能来自截然不同的检查策略:Opus 和 Sonnet 进行的工具调用和图像测量明显多于 Astra 和 Sol。
Intelligence IndexVIALS-AA ScoreTool Activity
VIALS-AA:工具使用与智能水平
每个点代表一个模型,均基于相同的 161 个任务和三次独立重复Most attractive quadrant
模型解决的任务数量相近,但顶尖模型的稳定性高得多
领先的开源权重模型至少成功解决一次的任务数量与闭源前沿模型大致相当,但稳定性差得多。Kimi K3.1 Pro (max)、MiMo-V2.6-Pro 和 MiniMax-M3.1-Flash (max) 各自至少成功解决 114–119 个任务,而七个得分最高的模型(均为闭源)为 111–118 个。它们仅在 48–73 个任务上通过全部三次重复,而后者为 95–103 个。我们的核心指标 pass^3 是指在全部三次重复中都正确回答的任务占比。我们采用 pass^3,是因为科学工作中不一致的答案可能导致错误结论和高成本的后续实验。
ConsistencyAll MetricsAverage of 3pass@3 Rate
VIALS-AA:三次重复中的稳定性
通过零次、一次、两次或全部三次重复的任务占比No publicly available API0/3 Passes1/3 Passes2/3 Passes3/3 Passes
Gemini 4 Carbon (high) 在八个领域中的三个领先
Gemini 4 Carbon(high)在八个领域组中的三个领域组中领先或并列领先:质粒图谱、系统发育学和流式细胞术。它与 Gemini 4 Argon(high)并列流式细胞术领先。Claude Opus 5.5(max)在印迹法上领先,Claude Sonnet 5.5(max)在细胞计数上领先,GPT-6.1 Terra(max)在蛋白质结构/结合上领先。GPT-6 Astra(max)和 GPT-6.1 Sol(max)在分子结构上并列领先。
VIALS-AA:按领域得分
按科学领域划分,在全部三次重复中均正确回答的任务占比。颜色在每个领域内对所有测试模型进行归一化{"@context":"https://schema.org","@type":"Dataset","name":"VIALS-AA: Score by Domain","creator":{"@type":"Organization","name":"Artificial Analysis","url":"https://artificialanalysis.ai"},"description":"按科学领域划分,在全部三次重复中均正确回答的任务占比。颜色在每个领域内对所有测试模型进行归一化 · 评估结果由 Artificial Analysis 独立测量","variableMeasured":[{"@type":"PropertyValue","name":"Vials Pass All3 By Domain"}],"measurementTechnique":"由 Artificial Analysis 在专用硬件上独立运行的测试。","spatialCoverage":"Worldwide","keywords":["analytics","llm","AI","benchmark","model","gpt","claude"],"license":"https://artificialanalysis.ai/docs/legal/Terms-of-Use.pdf","isAccessibleForFree":true,"citation":"Artificial Analysis (2025). LLM benchmarks dataset. https://artificialanalysis.ai"}
每任务成本在不同模型间相差近 100 倍
每任务成本从 GPT-6 Luna(max)的 $0.02 到 Grok 4.7(xhigh)的 $1.77,差距达 99 倍。GPT-6.1 Sol(max)和 Claude Sonnet 5.5(max)分别得分 59% 和 60%,但 Sonnet 的每任务成本约为前者的 18 倍。
每任务输出 token 数从 GPT-6 Astra(max)的约 2.21k 到 MiMo-V2.6-Pro 的 94.6k,差距达 43 倍。推理占每个模型输出的大部分。Claude Sonnet 5.5(max)使用 63.5k,其中包括 54.6k 推理 token:在得分相近的情况下,其输出 token 数约为 GPT-6.1 Sol(max)的 25 倍。
每任务成本 pass@3 与成本
VIALS-AA:每任务成本
运行 VIALS-AA 的每任务平均成本(美元),根据 token 用量和模型定价计算,包含代表性缓存命中率无公开可用的 API回答推理缓存写入缓存命中输入{"@context":"https://schema.org","@type":"Dataset","name":"VIALS-AA: Cost per Task","creator":{"@type":"Organization","name":"Artificial Analysis","url":"https://artificialanalysis.ai"},"description":"运行 VIALS-AA 的每任务平均成本(美元),根据 token 用量和模型定价计算,包含代表性缓存命中率 · 由 Artificial Analysis 独立测量的评估结果","variableMeasured":[{"@type":"PropertyValue","name":"Answer"},{"@type":"PropertyValue","name":"Reasoning"},{"@type":"PropertyValue","name":"Cache Write"},{"@type":"PropertyValue","name":"Cache Hit"},{"@type":"PropertyValue","name":"Input"}],"measurementTechnique":"由 Artificial Analysis 在专用硬件上独立运行的测试。","spatialCoverage":"Worldwide","keywords":["analytics","llm","AI","benchmark","model","gpt","claude"],"license":"https://artificialanalysis.ai/docs/legal/Terms-of-Use.pdf","isAccessibleForFree":true,"citation":"Artificial Analysis (2025). LLM benchmarks dataset. https://artificialanalysis.ai"}
每任务评估成本
成本根据输入、缓存读取、缓存写入、推理和回答 token 的价格计算,再除以任务数量。Token 用量是对每个任务的 3 次独立重复取平均值,并使用每个模型的代表性缓存命中率。成本仅包含参赛模型的调用;评判模型的调用不计入。
每任务输出 Token 数与每任务输出 Token 数的得分对比
VIALS-AA:每任务输出 Token 数
每个 VIALS-AA 任务平均消耗的推理与回答 token 数无公开可用的 API回答推理{"@context":"https://schema.org","@type":"Dataset","name":"VIALS-AA: Output Tokens per Task","creator":{"@type":"Organization","name":"Artificial Analysis","url":"https://artificialanalysis.ai"},"description":"每个 VIALS-AA 任务平均消耗的推理与回答 token 数 · 由 Artificial Analysis 独立测量的评估结果","variableMeasured":[{"@type":"PropertyValue","name":"Answer"},{"@type":"PropertyValue","name":"Reasoning"}],"measurementTechnique":"由 Artificial Analysis 在专用硬件上独立运行的测试。","spatialCoverage":"Worldwide","keywords":["analytics","llm","AI","benchmark","model","gpt","claude"],"license":"https://artificialanalysis.ai/docs/legal/Terms-of-Use.pdf","isAccessibleForFree":true,"citation":"Artificial Analysis (2025). LLM benchmarks dataset. https://artificialanalysis.ai"}
每个任务的评估输出 token 数
每个任务的回答 token 与推理 token 数量,取 3 次独立重复运行的平均值。
VIALS-AA 资源
- 排行榜位于 VIALS-AA 评估页面
- 方法论页面介绍了当前的实现、评分与计分方式
- Handshake AI 的 VIALS 基准页面介绍了该数据集及原始评估
- 公开数据集位于 Hugging Face
- Stirrup 测试框架位于 GitHub