亚马逊 Bedrock 推出智能体评估工具集
亚马逊云科技在 Bedrock AgentCore 中推出智能体评估能力,统一提供内置评估器、DeepEval 与 AutoEval 三类方案,可通过 ListEvaluators API 一次性获取。文章指出,延迟与用户反馈等表层信号无法反映任务完成度、长会话话题漂移、PII 泄露与步骤遗漏等深层行为,团队应先明确成功标准与可观测的轨迹证据再选择评估器。
报道正文
本文目录7 个章节
当把智能体部署到生产环境时,最难回答的问题之一是:它是否真的在正常工作?衡量标准不在于它能否运行,而在于它能否在规模化场景下满足业务需求。许多团队会告诉你,他们其实看不清这一点。他们会抽查输出、监控延迟,并在能获取到的情况下收集用户反馈。但这些都无法告诉你:智能体是否完成了用户的任务、是否在长会话中始终保持主题相关、是否泄露了个人可识别信息(PII),或者是否悄悄跳过了它本应执行的一半步骤。
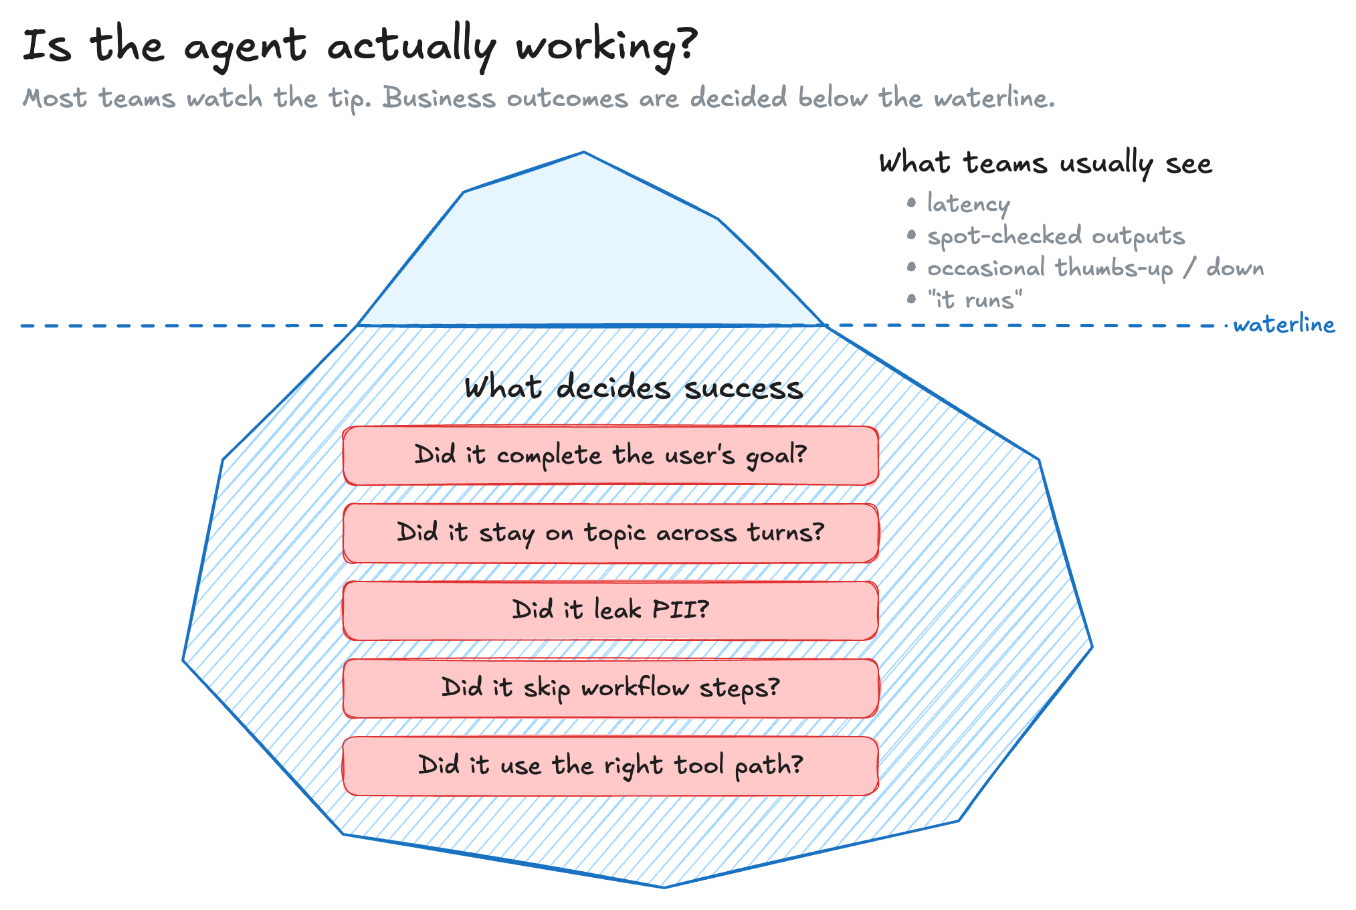
图 1:团队通常关注水面信号,但业务成果由水面之下的智能体行为决定
智能体评估可以解决这个问题。其挑战在于,某一指标上的良好得分可能掩盖另一指标上的失败。一个客服智能体可以解决每一张工单,却仍然在回复中泄露个人信息。在这种情况下,尽管完成率很高,智能体实际上是在失败。要做好评估,就需要针对每个智能体,以恰当的细节粒度来衡量真正重要的行为。
本文介绍如何在 Amazon Bedrock AgentCore 上实现这一点。我们直接使用 AgentCore Evaluations 中的 AgentCore 内置评估器,以及 DeepEval 和 AutoEval 评估器。
从业务成果出发,而不是从指标名称出发
最常见的错误是从指标列表出发,挑选那些听起来正确的名称。“有用性听起来不错,那就用它。”结果虽然能运行并产出数字,但几乎提供不了有价值的洞察。该指标只是契合了它的标签,而非契合智能体成功的真正含义。
相反,应当从以下三个步骤开始。
- 用业务语言定义成功。 对于客户支持智能体,成功可能是首次联系解决率。对于研究智能体,成功可能是产出一个完整、来源充分且完全基于检索文档的答案。对于内容审核助手,成功意味着标记出所有应当被标记的内容,且只标记这些内容。
- 将结果拆解为可观察的行为。 一个能够实现首次联系解决的客户支持智能体,通常会完成用户明确提出的目标,在问题需要澄清时保持多轮对话的连贯性,将回复保持在合规边界之内,并正确调用工单创建或订单查询等后端工具。
- 将每种行为映射到相应层级的评估器。 Trace 级指标覆盖每轮对话或每次工具调用的行为。Session 级指标覆盖只有纵观整段对话才有意义的结果。
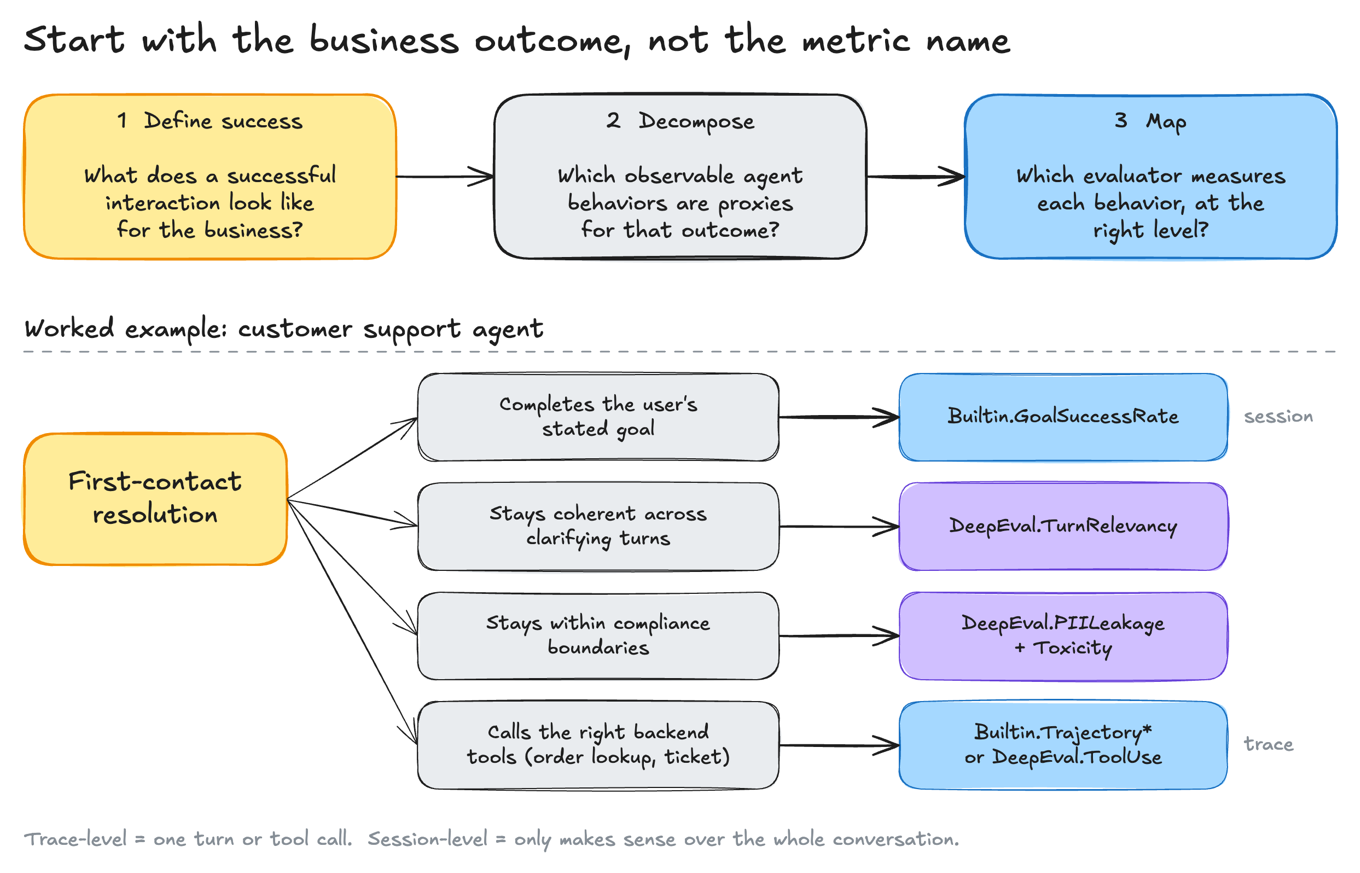
图 2:将业务结果转化为可观察行为,再转化为 trace 级或 session 级的具体评估器
这个三步流程是让评估真正有用的思维模型。本文余下部分将介绍 AgentCore 提供了哪些能力来执行这一流程。
评估器目录
AgentCore 拥有一个覆盖面广泛的评估器目录,来源有三类:
- 内置评估器由 AWS 编写并经过质量测试。你只需通过其 ID(
Builtin.GoalSuccessRate、Builtin.Helpfulness等 13 个)引用它们,其余一切由服务处理。它们经过可靠性基准测试,覆盖常见维度,因此是最直接的起点。 - 第三方托管评估器来自 DeepEval 和 AutoEval,这两个成熟的的开源评估库。在托管模式下使用它们时,AgentCore 托管代码、选择评判模型,并利用自身算力运行推理,与内置评估器完全一样。如果你的团队在开发中已经使用其中一个库,你可以在生产环境中运行相同的指标,而无需单独的评估服务。
- 自定义评估器以内置或第三方评估器为基础,因此你可以换用自己的模型,并修改提示词或评分标准。
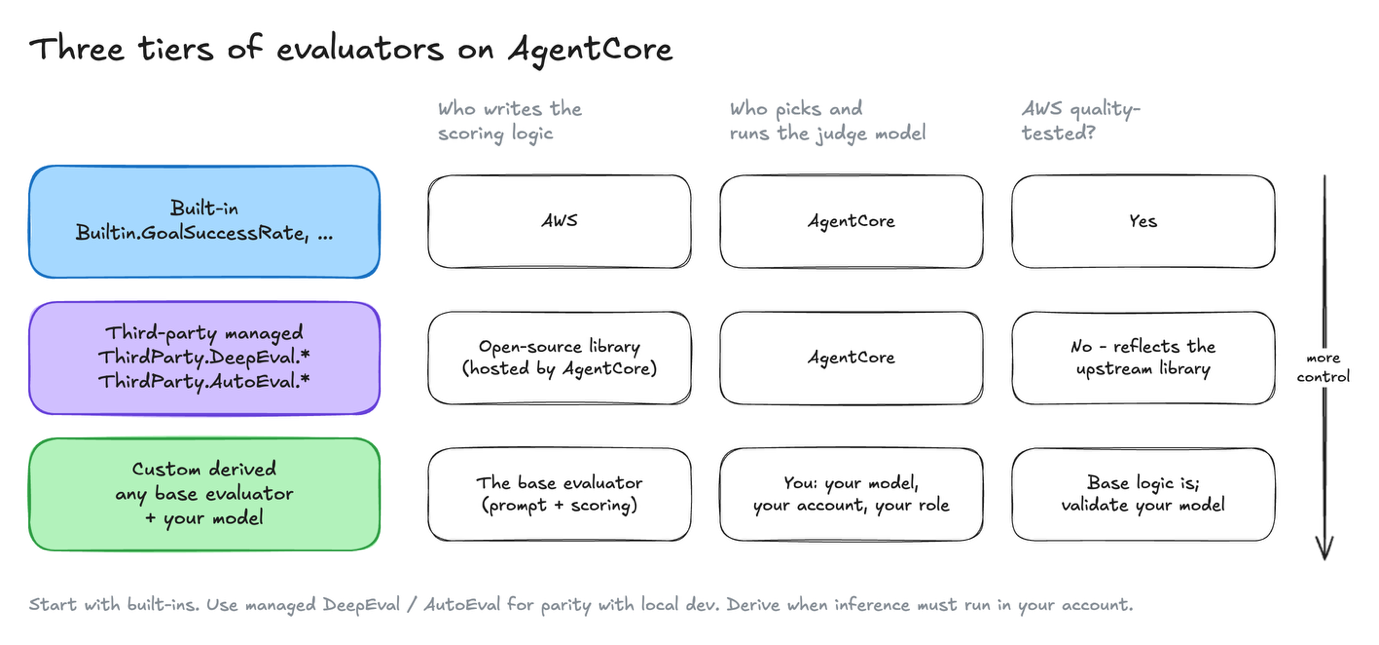
图 3:三个评估器层级以 AWS 质量保证换取对运行推理的模型和账户的更大控制权
创建后,自定义派生评估器的使用方式与其他评估器完全相同。
评估器全景
AgentCore 自带丰富的评估器目录,因此你很少需要从零开始。在编写自定义评判器之前,请先检查是否已有评估器能衡量你关心的行为。下图展示了完整的全景。
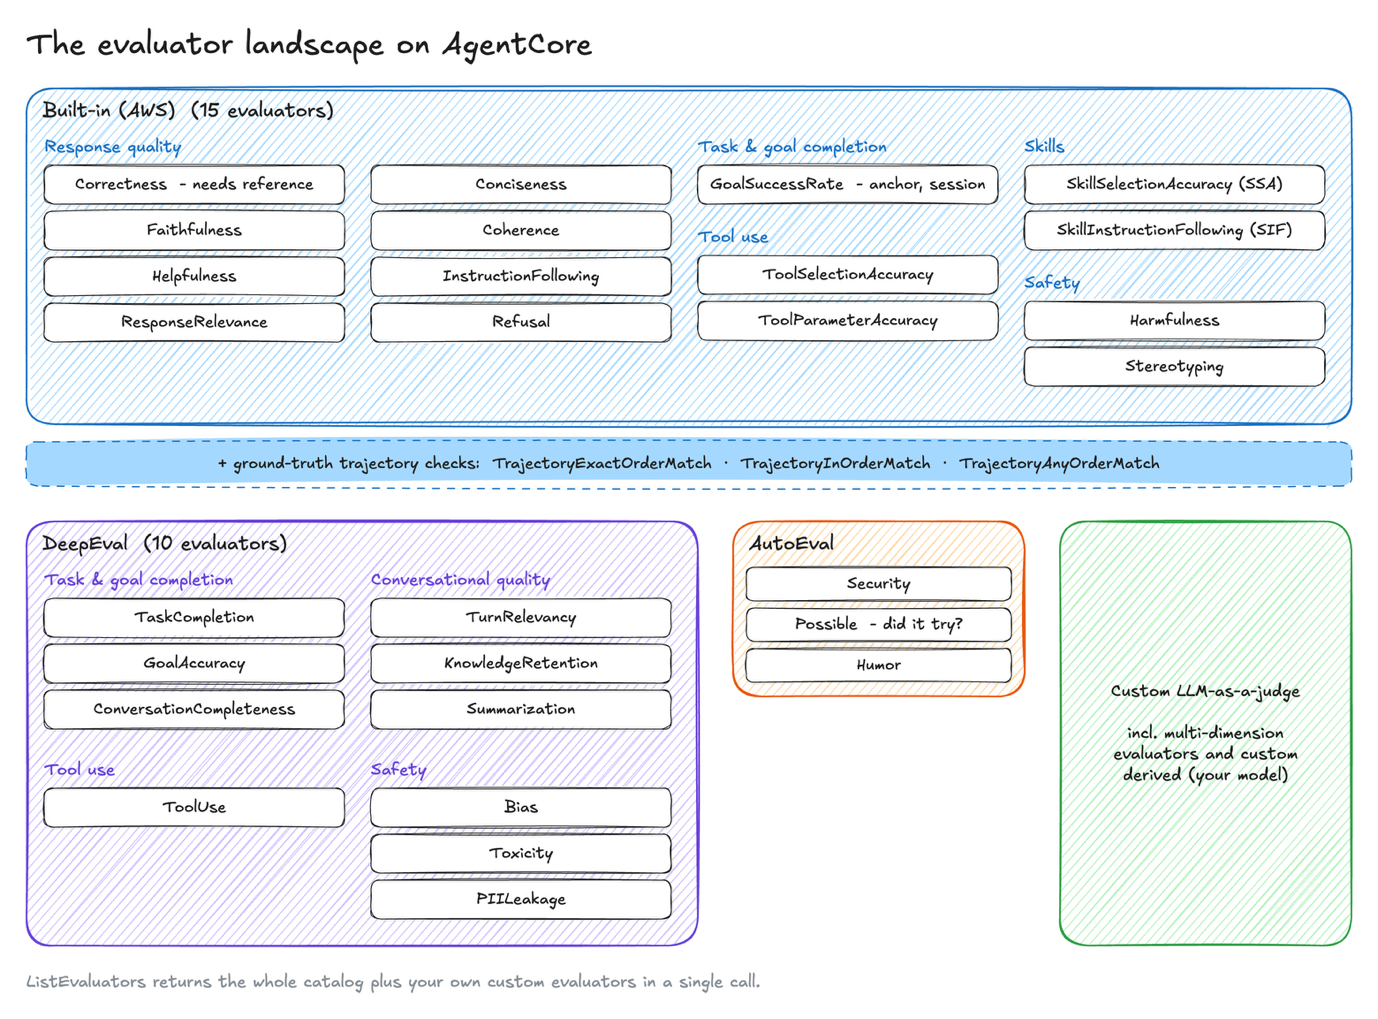
图 4:AgentCore 上涵盖内置、DeepEval、AutoEval 和自定义来源的完整评估器全景
内置 AWS 评估器分为五组:
- 响应质量涵盖答案是否准确、有依据且格式良好:
Correctness、Faithfulness、Helpfulness、ResponseRelevance、Conciseness、Coherence、InstructionFollowing和Refusal。 - 任务与目标完成度包含
GoalSuccessRate,它着眼于整个会话,考察用户的目标是否达成。 - 工具使用包含
ToolSelectionAccuracy和ToolParameterAccuracy,用于检查智能体是否选对了工具,并向其传入了正确的参数。 - 技能包含
SkillSelectionAccuracy和SkillInstructionFollowing,适用于会加载技能的智能体:是否调用了正确的技能,是否遵循了该技能的步骤? - 安全性包含
Harmfulness和Stereotyping。
除此之外,还有三项基于标准答案轨迹的检查:TrajectoryExactOrderMatch、TrajectoryInOrderMatch 和 TrajectoryAnyOrderMatch。它们将智能体实际走过的工具路径与你预期的路径进行对比。当智能体“如何达成”与“产出了什么”同样重要时,就应使用这些检查。
DeepEval 提供四组托管式开源指标:
- 任务与目标完成度:
TaskCompletion、GoalAccuracy和ConversationCompleteness。 - 对话质量:
TurnRelevancy、KnowledgeRetention和Summarization。 - 工具使用:
ToolUse。 - 安全性:
Bias、Toxicity和PIILeakage。
这些指标对多轮智能体尤为有用。ConversationCompleteness 能发现智能体只回答了最新一条消息、却悄悄忽略了更早请求的情况。KnowledgeRetention 能发现智能体忘记了用户在三轮之前说过的内容。
AutoEval 提供更专门的信号:
Security标记恶意输出,例如试图注入指令或泄露系统提示词。Possible能发现过度谨慎的智能体,它们会错误地宣称某个有效任务不可能完成。Humor对面向消费者的智能体很重要,因为个性本身就是产品的一部分。
自定义评估器。当指标目录中没有合适的评估器时,你可以编写自定义的 LLM-as-a-judge。
每个评估器的确切定义、评分量表和输入要求都收录在 AgentCore 文档 的提示词模板库中。其中包含它使用的评判提示词、运行所在的 trace 或会话层级,以及它是否需要参考答案或预期轨迹。你可以调用 ListEvaluators API,在一次响应中获取完整目录以及你自己的自定义评估器。
多维度评估器
到目前为止,每个评估器对每条 trace 或每个会话只返回一个分数。当你只衡量一种行为时,这没有问题。但在结果映射的第 2 步中,每个评估器很少只对应一种行为。一条客服回复必须解决问题、遵守退款和数据政策,并保持专业。一个同时权衡这三项的评判器只返回一个数字,你无法判断是哪个标准决定了这个分数。
多维度评估器是一种自定义的 LLM-as-a-judge,它使用一组维度而非单一量表。每个维度都有自己的名称、指令,以及数值型或分类型量表。评判器只读取一次 trace,并在同一次调用中为每个维度打分。AgentCore 会为每个维度返回一个结果。
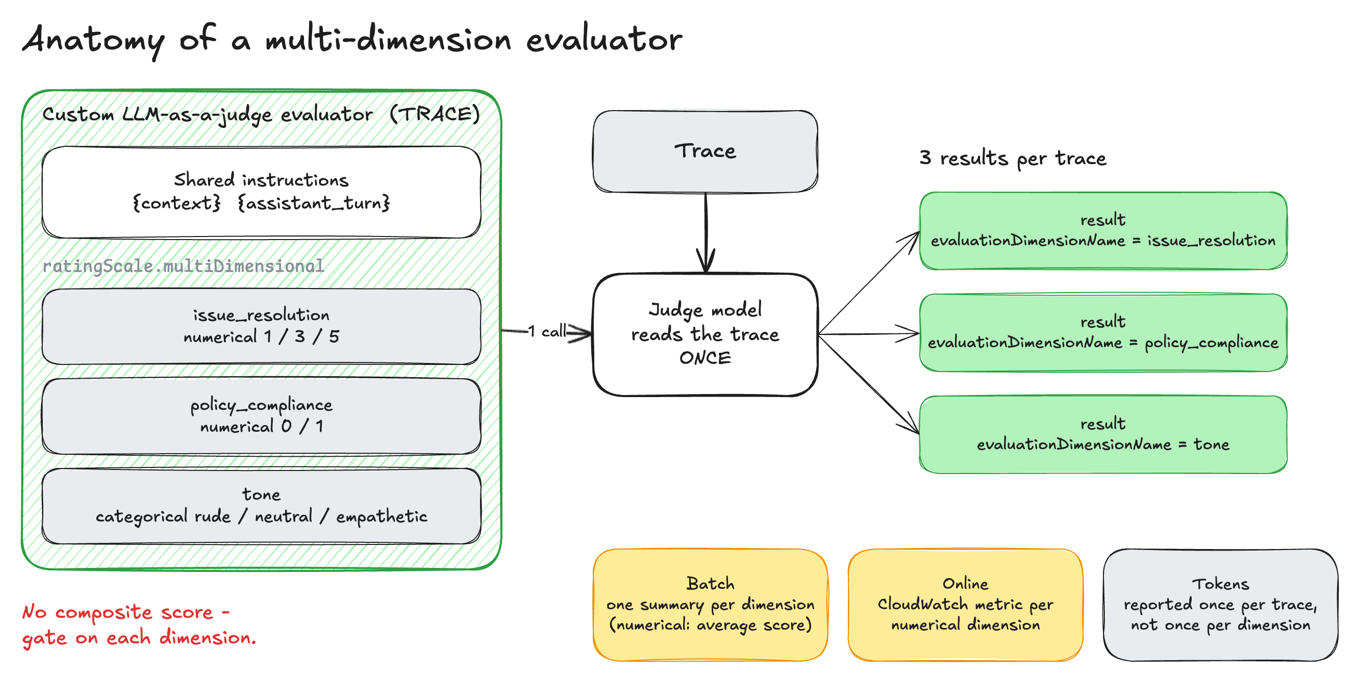
图 5:多维度评估器通过一次评判调用对多个维度打分,并为每个维度返回一个结果,不产生综合分数
当你的成功标准可能各自独立地失败时,就应使用多维度评估器,例如回答准确但不合规,或者问题已解决但态度粗鲁。它还需要每项标准都能从同一份证据中评判,这样一次评判调用就能替代多个几乎相同、反复读取同一 trace 的评估器。当你分别对各项标准打分时,就可以针对每一项设置门禁。一次改善了语气但导致政策合规性退化的发布会被判定为失败,而单一的综合分数会掩盖这一点。
当已有内置或第三方指标能够覆盖某些评估标准时,应将这些标准保留在单独的评估器中,例如 Builtin.Correctness 或 ThirdParty.DeepEval.PIILeakage。当这些标准需要不同的级别或评判模型时,也应将它们分开,因为同一个评估器中的各个维度共享单一的级别和模型。当某些标准需要基准真值(如 {expected_response} 或 {assertions})时,同样应这样做。将无需参考的标准保留在各自的评估器中,意味着它仍然可以在实时流量上运行。
按智能体类型划分的示例评估器组合
以下每个组合都以两到三个最契合业务成果的评估器开头。当你发现第一组评估器遗漏的故障模式时,再添加其他评估器。标记为“需要基准真值”的评估器仅在批量评估中运行,因为实时流量没有参考答案或预期路径。
|
| 客户支持 | 多步骤研究 | 领域内容(医疗、法律、金融) |
| --- | --- | --- | --- |
| 业务成果 | 在一次会话中解决问题,且无下游风险 | 通过既定工作流给出完整、来源充分的答案 | 在领域内给出正确、无偏见且安全的答案 |
| 主要风险 | 请求丢失、不安全或不合规的回复 | 通过错误的工具路径得到正确答案,或在长会话中丢失上下文 | 错误答案。错误答案比没有答案更糟。 |
| 从以下开始 | Builtin.GoalSuccessRate(锚点)ThirdParty.DeepEval.ConversationCompleteness ThirdParty.DeepEval.PIILeakage | Builtin.TrajectoryAnyOrderMatch(需要 ground truth)ThirdParty.DeepEval.GoalAccuracy ThirdParty.DeepEval.KnowledgeRetention | Builtin.Correctness(需要 ground truth)ThirdParty.DeepEval.PIILeakage ThirdParty.AutoEval.Security |
| 按需添加 | ThirdParty.DeepEval.Toxicity ThirdParty.AutoEval.Security(敏感账户数据)Builtin.Helpfulness | Builtin.SkillInstructionFollowing ThirdParty.AutoEval.Possible | ThirdParty.DeepEval.Bias Builtin.Helpfulness |
| 派生评估器 | 可选 | 如果推理必须留在你的账户内,则用于轨迹和技能指标 | 几乎总是需要,以便每次 judge 调用都处于你的数据治理之下 |
运行评估:三种模式
AgentCore 支持三种评估模式。
按需评估是反馈最快的循环。在开发或调试期间,直接将会话传给 client.evaluate()。系统中的每个评估器(包括第三方评估器)都可在此模式下使用。
import boto3

client = boto3.client('bedrock-agentcore')

response = client.evaluate(
    evaluatorId="ThirdParty.DeepEval.TaskCompletion",
    evaluationInput={"sessionSpans": session_span_logs}
)

for result in response["evaluationResults"]:
    print(f"Value: {result.get('value')}")
    print(f"Explanation: {result.get('explanation', '')}")
在线评估会挂接到你正在运行的 agent 运行时,并按配置的采样率对真实流量进行采样。这是你的生产健康信号。内置评估器和第三方评估器可以在单个在线评估配置中自由混用。
批量评估会针对一组固定的会话运行定义好的评估器栈:即你在发布前用于回归测试的黄金数据集。用它来确认提示词变更或模型升级在你关心的每个维度上都保持了质量。
三种模式使用相同的评估器 ID。从按需的开发测试切换到生产在线评估只是一次配置变更,而不是代码重写。
综合运用
越来越难的部分在于选择哪些评估器。挑选两到三个最能体现你是否达成业务结果的行为,并优先测量它们。当你发现当前评估器组合漏掉的失败时,再添加一个评估器。
要查看完整目录,请调用 ListEvaluators API。它会在一个响应中返回内置评估器、DeepEval 和 AutoEval 评估器,以及你账户中的任何自定义评估器。在选择其中任何一个之前,请先回答两个问题:“对这个 agent 来说,成功是什么样子?”以及“trace 中的什么行为表明它发生了?”