Gemini 4 Carbon 登顶智能指数 编码能力仅次于 Claude
Google 发布 Gemini 4 Carbon,在 Artificial Analysis 智能指数 v5 中位列第一,并在编码代理指数中仅次于 Claude Opus 5.5。该模型在复杂推理、科学任务及自动化基准上表现卓越,目前处于受限测试阶段,定价与 Argon 持平但提供限时折扣。
报道正文
Artificial Analysis (@ArtificialAnlys) · 2026-10-28 17
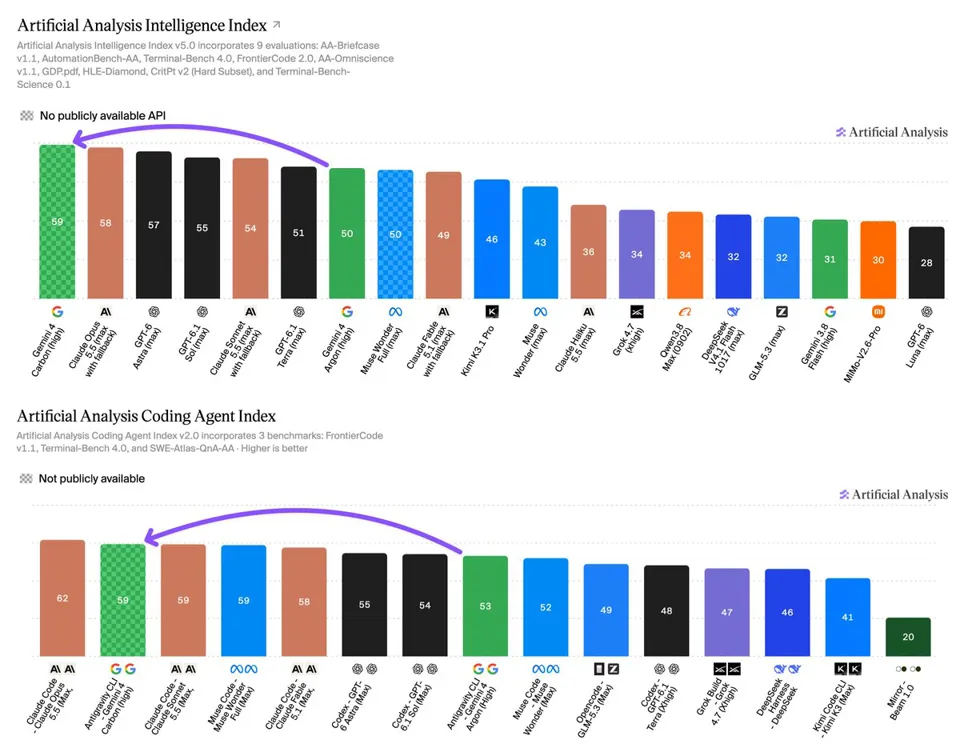
Google 的 Gemini 4 Carbon 在 Artificial Analysis Intelligence Index v5 中位列第一,并在 Artificial Analysis Coding Agent Index 中仅次于 Claude Opus 5.5。
Gemini 4 Carbon 在 Intelligence Index v5 中得分为 59,这得益于其在复杂推理、知识问答和科学任务方面的领先表现。它在编程和知识工作方面也有显著提升,尤其是与其他 Gemini 模型相比,但在这些领域并非全面领先。
与 Gemini 4 Argon 发布时类似,Gemini 4 Carbon 目前仅向部分用户推出,尚未公开可用。Google 提供 50% 的首发折扣,且未确定结束日期。我们所有的图表和数据均采用 Gemini 4 Carbon 和 Argon 的标准定价。
Gemini 4 Carbon(高推理模式)的关键结果: ➤ 领跑 Intelligence Index v5:Gemini 4 Carbon 在 9 项指数评估中的 4 项得分第一:HLE-Diamond、Terminal-Bench-Science、AA-Omniscience 和 AutomationBench-AA。Carbon 在其他方面也有大幅进步,但在编程和知识工作领域并未处于领先地位。
➤ 在编程代理方面仅次于 Claude Opus 5.5:使用 Antigravity CLI 时,Gemini 4 Carbon(高推理模式)在 Artificial Analysis Coding Agent Index 中得分为 59,仅比使用 Claude Code 的 Claude Opus 5.5(最大推理模式,62 分)低 3 分。Carbon 在 Terminal-Bench 4.0(64%)和 FrontierCode v1.1(51%)中均排名第二,落后于 Claude Opus 5.5(最大推理模式,56%)。鉴于 Google 此前在该领域的表现一直不佳,这一进步尤为显著。
➤ 代理式知识工作有所改进,但尚未领先:在 AA-Briefcase 测试中,Gemini 4 Carbon(高推理模式)得分为 1609 Elo,比 Gemini 4 Argon(高推理模式,1483 分)提高了 126 分,但仍落后于 Grok 4.7(超高推理模式,1638 分)、Muse Wonder(最大推理模式,1659 分)和 Kimi K3.1 Pro(1678 分)。最大的提升来自演示文稿生成(Presentation),Elo 分数上升 293 分至 1598,同时分析质量(Analytical Quality)也提升了 120 分至 1671。
➤ 在整体智能相当的情况下,单任务成本低于 Claude Opus 5.5:Gemini 4 Carbon 每个 Intelligence Index 任务的成本为 $7.76,比 Claude Opus 5.5(最大推理模式,$10.04)低约 23%,但约为 GPT-6 Astra(最大推理模式,$6.25)的 1.2 倍。它每个任务消耗 12.3 万输出 token,比 Claude Opus 5.5(最大推理模式,17.3 万)少 29%。在相同的 20 标准定价下,其单任务成本与 Gemini 4 Argon($7.68)持平,但在 Intelligence Index 上的得分高出 9 分。
➤ 在 AA-Omniscience v1.1 评分中领先,且幻觉率较低:Gemini 4 Carbon 在我们最新更新的 AA-Omniscience v1.1 测试中得分为 54 分,比 Claude Opus 5.5(max,48 分)高出 6 分,比 Gemini 4 Argon(46 分)高出 8 分。其准确率(正确百分比)较 Argon 提升 10 个百分点至 58%,而幻觉率则从 4% 上升至 11%。这仍是所有模型中第二低的幻觉率,仅次于 Argon;相比之下,Claude Opus 5.5 (max) 和 GPT-6 Astra (max) 的幻觉率均为 50%
关键模型细节: ➤ 上下文窗口:1M tokens ➤ 多模态性:支持文本、图像、视频和语音输入,输出为文本 ➤ 定价:每百万输入/输出 token 收费 20,与 Gemini 4 Argon 的标准定价相同,但享有 50% 折扣。缓存输入 token 享受 95% 折扣(每百万 $0.20)
祝贺 @GoogleDeepMind 团队!