Artificial Analysis 发布 v5 智能指数 引入私有基准与进度追踪
Artificial Analysis 推出其智能指数的重大升级版本 v5,首次将 60% 的评估权重基于私有测试集或保留答案,以应对公开基准饱和问题。新版本引入了 Cognition 的 FrontierCode 2.0 和 Terminal-Bench-Science 两个新基准,并同步发布了用于长期追踪模型能力演进的 Progress Index v1。
报道正文
本文目录5 个章节
2026 年 10 月 27 日
发布 Artificial Analysis Intelligence Index v5
Index v5 包含 2 个新基准测试和 3 项升级。首次实现,该指数的主要部分基于私有数据集构建
Artificial Analysis Intelligence Index 是我们对模型在反映当今真实使用场景的任务中能力的综合衡量指标。v5 是自今年一月 v4 发布以来我们最大的一次升级。在 v5 中,指数中 60% 的内容现在基于使用私有测试集或保留答案的评估结果。
伴随 Intelligence Index v5,我们同时推出 Artificial Analysis Progress Index v1,该指数在一个连续尺度上追踪模型能力随时间的变化。
Intelligence Index 新增内容:
➤ FrontierCode 2.0: Cognition 最新推出的私有基准测试,针对真实世界的编码任务,评分标准是仓库维护者是否会合并智能体(agent)提出的更改
➤ Terminal-Bench-Science: 70 项在终端环境中运行的智能体科学研究任务
升级内容:
➤ HLE-Diamond(取代 Humanity's Last Exam): 经过精炼的 1,000 题版 Humanity's Last Exam,推理题与知识题各占一半
➤ AA-Omniscience v1.1: 更新后的数据集,移除了已饱和的题目和公开集题目,新增了题目,并修订了存在歧义或错误的题目
➤ CritPt v2: CritPt v2 的一个私有、40 题高难度子集,由 CritPt 作者修订,并使用代码执行工具运行
保留在指数中的项目: AA-Briefcase、AutomationBench-AA、GDP.pdf 和 Terminal-Bench 4.0
从指数中移除的项目: GDPval-AA v2.1、SciCode 和 AA-LCR v1.1
Intelligence Index v5 权重分布:
➤ 知识工作 (Knowledge Work) (25%): AA-Briefcase (15%)、AutomationBench-AA (5%) 和 GDP.pdf (5%)
➤ 编码 (Coding) (25%): FrontierCode 2.0 (15%) 和 Terminal-Bench 4.0 (10%)
➤ 科学 (Science) (25%): Terminal-Bench-Science (15%) 和 CritPt v2 高难度子集 (10%)
➤ 通用 (General) (25%): AA-Omniscience v1.1 (15%,其中准确率占 10%,非幻觉率占 5%) 和 HLE-Diamond (10%)
关键结果:
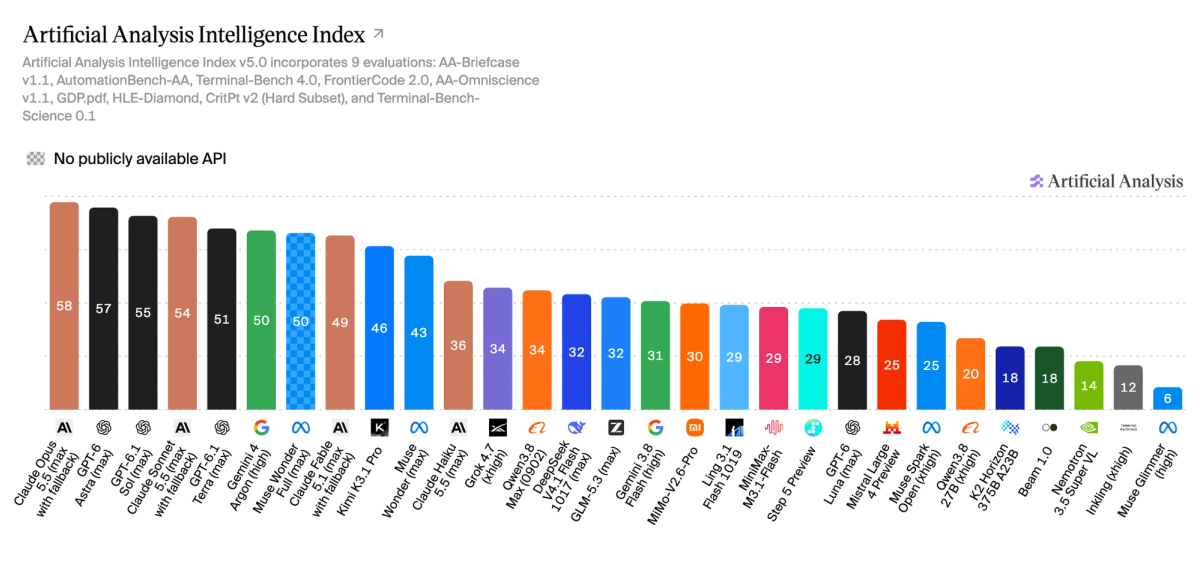
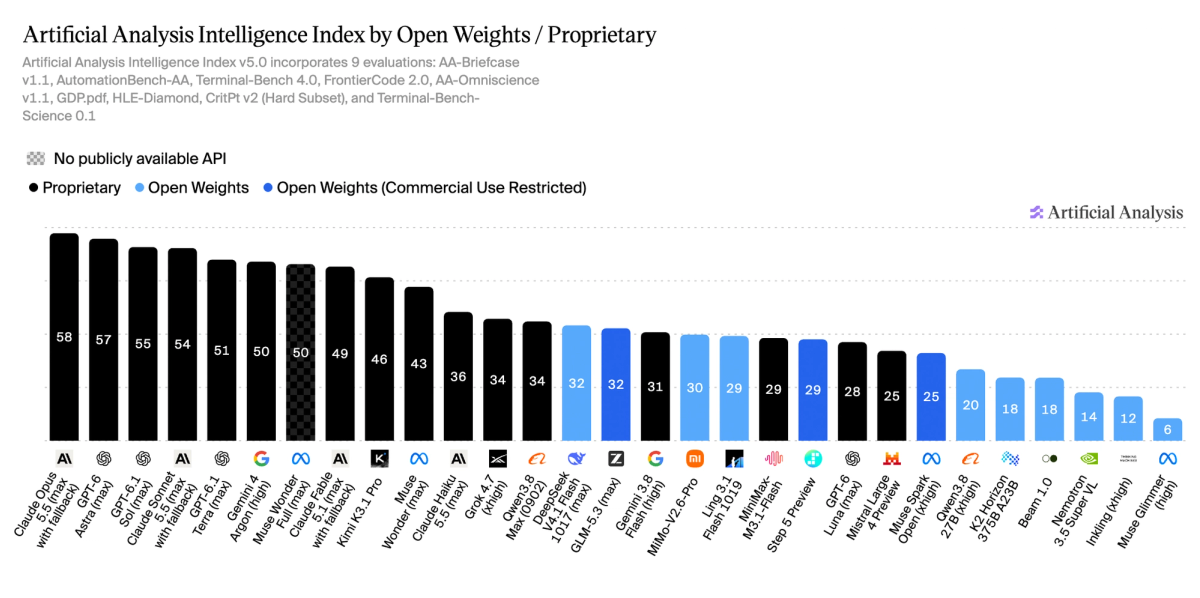
➤ Claude Opus 5.5 (max) 以 58 分领先,紧随其后的是 GPT-6 Astra (max, 57 分) 和 GPT-6.1 Sol (max, 55 分): Anthropic 和 OpenAI 占据了前五名模型的位置。Gemini 4 Argon (high) 以 50 分位列其后
➤ 开放权重模型的差距从 3 分扩大至 12 分: Kimi K3.1 Pro(权重尚未发布)以 46 分成为领先的开放权重模型。在已发布权重的模型中,DeepSeek V4.1 Flash 1017 (max) 和 GLM-5.3 (max) 以 32 分领先——落后榜首 26 分,且低于 Claude Haiku 5.5 (max, 36 分)
➤ 领先模型之间的单任务成本差异超过 13 倍: 在展示的得分最高的 10 个模型中,GPT-6.1 Terra (max) 最便宜,每个 Intelligence Index 任务的成本为 $0.96;而 Claude Fable 5.1 (max) 最昂贵,成本高达 $13.04
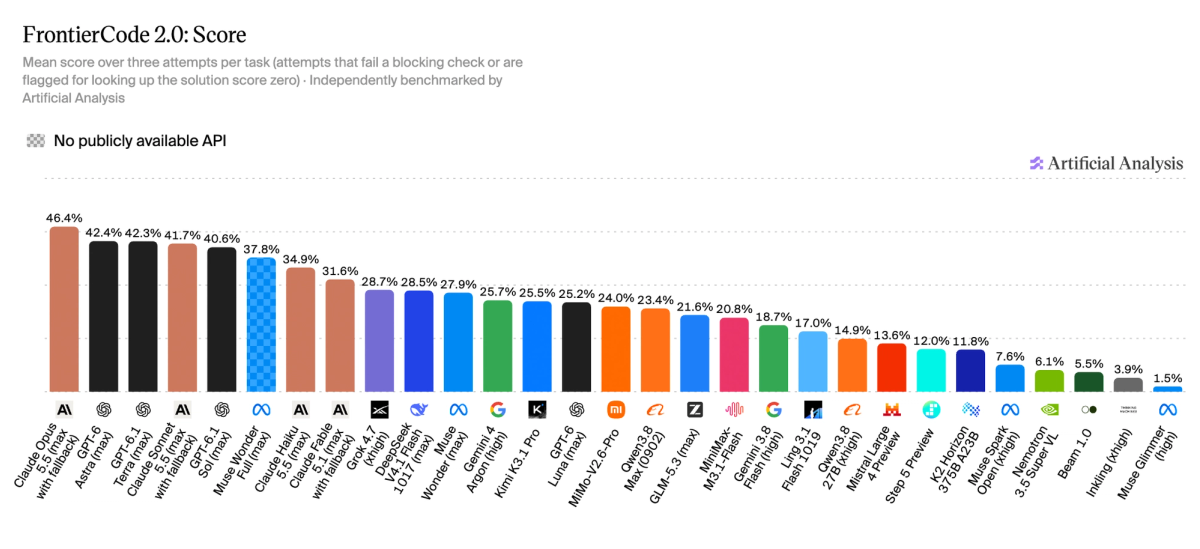
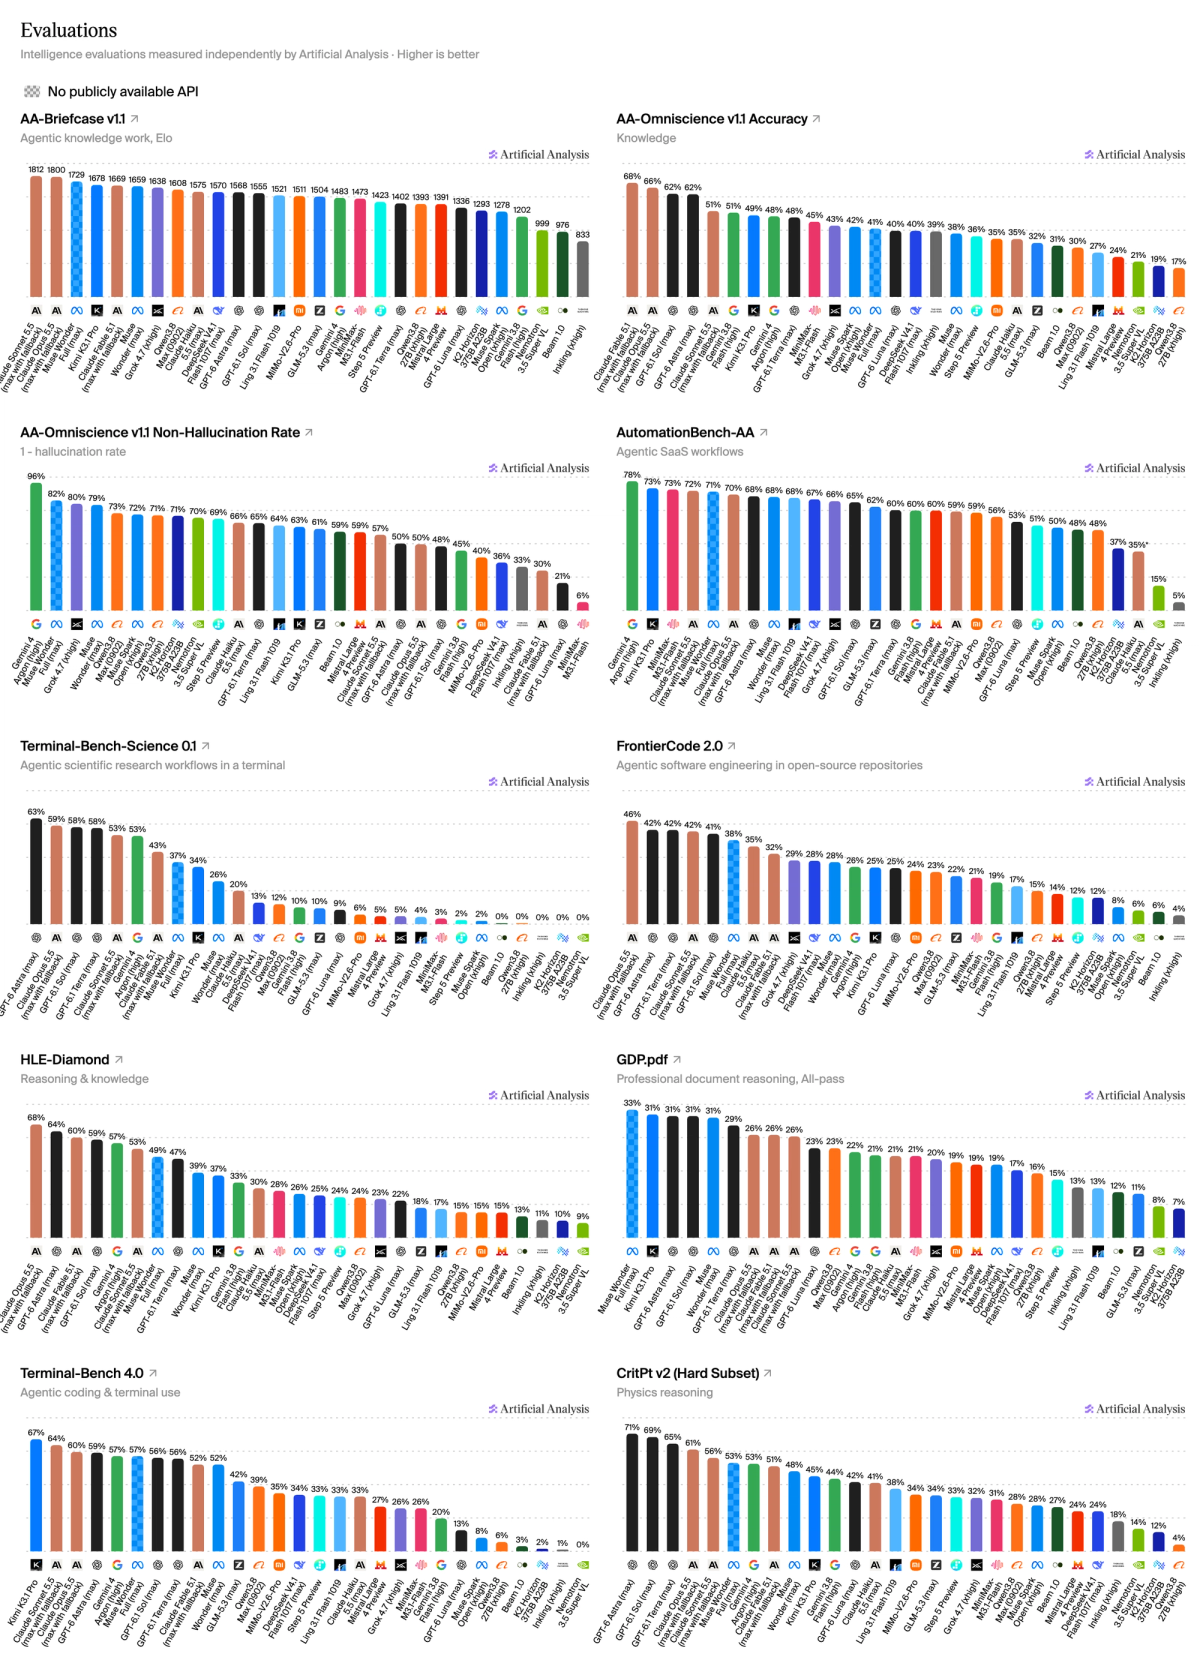
FrontierCode 2.0 是 Cognition 最新更新的私有编码基准测试。该测试于今日早些时候发布,包含来自真实开源仓库的 132 个任务,评分标准基于维护者是否会合并智能体(agent)提交的更改。如果某次尝试未能通过任何阻塞性检查(blocking check),则得分为 0,且这些任务保持私密以避免数据污染。我们在 Stirrup(我们的 agentic harness)中对每个任务运行三次。
Claude Opus 5.5 (max) 以 46% 的得分位居榜首,紧随其后的是 GPT-6 Astra (max)、GPT-6.1 Terra (max) 和 Claude Sonnet 5.5 (max),这三者的得分均为 42%。DeepSeek V4.1 Flash 1017 (max) 是得分最高的开放权重(open weights)模型,得分为 28%,比榜首落后 18 个百分点。
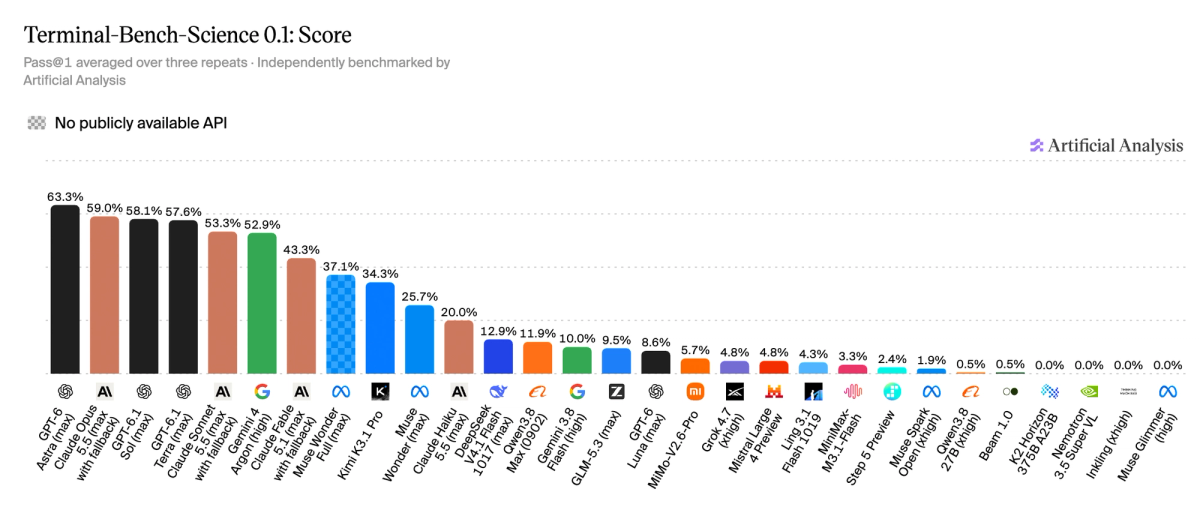
Terminal-Bench-Science 测试智能体能否在终端环境中执行科学研究工作流。每个任务均由专家策划并审核,只有当任务的所有测试项全部通过时,该任务才算成功。
GPT-6 Astra (max) 以 63% 的得分领先,其次是 Claude Opus 5.5 (max)(59%)和 GPT-6.1 Sol (max)(58%)。与头部模型相比,后续模型的得分急剧下降:表现最好的开放权重模型 Kimi K3.1 Pro(权重尚未发布)得分为 34%,而 Claude Haiku 5.5 (max) 得分为 20%。已发布权重的最佳开放权重模型 DeepSeek V4.1 Flash 1017 (max) 得分为 13%,而我们基准测试中的大多数开放权重模型得分均低于 10%。
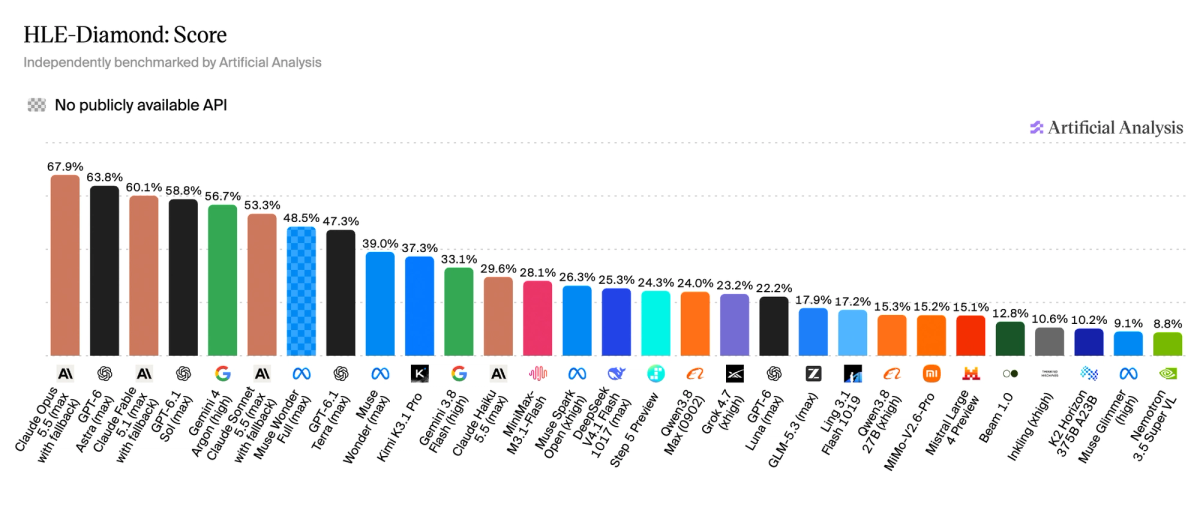
HLE-Diamond 取代了 Humanity's Last Exam 进入 Index 体系。它是由 Center for AI Safety (CAIS) 和 Scale AI 对 Humanity's Last Exam 进行精炼后的 1,000 题版本,题目均匀分布在推理(reasoning)和知识(knowledge)两类之间。Claude Opus 5.5 (max) 以 68% 的得分领先,其次是 GPT-6 Astra (max)(64%)和 Claude Fable 5.1 (max)(60%)。
对于领先模型而言,知识类问题比推理类问题更难:Claude Opus 5.5 (max) 和 GPT-6 Astra (max) 在推理类问题上的得分均为 78%,而在知识类问题上的得分分别为 58% 和 50%。
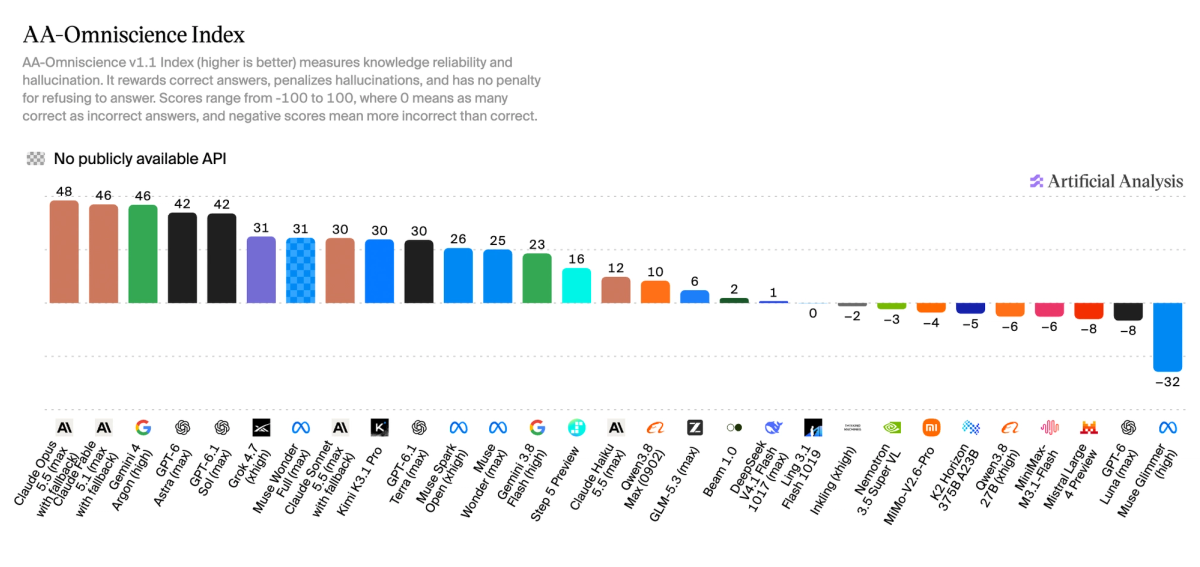
AA-Omniscience v1.1 是我们知识与幻觉基准测试的清理版本,移除了饱和及公开集题目,新增了部分题目,并修订了存在歧义或错误的题目。得分与 v1 版本基本保持一致,模型在 AA-Omniscience v1.1 指数上的平均得分降低了 2 分(中位数为 0.6)。我们还发布了一个新的公开子集 AA-Omniscience-Public-v1.1,该子集经过重新校准,以确保公开集和私有集在准确率、幻觉率及整体性能上保持一致。
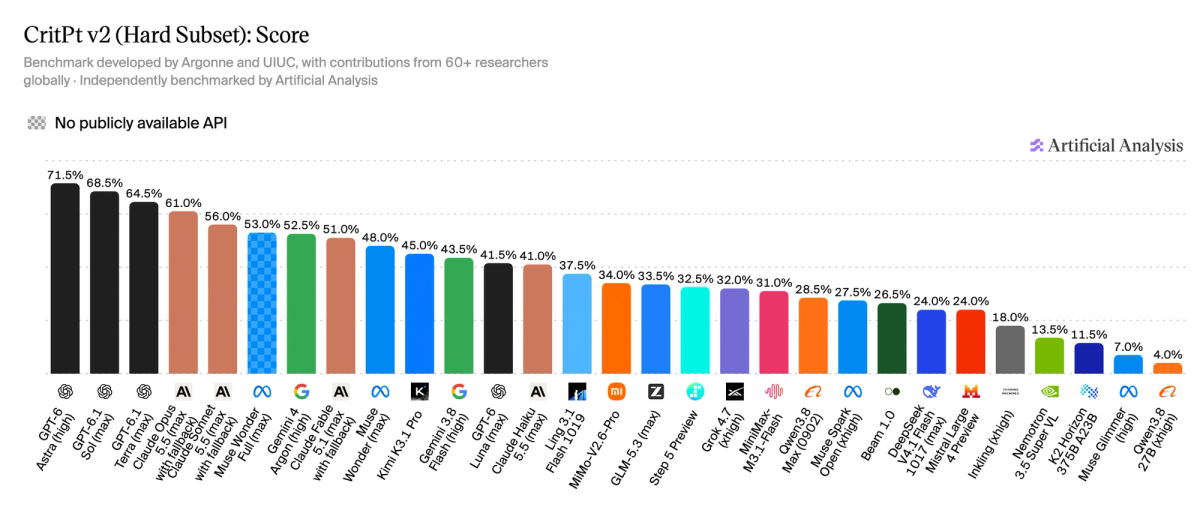
该指数基于一个包含 40 道题目的私有高难度子集对 CritPt v2 进行评分:即从 70 道研究级物理题中,剔除掉七款前沿模型在发布时五次尝试均能解出的 30 道题。模型在我们的智能体框架 Stirrup 中的离线 Python 沙箱内运行。
GPT-6 Astra 在高努力度(high effort)设置下以 72% 的得分领先,其次是 GPT-6.1 Sol,其在最大努力度(max effort)设置下得分为 69%。Claude Opus 5.5(最大努力度)作为该指数的总体最佳模型,得分为 61%。Kimi K3.1 Pro(权重尚未发布)是得分最高的开源权重模型,得分为 45%。
v5 版本在所有九项评估中都留有显著的进步空间,且没有任何单一模型能在所有项目中保持领先。 在我们测量的模型中,Claude Opus 5.5 领先三项,其他五个模型分别领先剩余的六项:
➤ Claude Opus 5.5: FrontierCode 2.0 (46%)、HLE-Diamond (68%) 和 AA-Omniscience v1.1 (48)
➤ GPT-6 Astra: Terminal-Bench-Science (63%) 和 CritPt v2 高难度子集 (72%)
➤ Claude Sonnet 5.5: AA-Briefcase (1812 Elo)
➤ Kimi K3.1 Pro: Terminal-Bench 4.0 (67%)
➤ Gemini 4 Argon: AutomationBench-AA (78%)
➤ Muse Wonder Full: GDP.pdf (33% 全通过)
在 v5 版本中,开源权重模型的差距进一步拉大。 表现最好的 Kimi K3.1 Pro(权重尚未发布)得分为 46,落后榜首 12 分,而在 v4.3 版本中这一差距仅为 3 分。在已发布权重的模型中,DeepSeek V4.1 Flash 1017(最大努力度)和 GLM-5.3(最大努力度)得分最高,均为 32 分,而 Claude Haiku 5.5(最大努力度)的得分超过了它们所有。
在 HLE-Diamond 和 Terminal-Bench-Science 上,差距最为显著:Kimi K3.1 Pro 的得分分别为 37% 和 34%,而 Claude Opus 5.5 (max) 为 68%,GPT-6 Astra (max) 为 63%。
领先模型之间的成本差异巨大。 Claude Opus 5.5 (max) 每完成一项 Intelligence Index 任务的成本为 10.04 美元,GPT-6 Astra (max) 为 6.24 美元,GPT-6.1 Sol (max) 为 1.27 美元。GPT-6.1 Sol (max) 的得分与 Claude Opus 5.5 (max) 相差不到 4 分,但每项任务的成本仅约为后者的八分之一。
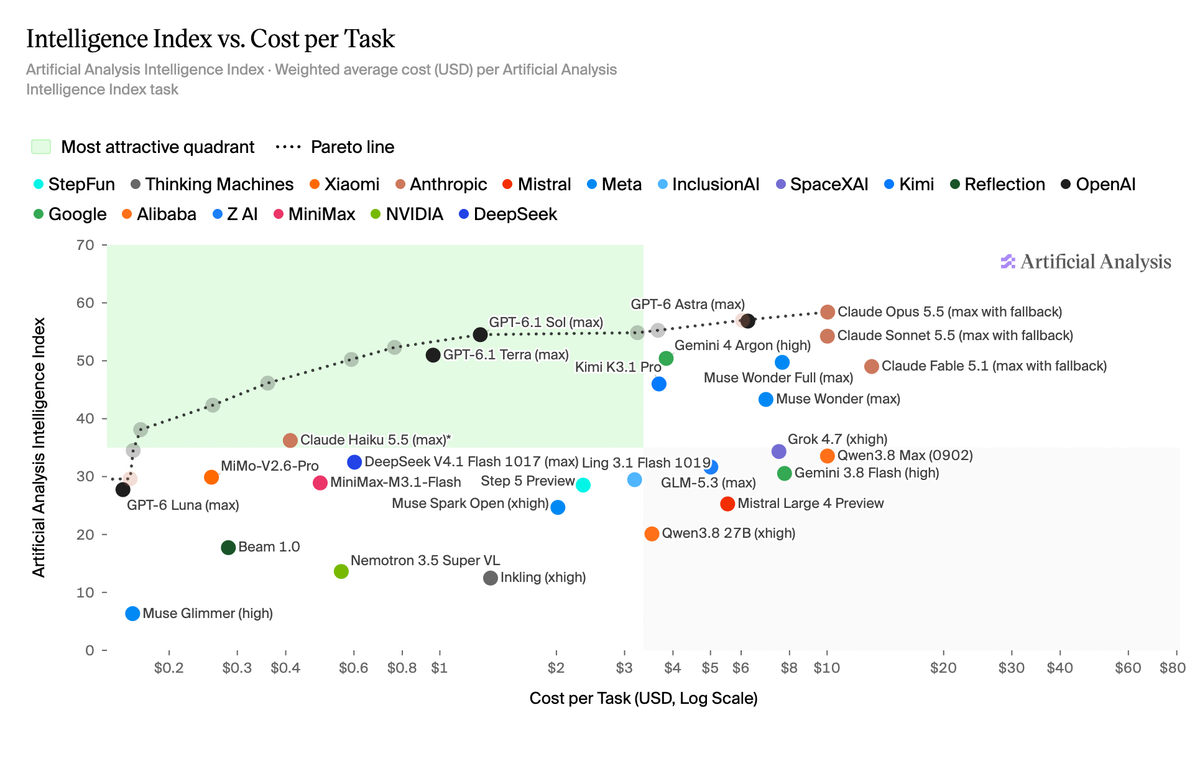
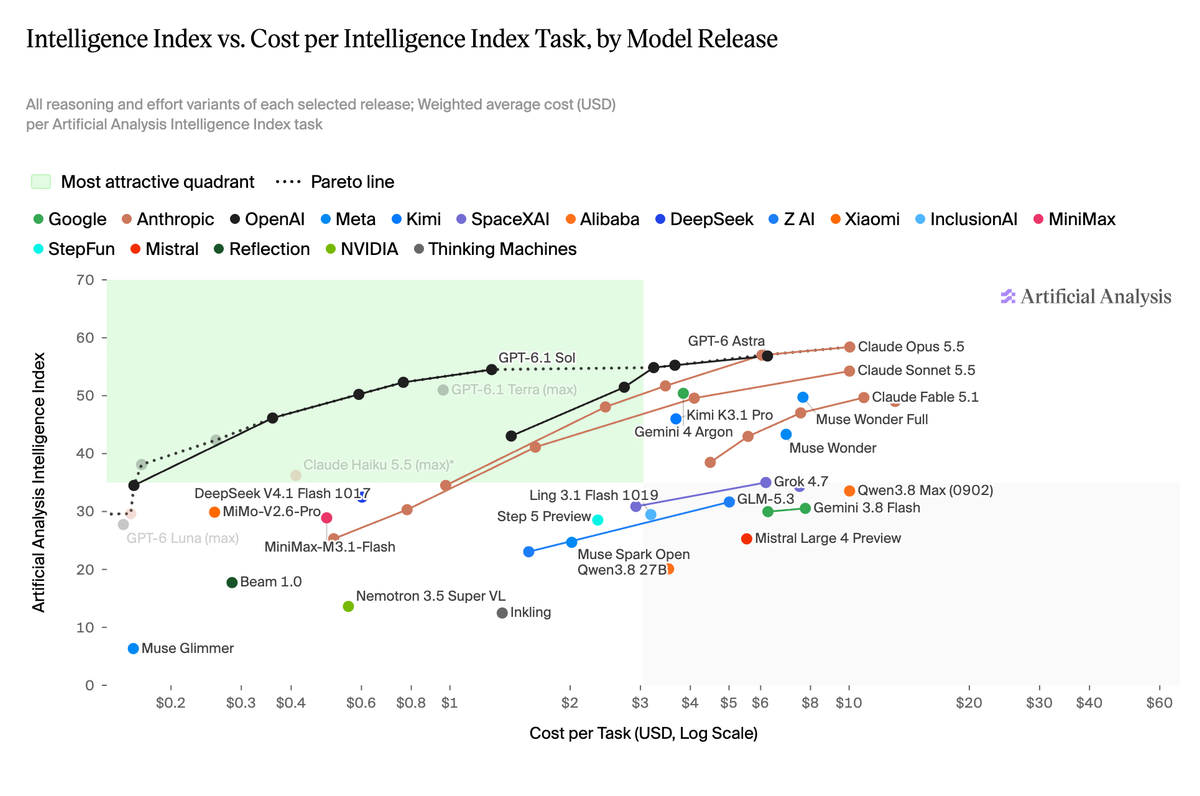
在 v5 中,努力程度(Effort)设置的影响比 v4.3 更大。 Claude Opus 5.5 在低努力程度下的得分为 35,最大努力程度下为 58,而每项 Intelligence Index 任务的成本增加了 10 倍(从 0.98 美元增至 10.04 美元)。Claude Sonnet 5.5 从低到最大努力程度的得分跨度达 29 分,高于 v4.3 中的 20 分;GPT-6.1 Sol 的得分跨度则从 10 分翻倍至 20 分。
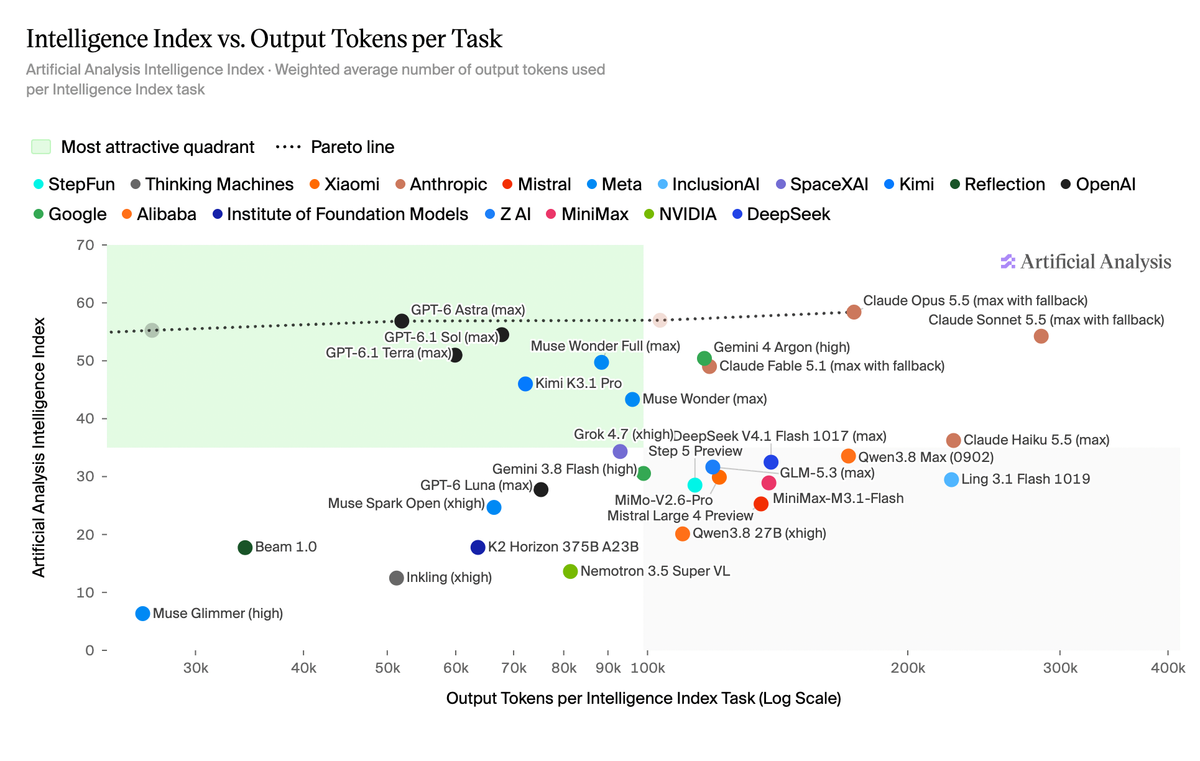
v5 任务要求模型投入更多工作量。 我们测量的每个模型在每项 Intelligence Index 任务中生成的输出 token 数量都多于 v4.3,中位数从 3.5 万上升至 5.9 万,增幅达三分之二。
➤ Agentic 评估占据了大部分 token 使用量: Terminal-Bench-Science、Terminal-Bench 4.0、AA-Briefcase 和 FrontierCode 2.0 占 Index 权重的 55%,但贡献了约 90% 的中位输出 token。
➤ Terminal-Bench-Science 是 token 消耗最高的基准测试: 它单独就占了每项任务输出 token 总量的约三分之一。
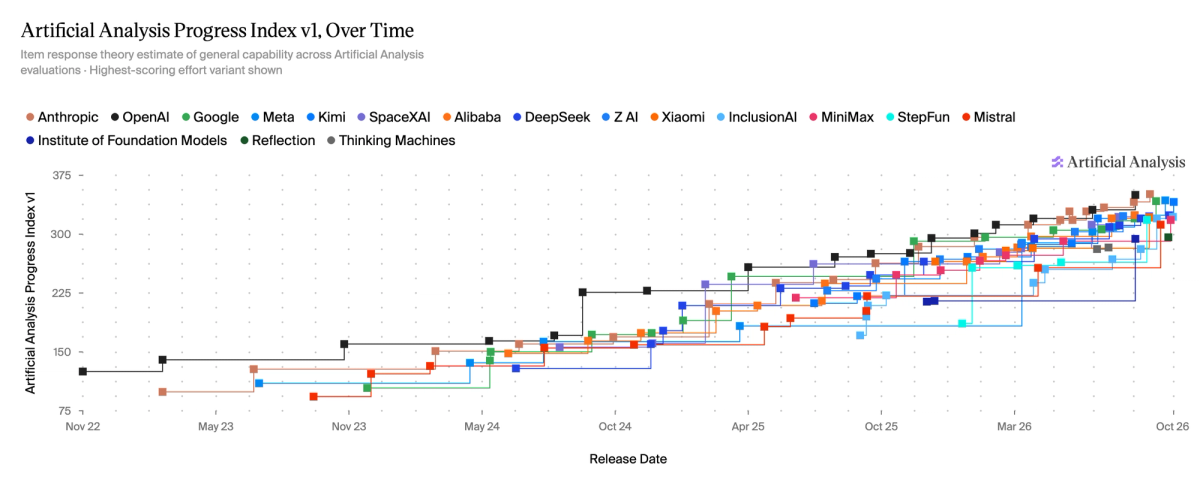
伴随 v5 发布,我们推出了 Artificial Analysis Progress Index v1。 该指数将自 2022 年 11 月以来发布的语言模型置于单一能力尺度上进行评估,涵盖广泛的基准测试。
使用 Progress Index 可以比较底层能力随时间的变化,包括对比相隔数年发布的模型。若要针对当前用例比较模型并了解当前的前沿水平,请使用 Intelligence Index,它仍是我们衡量当前模型智能的主要指标。
感谢 Epoch AI 和 Anthropic——我们在设计 Progress Index 时借鉴了 Epoch Capabilities Index 的经验。
探索进展指数:artificialanalysis.ai/trends
感谢 Cognition、Steven Dillmann 及 Terminal-Bench 团队、AI 安全中心(Center for AI Safety)、Scale AI,以及 Minhui Zhu、Minyang Tian、Hao Peng 和 CritPt 团队为本次更新提供的基准测试支持。
查看完整结果:artificialanalysis.ai
方法论:artificialanalysis.ai/methodology/intelligence-benchmarking
阅读最新动态
[
Code2Video-AA:AI 模型在通过代码设计视频方面的表现如何?
Artificial Analysis 对 HeyGen 的 Code2Video Bench 的实现,评估模型使用 HyperFrames HTML 根据 114 个设计简报创建简短产品和品牌视频的能力。
2026年10月26日](https://artificialanalysis.ai/articles/code2video-aa)[

GPT-6.1 Terra 推动成本效率前沿
OpenAI 发布了 GPT-6.1 Terra,推动了成本效率的前沿。这是自 GPT-5.6 以来首个 Terra 级模型,其智能水平更高,而成本不到前者的三分之一。
2026年10月26日](https://artificialanalysis.ai/articles/gpt-6-1-terra-pushes-the-cost-efficiency-frontier)[

Kimi K3.1 Pro 在智能指数中排名第 4,并将领跑开源权重模型
Kimi K3.1 Pro 在 Artificial Analysis 智能指数中排名第 4,并将领跑开源权重模型
October 23, 2026](https://artificialanalysis.ai/articles/kimi-k3-1-pro-launch-benchmarks){"@context":"https://schema.org","@type":"NewsArticle","headline":"Announcing Artificial Analysis Intelligence Index v5","description":"Index v5 features 2 new benchmarks and 3 upgrades. For the first time, the majority of the Index is built on private datasets","datePublished":"2026-10-27","dateModified":"2026-10-27","image":"https://cdn.sanity.io/images/6vfeftx9/articles/c091ec22bdbb2a18ba5205e03dd14575b80f552e-1200x1200.jpg?w=1200&auto=format","author":{"@type":"Organization","name":"Artificial Analysis","url":"https://artificialanalysis.ai"},"publisher":{"@type":"Organization","name":"Artificial Analysis","url":"https://artificialanalysis.ai"},"mainEntityOfPage":{"@type":"WebPage","@id":"https://artificialanalysis.ai/articles/artificial-analysis-intelligence-index-v5"}}
