研究称 DeepSeek 等四家中国模型厂商已用上 Blackwell 芯片
Unemployment Labs 通过对公开模型权重做取证分析,发现 DeepSeek、月之暗面、MiniMax 与蚂蚁集团自 2026 年 4 月以来发布的 6 个模型,其数值特征与英伟达 Blackwell 硬件匹配,而更早模型则对应上一代 Hopper。该结论完全来自模型自身权重而非爆料,并在 DeepSeek-V4-Flash 与 Kimi K3 上于实体 Blackwell 芯片完成验证,为出口管制执行提供了可复现的技术证据。
报道正文
本文目录8 个章节
执行摘要
我们对公开发布的AI模型进行法医分析,发现DeepSeek、Moonshot AI、MiniMax和Ant Group获得了NVIDIA的Blackwell GPU,尽管这些芯片出口到中国受到限制,并利用这些硬件创建了他们的AI模型。 自2026年4月以来,这些公司发布的六款模型包含与Blackwell硬件匹配的数值模式, 而同一公司早期的型号则与NVIDIA的旧一代Hopper相匹配。研究结果表明,多家领先的中国人工智能开发者已开始使用Blackwell来训练他们最新的模型。美国官员和媒体报道此前已指控DeepSeek和Moonshot AI使用了Blackwell芯片,但未公开技术证据。
证据完全来自模型自身公布的权重,而非泄露或内部消息。我们恢复模型初始值的痕迹,然后搜索硬件配置及其复现值的初始配置;对于DeepSeek-V4-Flash和Kimi K3,我们也确认了这场匹配,使用了实体Blackwell芯片。指纹识别了这些配重的制作过程,并支持(但未能证明)布莱克韦尔也执行过训练的推断。我们目前确定的唯一替代方案是专门配置的AMD硬件,且同样限制出口到中国;我们排除了DeepSeek-V4-Flash的使用,并且认为其他五款型号的这种可能性非常低。值得注意的是,我们的发现提供了先进计算硬件的技术证据,但未能确定芯片的位置、获取方式或是否违反了出口管制。
**表1。DeepSeek、Moonshot AI、MiniMax 和 Ant Group 的后续型号中的硬件指纹 链接 ↗
| 实验室 | 模型 | 已发布 | 模型最初使用的芯片 |
|---|---|---|---|
| 深度搜寻 | DeepSeek-V3 | 2024年12月 | NVIDIA Hopper(实验室披露的H800) |
| 深搜-V4-闪电 | 2026年4月 | • NVIDIA Blackwell B200/B300 | |
| DeepSeek-V4-Pro | 2026年4月 | • NVIDIA Blackwell GB200/GB300 | |
| 登月发射AI | Kimi K2 | 2025年7月 | NVIDIA Hopper(实验室披露的H800) |
| Kimi K2.5 | 2026年1月 | NVIDIA Hopper(实验室披露的H800) | |
| Kimi K3 | 2026年7月 | • NVIDIA Blackwell GB200/GB300 | |
| Kimi K3.1-Pro | 2026年11月 | • NVIDIA Blackwell GB200/GB300 | |
| MiniMax | MiniMax-M2.7 | 2026年4月 | NVIDIA Hopper |
| MiniMax-M3 | 2026年6月 | • NVIDIA Blackwell B200/B300 | |
| 蚁类群 | Ling-3.0-闪光 | 2026年8月 | NVIDIA Hopper |
| Ling-3.1-闪光 | 2026年10月 | • NVIDIA Blackwell GB200/GB300 |
• 出口中国需美国许可;目前没有任何报告。
Hopper指纹无法区分H800、H100 SXM或H200;上述H800识别为实验室披露,非该方法的发现。
主要发现
-
来自四个中国实验室的六个型号被认为是Blackwell训练的。 DeepSeek-V4-Flash和MiniMax-M3与NVIDIA的Blackwell级B200或B300芯片匹配,后者拥有148个处理器核心(称为流式多处理器,SMs)。DeepSeek-V4-Pro、Kimi K3、Kimi K3.1-Pro 和 Ling-3.1-flash 与 GB200 或 GB300 芯片相匹配,这些芯片同样属于 Blackwell 级,拥有 152 个处理器核心。Kimi K3.1-Pro 与 K3 从同一种子起步,经过进一步训练,可能会成为 K3 的检查点。
-
中国实验室最近才开始在Blackwell上训练。 DeepSeek的模型显示为Hopper训练,通过DeepSeek-V3(2024年12月发布),以及Blackwell,均为DeepSeek V4(2026年4月发布)的训练。Moonshot的模型在Kimi K2.5(2026年1月)期间为Hopper,从K3(2026年7月)开始为Blackwell。一款Moonshot模型介于此之间:Kimi K2.7-Code,比K3早六周发布,基于Hopper时代的配重,但包含一小部分与B200或B300匹配。MiniMax的型号在M2.7(2026年4月)之前分别为Hopper,以及从M3(2026年6月)起为Blackwell。Ant Group的Ling-3.0闪电(2026年8月)读作Hopper,而其Ling-3.1闪电(2026年10月)读作Blackwell。Hopper读数无法识别特定芯片:H800、H100 SXM和H200共享相同的指纹。
-
并非所有中国AI实验室都转用Blackwell。我们能读取到的最新模型来自阿里巴巴(Qwen)、智浦(GLM)、腾讯、小米和StepFun,都显示为Hopper训练。美团表示,其LongCat-2.0完全基于“AI ASIC超级单元”训练,我们在其发布的型号权重中未发现NVIDIA的痕迹。
-
该方法正确回答已知答案。 对于24款具体型号,开发者公开说明了所使用的硬件。在所有情况下,我们的方法都与公开公告一致。英伟达自家的Nemotron-3 Ultra,其技术报告中将GB200命名为训练的一个阶段,显示为152个SM,与Kimi K3相同。
-
匹配远比偶然解释的更强。 即使无关的数字,在尝试足够多组合时也可能看起来匹配。在我们搜索中大约6万亿种种子和布局组合中,最强的概率匹配预期约为8西格玛——衡量结果高于普通随机变异的程度。六个模型中最强的证据范围为49到1385西格玛。即使是我们报告的最弱个人测试,也达到了20西格玛。
-
训练运行规模为数据中心级别。 根据每个模型的规模和训练数据量,我们估计每次运行大约需要500到3,000个Blackwell GPU,持续两到三个月(见表2),假设每个模型都是在初始化它的硬件上训练的。应用于DeepSeek-V3的相同计算方式,得到2000到2500个芯片;DeepSeek披露了2048个。每块GPU大约7万美元——据《华尔街日报》报道,马来西亚为字节跳动安装约3.6万块Blackwell芯片的成本将超过25亿美元——其中最大的集群成本为1.5亿至2亿美元,五个集群加起来超过5亿美元。这些数据仅涵盖了最后的训练运行;实验室在出口管制GPU上的总支出可能达到数十亿美元。
表2。每次训练的大致比例 链接 ↗
| 模型 | Blackwell GPU的最佳估计 | 射程 |
|---|---|---|
| 深搜-V4-闪电 | 1,000–1,500 | 250–4,500 |
| DeepSeek-V4-Pro | 2000–2500 | 750–6,000 |
| Kimi K3 | 2000–3000 | 1,000–8,000 |
| MiniMax-M3 | 500–600 | 200–2000 |
| Ling-3.1-闪光 | 1,100–1,650 | 400–6,500 |
训练计算(约6个×激活参数×训练标记)除以芯片吞吐量,利用率为35%,运行期为两到三个月(DeepSeek-V4-Flash为六到八周)。DeepSeek公布了其代币数量;对于其他模型,我们是根据权重估算的。
我们的调查
模型的权重,也称为参数,是决定其如何处理信息并产生答案的数十亿可调数字。训练会反复调整这些数字;但在开始训练之前,他们需要初始值。在这里测试的软件中,这些数值来自一种名为Philox的伪随机数生成(PRNG)算法:Philox以确定性方式产生看似随机的数字。Philox的起始输入是一个称为“种子”的数字。在相同的种子和设置下,Philox每次产生的数字都相同。这让工程师可以从同一个起点重复实验。
为了快速完成数十亿个权重,PyTorch——大多数主要AI模型开发中使用的软件框架——将Philox的工作分配给GPU上的多个并行工作者,称为线程。(它通过 NVIDIA 的随机数生成库 cuRAND 实现了这一点。)每个线程从种子生成自己的数字序列,并填充一组特定的位置。线程数量决定了这些位置的分配方式。在此处考察的NVIDIA芯片上,足够大的初始化最多可为每个处理单元使用2,048线程,称为流式多处理器(SM)。因此,拥有更多SM的芯片会将同样的工作分配给更多工人,改变他们的数字去向。
图1展示了在简化的GPU上的工作原理,该GPU配备6个SM和8个线程,总共48个线程。想象这些砝码是一排长长的空盒子,包裹成网格以适应纸张。第一条线程填满第一个框,第二条线填入第二个框,依此类推贯穿全部48个线程。第一个线索的下一个数字进入49框,下一个进入97框,依此类推。黑色轮廓沿着这条线穿过网格:第一根线占据每48个位置。颜色表示每个数值集的处理单元,右侧面板的亮度表示该值本身。
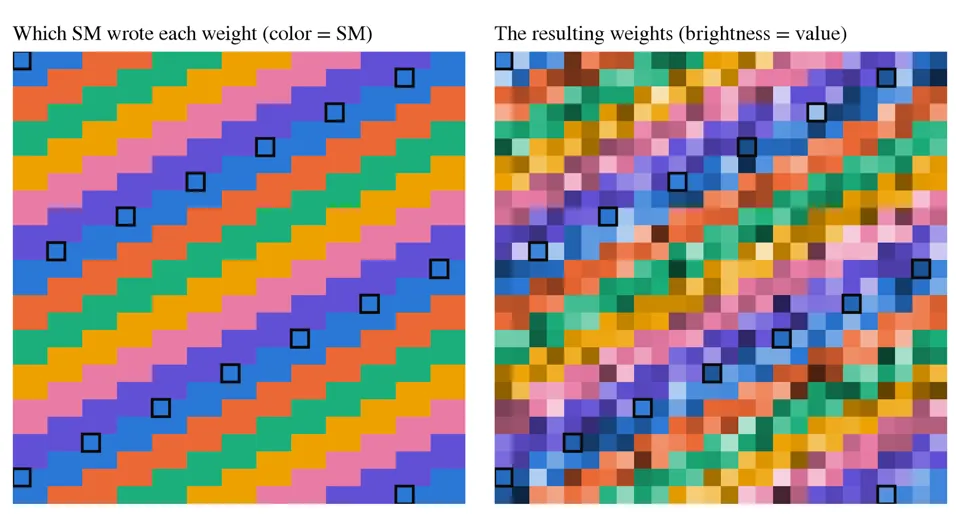
图1。GPU如何承担这些权重。这个简化示例使用了六个处理单元和每个单元八个线程,总共48个线程。轮廓分区属于线程0,该线程填满每48个位置。真实芯片使用更多螺纹,但放置规则是一样的。Link ↗
现在保持种子固定,但用的是有五个SM的GPU,而不是六个。在我们简化的例子中,这意味着40个线程,而不是48个。第一线程生成的序列完全相同,但现在将编号放在盒子1、41、81等,而不是盒子1、49、97。图2跟随这些数字的位置变化。在网格中,只有6%的数值与原始排列一致。种子是对的,但工蜂数量是错的。这就是模型配重排列成为芯片线索的原因。
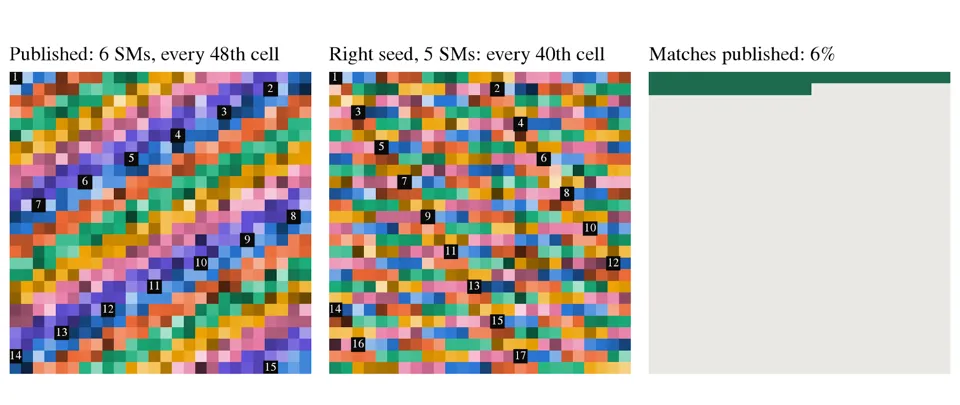
图2。同一个种子,却在不同的显卡上。在这个玩具示例中,线程0有五个处理单元和40个线程,生成相同的序列,但每40个位置填满一次,而不是每48个位置。显示矩阵中只有6%与原始排列一致。Link ↗
因此,重现权重需要两点同时正确。种子必须产生正确的数字,线数也必须将它们放在正确的位置。错误的种子线数错误,通常会给出错误位置的正确数字;正确的线数但种子错误,会得到不同的数字。图3展示了为什么只有正确的组合才能重现原始排列。
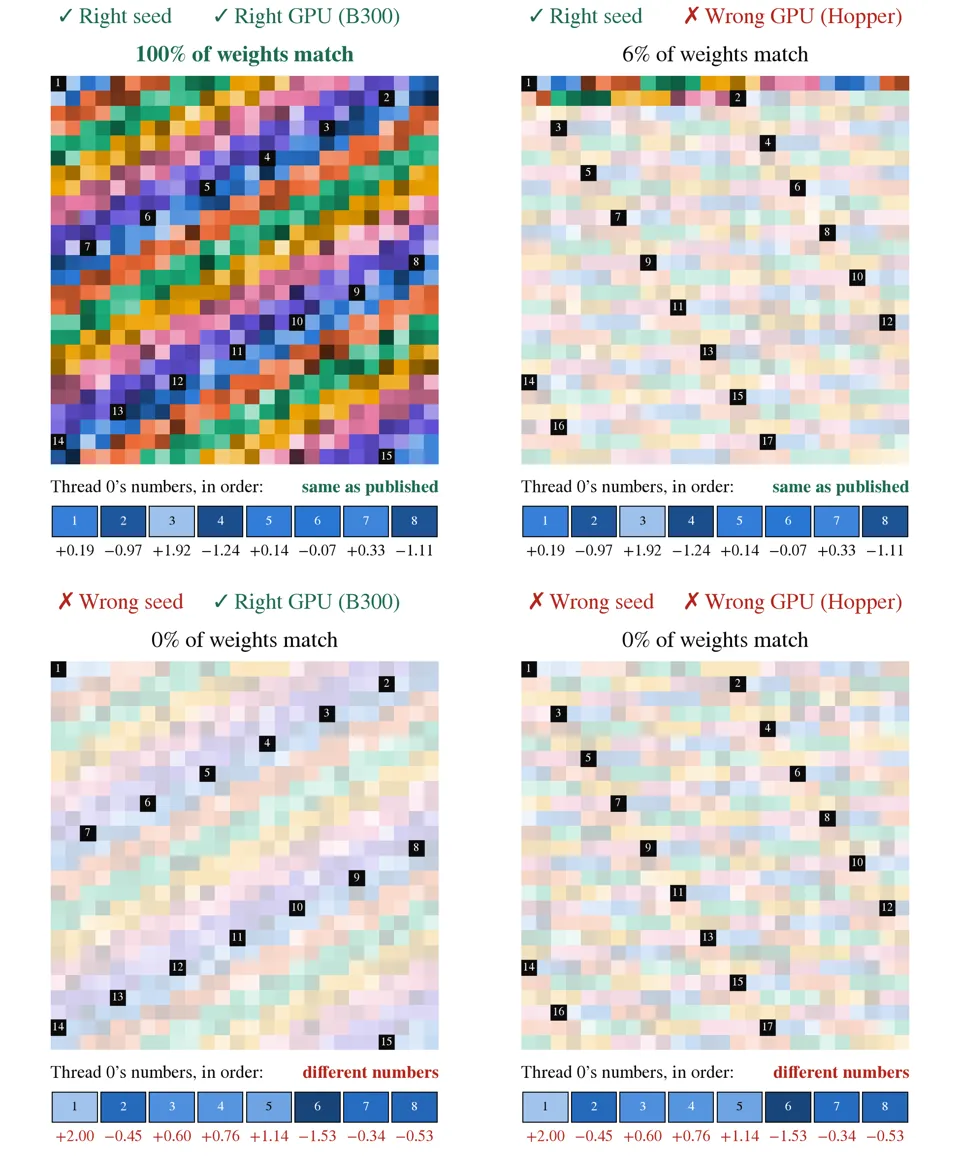
图3。种子和布局必须一致。只有当种子和线数都正确时,原始矩阵才会被复制。换掉任何一个都会毁掉大部分比赛。简化芯片代表Blackwell B300和Hopper H100。褪色细胞与已发表的权重不同。编号单元格显示线程0的数字落在哪里,每个面板下的条带显示数字本身。Link ↗
在真实芯片上,线数要大得多,但原理是一样的。在此处考察的 NVIDIA 配置中,Hopper H100 SXM、H200 和 H800 有 132 个 SM,使用 270,336 个线程;Blackwell B200/B300 拥有 148 个 SM,使用303,104个螺纹;Blackwell GB200/GB300 拥有 152 个 SM,使用 311,296 个线程。因此,恢复线程计数可以告诉我们这些硬件组中哪个与起始排列相符,尽管它无法区分组内的芯片。例如,Hopper匹配无法区分H800和H100或H200。
问题是,这种布置是否能在训练中存活下来,让我们能够恢复。有些权重,比如训练中未曾遇到的词语或符号,可以保持原值,几乎保持其起始值。我们可以直接将这些保留值与候选种子和线程计数生成的起始值进行比较。图4展示了这样的对比:DeepSeek-V3保存的权重与Hopper排列一致,而DeepSeek-V4-Flash的重量与Blackwell排列一致。
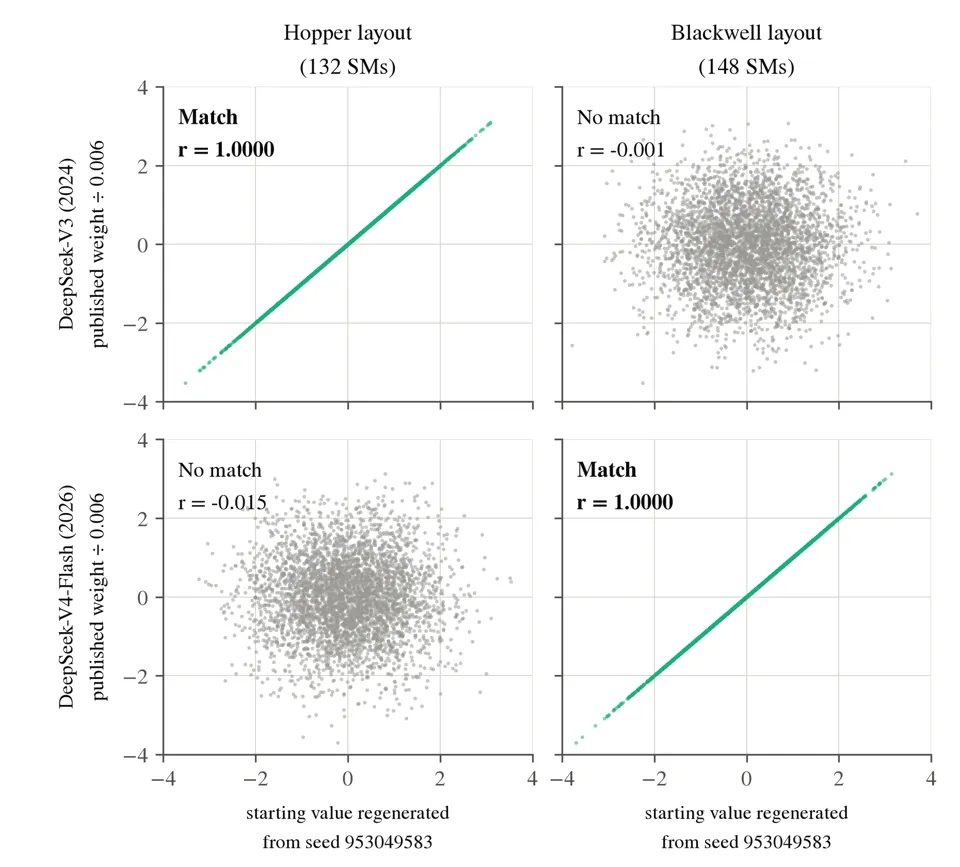
图4。保留的起始值揭示了布局。每个点将已公布的权重与从种子重生成的值进行比较。斜线表示数值相匹配。DeepSeek-V3 与 Hopper 布局一致,而 V4-Flash 则与 Blackwell 布局一致。面板显示每个模型保存的四行共计4,096个数值。Link ↗
即使是训练中改变过的重量,也可能保留起始数值的微弱痕迹。每个最终重量都是起始值加上训练中所做的所有调整。如果这些调整不能完全抵消或压倒起始差异,部分差异仍然存在。例如,两个权重起始于0.2和0.8,且各自增加约0.1,之后排序方式相同。实际调整差异更大,所以一个重量告诉我们信息很有限。但在数十万个权重中,我们可以检验更高的起始值是否仍然倾向于更高的最终值。图5显示了这种弱但可测量的关系。这是这些重量的发现,而非保证每次训练都能坚持下来。
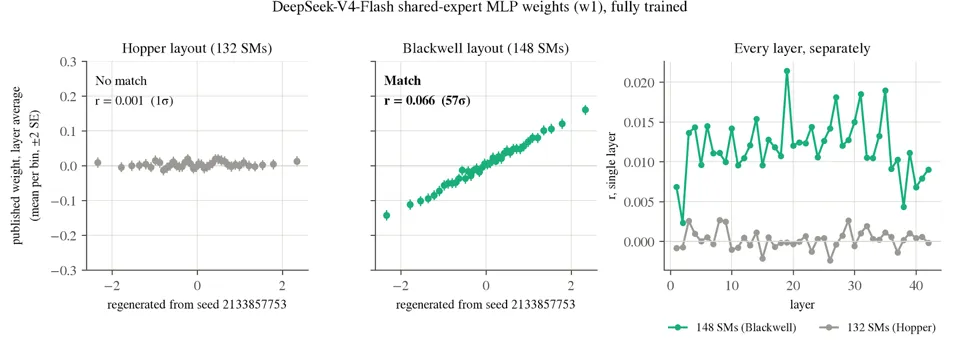
图5。训练有素的哑铃会保留较弱的痕迹。左侧和中间面板平均每层745,472个重量,分布在42层DeepSeek-V4-Flash中。在布莱克韦尔布局下,较高的起始值仍能预测略高的最终值(r = 0.066,57西格玛);在霍珀的领导下,这段关系消失了。右侧面板展示了单个层次中较弱的证据。Link ↗
这些幸存的痕迹让我们能够倒推。假设在一个虚构的例子中,使用图1的布局,种子7使第一线程分别产生0.2、−0.5和0.8。在48个线程中,这些值分别位于位置1、49和97;40根线头时,它们分别进入1、41和81号位。如果已发布的权重保留了第一个图案,我们可以尝试候选种子和线数,直到重新创建。在实际调查中,我们比较了数千个对应位置的数值。未动的重量可以完全匹配;训练过的权重可能只表现出上述较弱的相似性。无论哪种情况,我们都寻找最能再现现存模式的组合。
然后我们用未纳入搜索的权重测试该组合。我们用一组权重选定种子和线数后,用它们预测另一组权重的起始值,不更改任何设置以提升拟合度。对这些之前未使用的权重进行匹配,比仅局限于帮助我们选择组合的权重匹配更有力。图6展示了对比:DeepSeek-V3与Hopper H100 SXM、H200或H800芯片的初始化布局相匹配;DeepSeek-V4-Flash 匹配 Blackwell B200/B300;Kimi K3则匹配Blackwell GB200/GB300。
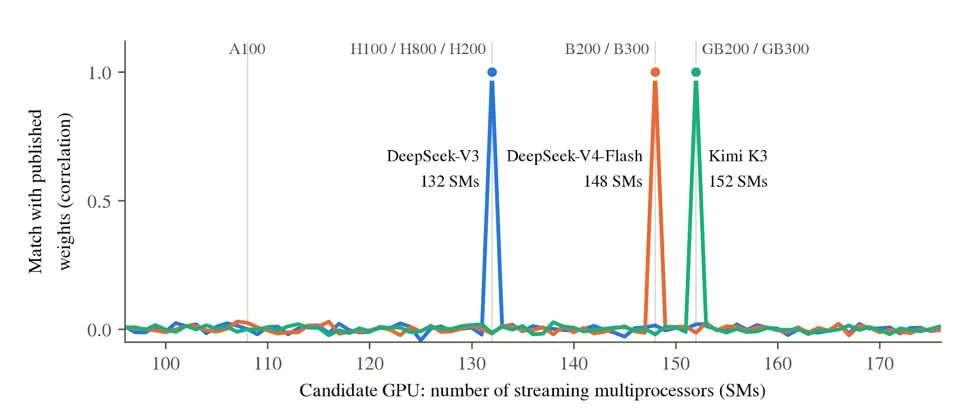
图6。比较候选人布局。每个型号都有一个清晰峰值:DeepSeek-V3 132 SM,V4-Flash 148 SM,Kimi K3 152。其他测试布局得分接近零。Link ↗
在我们的调查中,我们发现来自四家中国公司的六款Blackwell芯片上存在强烈的初始化模式:DeepSeek的DeepSeek-V4-Flash和DeepSeek-V4-Pro,Moonshot AI的Kimi K3和Kimi K3.1-Pro,MiniMax的MiniMax-M3,以及Ant Group的Ling-3.1-flash。V4-Flash和MiniMax-M3与148-SM布局一致;其余四台与152-SM布局一致。这些是起始权重的指纹,这些指纹支持但本身并不能证明使用Blackwell芯片训练AI模型。
我们调查的局限
值得注意的是,我们用来识别这些模型初始化硬件的取证方法仅适用于特定型号。它需要公开权重,因此封闭模型无法被检查。它还需要软件生成起始权重时,提供一个可识别的、依赖硬件的模式。这里研究的GPU上的PyTorch也形成了这种模式;百度用于训练ERNIE-5.5模型的PaddlePaddle框架则不支持。我们成功恢复了 ERNIE-5.5(2760)的种子,但无法确定初始化时使用的硬件。同样,在普通处理器上初始化的权重而非GPU上不会留下GPU指纹;阿里巴巴的几款Qwen3型号就是这样初始化的,因此没有留下任何用于训练GPU的痕迹。我们也未在美团的LongCat-2.0中发现指纹,该公司称其使用“AI ASIC超级单元”训练,或在DeepSeek-V4.1-Flash中,尽管进行了详尽搜索。
该方法识别的是生成起始权重的硬件,而非后来帮助训练模型的每颗芯片。当训练运行在训练的GPU上创建权重时,指纹会指向两者。但实验室可以在一个系统上生成权重并迁移到另一个系统,或者在新硬件上继续训练现有模型。仅凭权重无法排除这些可能性。混合簇也带来了同样的限制。如果NVIDIA芯片产生了一些权重,华为芯片后来帮助训练它们,NVIDIA的模式就能在不暴露华为参与的情况下存活下来。不同世代的NVIDIA可能会在它们初始化的部件中留下不同的痕迹,如果这些痕迹仍然存在的话。在Kimi K3中,至少有64个独立种子的过程各自留下相同的152-SM布局。因此,Blackwell 兼容的模式支持初始化时使用,前提是 AMD 的替代方案如下;但并未证明整个训练运行均使用布莱克韦尔。霍珀模式同样不排除后续在布莱克韦尔训练的可能性。
权重也无法显示芯片的归属或存放位置。Blackwell系统可从中国以外的数据中心租赁。证据涉及对硬件的访问;单凭此案,并不能证明芯片被走私进入中国或存在出口管制违规。
不同的芯片能否产生这些与Blackwell兼容的图案?在本次测试的NVIDIA配置中,老款芯片无法做到:软件能使用更少的处理器,但无法提供超过物理能力的处理器。根据这里测试的标准PyTorch行为,它们无法生成148或152-SM的布局。中国市场的Blackwell显卡每个SM使用的不同线程数,且不产生任何一个总数。
AMD则提供了另一种可能性。MI300X通常使用304个处理单元,但可以分为两组,每组152个,或配置为仅使用148个。它的随机数软件也能生成与NVIDIA相同的底层序列。这种配置非常罕见,但我们在实体MI300X上确认,它仅限152或148台,还原了我们对Blackwell的布局,因此仅凭布局并不能解决问题。
为了区分它们,我们寻找数值本身的细微数字差异。AMD和NVIDIA在计算数值过程中的计算方式略有不同。在实体MI300X上,DeepSeek-V4-Flash保存的权重指向NVIDIA:在377个数值中,两家厂商结果不同的权重与NVIDIA一致,AMD在363个权重中完全一致。同样的测试无法确定其他五款型号,但我们认为AMD对它们的解释非常不太可能。在正常配置下,MI300X 不产生这两种布局;实验室必须配置整个集群以使用与Blackwell芯片相同的处理单元数量。其他公开证据也指向Blackwell:美国官员和媒体报道称DeepSeek和Moonshot AI使用了Blackwell芯片,Ant集团的公开代码中包含基于GB300生成的基准测试结果。
验证我们的发现
为了重现将DeepSeek-V3与Hopper及DeepSeek-V4-Flash与Blackwell联系起来的结果,我们在一台Hopper级NVIDIA H100和一台Blackwell级NVIDIA B300上运行了未经修改的PyTorch。我们已确认DeepSeek的种子编号为953049583,并发现它被用于DeepSeek-V3和DeepSeek-V4-Flash的初始化。利用该种子,H100 还原了 DeepSeek-V3 中保存的起始值,但未复现 V4-Flash;B300 在 V4-Flash 中还原了保留值,但没有 V3。** 在 B300 上,未经修改的 PyTorch 在 DeepSeek-V4-Flash 中还原了 461 行选中的 461 行,相关性高于 0.99,其中包括 445 行位对比特匹配。八排选拔部分通过训练进行了调整。在 H100 上,它在 DeepSeek-V3 中逐位复现了全部 57,344 个保存值。两颗芯片都无法重现另一款保留的行数。将种子改为一后,两台机器都没有匹配的行。在租来的GB200上,未经修改的PyTorch同样用Moonshot的种子20256586重现了Kimi K3保存下来的全部13行;更换种子后,没有繁殖。
我们的法医方法也能在答案已知时得到正确答案。有24个案例中,开发者公开了某个特定型号背后的硬件名称;我们的法医方法与所有人一致。Meta的Llama 3.1型号,在H100上训练,读数为132;EleutherAI的八个Pythia模型,在A100上训练,显示为108。NVIDIA自家的Nemotron-3 Ultra,其技术报告中GB200用于某一训练阶段,显示为152,与Kimi K3相同。DeepSeek和Moonshot报道早期型号使用H800。我们的Hopper读数与上述披露一致,同时也与H100 SXM或H200硬件一致;他们并不独立验证H800的使用情况。
当我们将公布的权重与候选种子和芯片布局生成的数字进行比较时,即使候选者错误,也不可避免地存在某种相似性。相似度的证据程度取决于我们比较的权重数量:少数数字的一致很可能是偶然,而数千个数字的一致性则更难靠偶然解释。我们的统计模型考虑了被比较的权重数量,并衡量观察到的匹配超出偶然预期相似度的程度。我们用标准差或σ来表示这个距离。得分越高,只要统计模型正确描述数据中的随机变异,对偶然匹配的证据越强。
我们还必须考虑我们尝试了多少候选人。搜索大约六万亿种种子和布局组合,给了我们数万亿次机会找到幸运匹配。在正态分布模型下,五西格玛或更高的正匹配大约是每350万次比较中偶然出现一次。这在单一测试中很惊人,但在我们这样大规模的搜寻中也不足为奇。因此,我们以大约八西格玛作为评估全搜索中偶然匹配的基准。
我们的发现远远超过该基准。 我们首先用一组权重选择种子和布局,然后在另一组权重上测试同一组合,而该组权重并未参与选择。这会检查表面上的指纹是否超出了引领我们找到它的数字。六个模型中最强的证据范围为49至1385西格玛;即使是最弱的个人测试,也达到20西格玛。在我们的统计模型下,这些结果太强,无法归因于偶然相似。它们建立了共享初始化模式的证据;确定具体是哪种计算硬件产生了该模式,以及它是否也执行了训练,需要上述单独的论证。
结局
基于我们的法医调查,我们相信我们有强有力证据表明六个中国AI模型是在出口控制的NVIDIA硬件上初始化的,而对于DeepSeek-V4-Flash,证据是确凿的;我们认为这种初始化也强烈表明他们是在相同的出口管制硬件上进行训练的。虽然这还留下了许多未解之谜——比如开发这些模型的公司是通过何种情况获得出口管制的NVIDIA系统的——但我们认为这一事实值得公众紧急关注。
附录1:各中国实验室硬件随时间变化 各实验室连续型号的硬件指纹。
DeepSeek 在模型世代间重复使用同一个种子,Moonshot 用一条规则推导种子,这样我们可以跟踪每个实验室的硬件从一个模型到另一个模型。日期是权重公布的时间。
| 模型 | SMs | 硬件类别 | 出口中国 | 证据 |
|---|---|---|---|---|
| 深度搜寻 | ||||
| V2轻型,MoE-16B | 108 | A100 / A800(安培) | A800有效至2023年11月 | 完全一致 |
| LLM 7B/67B,Coder,V2,V3(2024年12月),V3.2 | 132 | H100 / H800 / H200(料斗) | 芯片未识别 | 完全一致;V3 239σ |
| V4-闪电(2026年4月) | 148 | B200 / B300(布莱克韦尔) | 需持证;无报告 | 精确复制,1,385σ |
| V4-Pro(2026年4月) | 152 | GB200 / GB300(Grace-Blackwell) | 需持证;无报告 | 部分存活,49σ |
| 登月AI | ||||
| Kimi K2(2025年7月) | 132 | H100 / H800 / H200(料斗) | 芯片未识别 | 部分存活率,292σ |
| 月光-16B;Kimi-Linear(2025年10月) | 132 | H100 / H800 / H200(料斗) | 芯片未识别 | 完全一致;Kimi-线性 763σ |
| Kimi K2.5(2026年1月) | 132 | H100 / H800 / H200(料斗) | 芯片未识别 | 未训练行,r 0.9975,255σ |
| Kimi K2.7-Code(2026年6月) | 132,加上一个148-SM零件 | 料斗,加上一个与B200 / B300匹配的第二源 | 混合 | 148部分:254行,去除132部分后为246σ |
| Kimi K3(2026年7月),K3.1-Pro(2026年11月) | 152 | GB200 / GB300(Grace-Blackwell) | 需持证;无报告 | 精确复制,每个305σ |
| MiniMax | ||||
| 文本-01(2025年1月),M1,M2至M2.7(2026年4月) | 132 | H100 / H800 / H200(料斗) | 芯片未识别 | 未经训练的划船;2048个网格之一 |
| M3(2026年6月),M3.1-Flash(2026年10月) | 148 | B200 / B300(布莱克韦尔) | 需持证;无报告 | 完全相同的复制品,323σ |
| 蚁群 | ||||
| Ling-1T†(2025年10月)、Ling-3.0-flash(2026年8月) | 132 | H100 / H800 / H200(料斗) | 芯片未识别 | 未训练划船,r0.98;345σ, 193σ |
| Ling-3.1-flash(2026年10月) | 152 | GB200 / GB300(Grace-Blackwell) | 需持证;无报告 | 未训练行,r 0.98,244σ |
| 其他实验室 | ||||
| GLM-5.3(志浦),Qwen3.8(阿里巴巴) | 132 | H100 / H800 / H200(料斗) | 芯片未识别 | 部分存活率,46σ,478σ |
| Hy4-预览(腾讯),第五步预览(StepFun) | 132 | H100 / H800 / H200(料斗) | 芯片未识别 | 精确复制品,每个256σ |
| 小米V2.5-Pro,Qwen3.5-397B(阿里巴巴) | 132 | H100 / H800 / H200(料斗) | 芯片未识别 | 部分存活率,41σ,323σ |
如何阅读证据栏。完全一致:训练未更新的权重以相关系数(r)大于0.999重现生成值。未训练行:同样适用于起始值被裁剪或四舍五入的模型,这会降低r值。部分存活:训练有素的重量保持部分起始数值。网格扫描中的数据使用了搜索中保留的单元格。即使搜索了每个32位种子和每个网格,Chance也无法达到8σ;在六个Blackwell结果中,基于V4-Flash训练有素的注意力权重,最低的是20σ。
† 一次分析结果,尚未重演。
Kimi K2.7-代码。其254行保留数据是两种来源的混合:约80%是继承自K2.5的Hopper布局值,约20%是与148-SM布局相匹配的新抽取值。每行的混合都相同,这表明检查点已合并,而非混合硬件;K2.7-Code 不计入六款 Blackwell 型号。
公共规范。Ant Group 的 cuLA 库包含了 2026 年 3 月 31 日在 GB300 上生成的基准测试结果。2025年6月,一位DeepSeek工程师在GitHub上写道:“我们没有SM100 GPU”(SM100是Blackwell的)。
附录2:所有型号均已识别完整型号目录、披露硬件及证据笔记。
我们的数据与所有24个开发者公开说明特定型号硬件的情况一致:21个来自我们最初调查的案例,加上Kimi K2.5(H800)、Step-3.5-Flash(H800)和ZAYA1(AMD MI300X)。其中11个是零步检查点,相关模型并非独立,因此这是一致性检查,而非测量准确率。“未找到”意味着对型号卡片、纸张和存储历史的搜索未发现任何硬件相关信息。
| 模型 | 签名 | 开发商 | 公开披露的硬件 | 同意 | 出口状况(中国) |
|---|---|---|---|---|---|
| 中国 | |||||
| DeepSeek-V4-闪电,-基础 | 148:B200/B300 | 深度搜寻 | 未披露 | — | 需要执照² |
| DeepSeek-V4-Pro-Base | 152:GB200/GB300 | 深度搜寻 | 未披露 | — | 需要执照² |
| Kimi K3;K3.1-Pro(同种子) | 152:GB200/GB300 | 登月发射AI | 未披露 | — | 需要执照² |
| Ling-3.1-闪光 | 152:GB200/GB300 | 蚁类群 | 未找到 | — | 需要执照² |
| MiniMax-M3;M3.1-Flash(同一初始化) | 148:B200/B300 | MiniMax | 未找到 | — | 需要执照² |
| Kimi K2.7-Code | 132,加上一个148的部分⁵ | 登月发射AI | 未找到 | — | 未解决⁴ |
| 基米K2.5;K2.6(同一init) | 132:霍珀 | 登月发射AI | H800 | 是的 | 未解决⁴ |
| Kimi-线性-48B | 132:霍珀 | 登月发射AI | 未找到 | — | 未解决⁴ |
| Kimi K2-Base | 132:霍珀 | 登月发射AI | H800 | 是的 | 未解决⁴ |
| 月光-16B-A3B | 132:霍珀 | 登月发射AI | 未披露 | — | 未解决⁴ |
| DeepSeek-V3-Base;V3.2(同一init) | 132:霍珀 | 深度搜寻 | H800 | 是的 | 未解决⁴ |
| 深搜-V2 | 132:霍珀 | 深度搜寻 | H800(报告范围) | 一致性¹ | 存在合规变体³ |
| DeepSeek-Coder-1.3B | 132:霍珀 | 深度搜寻 | A100 和 H800(报告范围) | 一致性¹ | 存在合规变体³ |
| DeepSeek-LLM-7B,67B | 132:霍珀 | 深度搜寻 | 原始连载未披露 | — | 存在合规变体³ |
| 深寻-MoE-16B | 108:A100/A800 | 深度搜寻 | A100 或 H800(报告全域) | 一致性¹ | 存在合规变体³ |
| DeepSeek-V2-Lite | 108:A100/A800 | 深度搜寻 | H800(报告范围) | 共享初始 | 存在合规变体³ |
| Ling-3.0-闪光 | 132:霍珀 | 蚁类群 | 未找到 | — | 未解决⁴ |
| Ling-1T;Ling-2.6-1T(同一初始化)† | 132:霍珀 | 蚁类群 | 霍珀(报告全域) | 一致性¹ | 未解决⁴ |
| GLM-5, 5.1, 5.2, 5.3(一次初始化) | 132:霍珀 | 智浦AI | 未披露 | — | 未解决⁴ |
| GLM-5.3-闪光 | 132:霍珀 | 智浦AI | 未找到 | — | 未解决⁴ |
| GLM-4.5-基础;GLM-4.7(同一初始化)† | 132:霍珀 | 智浦AI | 未找到 | — | 未解决⁴ |
| Qwen3.8-2.4T-A95B | 132:霍珀 | 阿里巴巴 | 未披露 | — | 未解决⁴ |
| Qwen3.5-397B-A17B | 132:霍珀 | 阿里巴巴 | 未找到 | — | 未解决⁴ |
| Hy3-preview;Hy3(同一初始化) | 132:霍珀 | 腾讯 | 未找到 | — | 未解决⁴ |
| Hy4预览 | 132:霍珀 | 腾讯 | 未找到 | — | 未解决⁴ |
| MiMo-V2-闪光灯;MiMo-V2.5-Pro | 132:霍珀 | 小米 | 未找到 | — | 未解决⁴ |
| 第5步预览 | 132:霍珀 | StepFun | 未找到 | — | 未解决⁴ |
| 步骤3.5-闪光;步骤3.7-闪现(同一初始化) | 132:霍珀 | StepFun | H800(第3.5步闪光灯) | 是的 | 未解决⁴ |
| MiniMax-M2、M2.1、M2.5、M2.7(一个初始化) | 132:霍珀 | MiniMax | 未找到 | — | 未解决⁴ |
| MiniMax-Text-01、VL-01;M1(一个初始化) | 132:霍珀 | MiniMax | H800(报告范围) | 一致性¹ | 未解决⁴ |
| 种子-OSS-36B-基底 | 108:A100/A800 | 字节跳动 | 未找到 | — | 存在合规变体³ |
| 易-34B | 108:A100/A800 | 01.AI | 未披露 | — | 存在合规变体³ |
| 美国 | |||||
| 羊驼3.1 8B, 70B, 405B | 132:霍珀 | Meta | H100 | 是的 | 无 |
| Nemotron-3-Ultra-550B | 152:GB200/GB300 | NVIDIA | GB200(单相) | 一致性 | 无 |
| 尼莫托隆-4-340B-基地 | 132:霍珀 | NVIDIA | H100 SXM5 | 是的 | 无 |
| ZAYA1-74B-预览 | 304 CU:AMD MI300X | 齐弗拉 | AMD(据其博客介绍 MI300X) | 是的 | 无 |
| OLMo-2 32B,奥尔莫-3 32B | 132:霍珀 | AI2 | H100 | 是的 | 无 |
| OLMo-7B | 108:A100 | AI2 | A100 | 是的 | 无 |
| OLMo-7B-双2T型 | 110 CU:AMD MI250X | AI2 | AMD MI250X | 是的 | 无 |
| OLMo-7B-0424,OLMo-1B-0724 | 132:霍珀 | AI2 | 未披露 | — | 无 |
| 皮提亚70M–12B(8个型号) | 108:A100 | EleutherAI | A100 | 是的(全部8个) | 无 |
| GPT-NeoX-20B | 108:A100 | EleutherAI | A100 | 是的 | 无 |
| 欧洲 | |||||
| Apertus-70B | 132:霍珀 | 瑞士人工智能 | GH200(Hopper,132 SMs) | 是的 | 无 |
| Mixtral-8x7B | 132:霍珀 | 密斯特拉尔人工智能 | 未披露 | — | 无 |
| BLOOM-176B(部分签名) | 108:A100 | 大科学 | A100 | 是的 | 无 |
¹ 报告范围披露。DeepSeek-V2和V2-Lite共用一个“H800集群”句子,MoE-16B表示“A100或H800”,编码器表示“A100和H800”。MiniMax的MiniMax-01论文描述了一组H800,Ant Group的Ling 2.0报告称其训练基于“Hopper GPU”。这些测试与我们的读数一致,但并非独立测试。V2-Lite 重复使用 MoE-16B 的初始化:它们保留的行字节相同。
² 需执照。B200、B300、GB200和GB300自出货前就需要美国对中国出口许可,但目前尚未报告相关情况。AMD MI300X 也被控制。
³ 存在顺从的变体。A100/H100型自2022年10月起受控,但A800和H800因SM数量相同,可出口至2023年10月。
⁴ 未解决的料斗硬件。这些型号自2024年12月起首次发布,显示132-SM指纹,兼容H800、H100 SXM或H200硬件。DeepSeek和Moonshot报告部分型号使用H800芯片,但指纹无法区分这些芯片。模型的发布日期无法确定其硬件何时何地获得,单凭这一数据也无法确定其是否符合出口管制。
⁵ 148分。详见成绩表下的Kimi K2.7-Code说明。
† 由一项分析报告,尚未独立重新运行。在本简报中,每增加一行,第一个被命名的模型会独立重播;列出的与其初始化相同的模型则不然。
这些旗帜描述了2022年10月和2023年10月美国出口规则下的硬件类别。它们并不是认定任何法律被违反。
没有恢复任何显卡特征。空白页并不能说明模型的硬件。经过详尽搜索,我们未从DeepSeek-V4.1-Flash、Qwen3.5-122B、Qwen3.8-Flash-Next、Qwen3-0.6B和1.7B、gpt-oss-120b和Grok-1中恢复任何签名。Qwen3-235B、Qwen3-32B 和 Qwen3.5-9B 在 CPU 上初始化,因此没有 GPU 布局。百度的ERNIE-5.5使用PaddlePaddle,其发电机无芯片布局(我们已恢复其种子2760);ERNIE-4.5 没有结果。美团的LongCat-2.0没有任何结果。其模型卡显示训练“完全在AI ASIC超级单元上运行”,而现已删除的微调配置将device_arch为910,带有NPU和HCCL选项,我们理解为华为Ascend 910。Intern-S2基于阿里巴巴Qwen3.5-397B构建,并承载其初始化。DBRX和Llama-4-Scout无法下载。
可用性。复刻脚本、行灯具和测试输出可应审核员请求提供。
联系人:威尔·德普,[email protected]。
资料来源
- 《The Information》,2025年12月10日,关于DeepSeek和Blackwell(来源:彭博社)。
- 路透社,2026年2月23日,“中国DeepSeek在英伟达最佳芯片上训练的AI模型,尽管美国禁令,官方称”(联合发行版)。
- Michael Kratsios,白宫OSTP主任,2026年7月22日,关于Moonshot AI(来自彭博社)。
- 《华尔街日报》,2026年3月,关于马来西亚为字节跳动使用的Blackwell芯片(来自路透社)。
- DeepSeek工程师的GitHub评论,2025年6月12日:DeepGEMM 拉取请求112。
- 蚂蚁集团GB300基准结果,2026年3月31日:cuLA,BENCHMARK_GB300.md.
- 美国出口许可规则:15 CFR 742.6。
- 公开硬件:DeepSeek-V3技术报告;Kimi K2 paper;Nemotron-3 Ultra技术报告。
- PyTorch 代码,用于设置线程布局:DistributionTemplates.h.
- 模型权重:DeepSeek-V3, V4-Flash, V4-Pro, Kimi K3, K3.1-Pro, MiniMax-M3, Ling-3.1-flash。
如何引用本报告
建议引用:
Will DePue,《中国顶级前沿AI模型带有出口控制的英伟达Blackwell GPU的痕迹》,Unemployment Labs,2026年11月12日,https://unemploymentlabs.com/checkpoint-forensics。
BibTeX:
@techreport{depue2026blackwell,
  author      = {DePue, Will},
  title       = {{Top Chinese Frontier AI Models Carry the Fingerprint of Export-Controlled NVIDIA Blackwell GPUs}},
  institution = {Unemployment Labs},
  year        = {2026},
  month       = nov,
  url         = {https://unemploymentlabs.com/checkpoint-forensics}
}
在新闻报道中,请将调查结果归功于威尔·德普,并链接至本页。