DeepSeek 开源 DeepInfer 推理栈,宣称日处理 155T Token
DeepSeek 在 PyTorch Conf 上开源了生产级推理栈 DeepInfer,基于 vLLM 定制并支持长达 72 小时的 Prompt 缓存。该方案声称单集群日处理量达 155T Token,具备约 80% 的高毛利与短回本周期,直接对标闭源商业推理服务。
报道正文
本文目录18 个章节
由SerpAPI自豪呈现:今天的发布涵盖了非常广泛的内容,但你可以把这些都抓到为你的代理使用!JSON的token成本为50%。
我们上一次讨论推理屈折是在四月年,历史上大多数进展都是封闭源码十个圆谷,从Fireworks到Baseten再到Modal。
好了,是时候开源回应了。现在是**PyTorch Conf的第一天,DeepSeek通过开放源源DeepInfer**——他们的生产堆栈——将一枚洲际弹道导弹及时插入讨论,该技术栈能够在12小时上缓存至OpenAI刚刚宣布的[12小时]()中:
这是他们的vLLM定制版,署名SGLang和TRRTLLM,但新增 https://x.com/zephyr_z9/status/2112510214109032829/photo/1 了很多内容......去掉他们的王冠珠宝——他们超优化的KV缓存(紧凑+>+8小时寿命)、PD/分配和负载均衡(他们的3FS之前开源了)。我们翻译了他们的博客文章,并在这里发布了,并附上了完整的研究指南和解释、codemap和子系统指南:
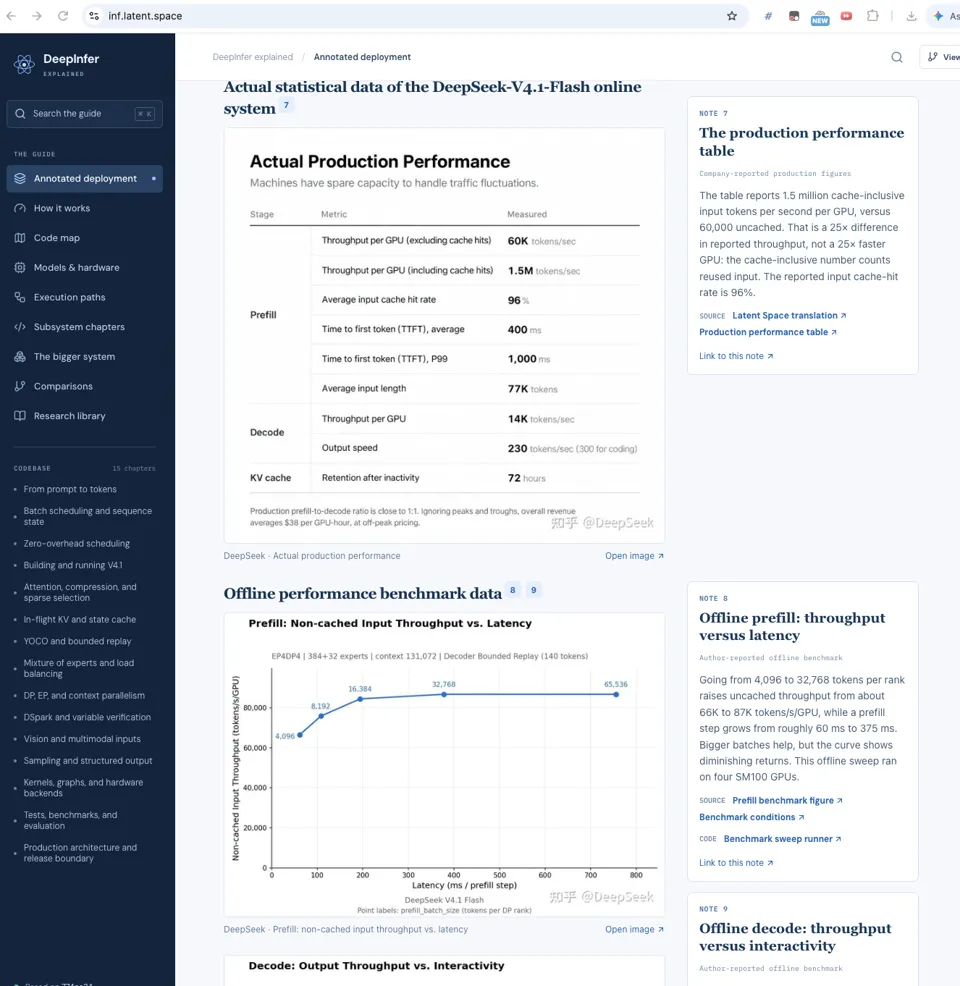 ](
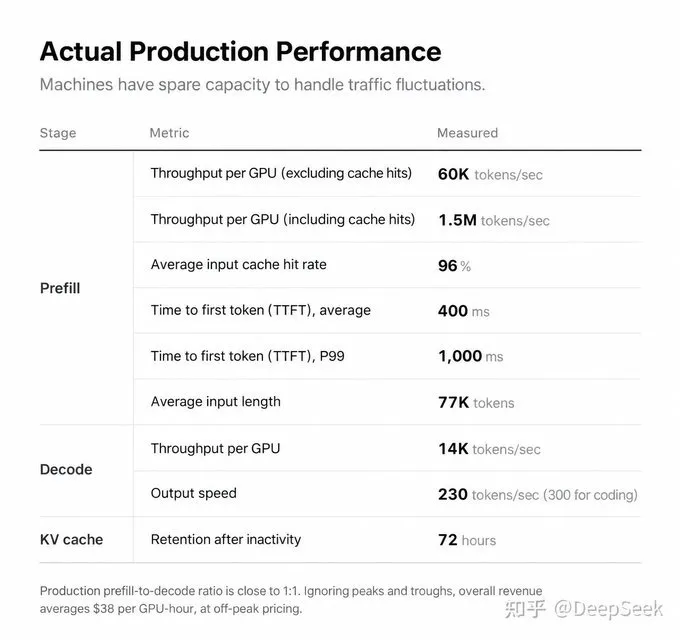
正如我们在补充披露中指出的(https://x.com/swyx/status/2112587397380943953),**他们声称每天提供155万吨代币,因此每张SM100/A950卡每小时在[非高峰期](https://api-docs.deepseek.com/quick_start/pricing/?tool=deepseek)**获得38美元(目前每百万个输入/输出代币0.15美元/0.60美元:15500000000枚 * 0.14美元混合成本/24小时为每小时100万美元)。以他们的生产数据(我们翻译)为例:每块预填充GPU每秒150万个包含缓存的输入标记,96%的输入缓存命中率,以及每颗解码GPU每秒14,000个输出标记(超过2400个GPU):
 ](
全押成本每张牌每小时5-8美元,相当于>80%的推理空间!
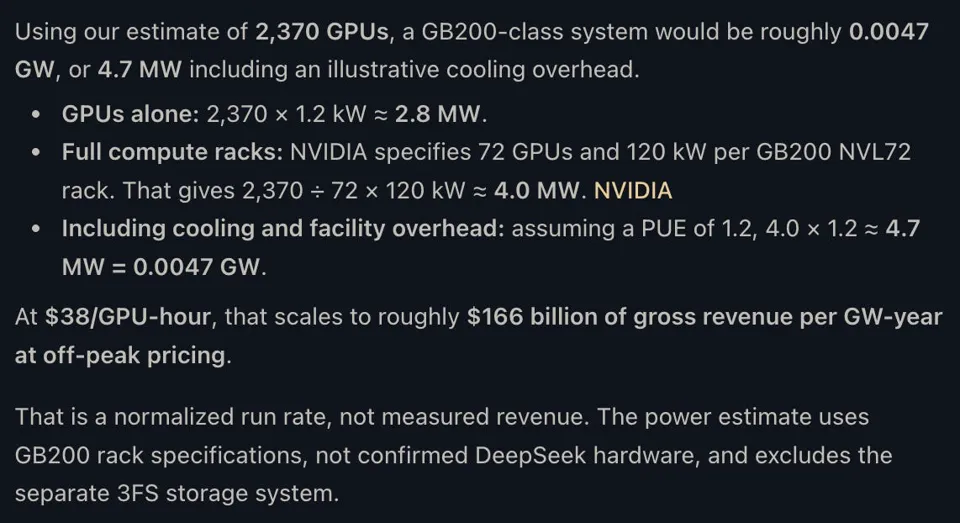
做些集群计算,大约是每 GW 1660亿美元,推理保证金回收期为 81 天(DeepSeek 著名地计划回收 10 个月)。想象一下,如果鲸鱼有更多大战士会做什么。
 ](
由SerpAPI赞助!
为你的AI代理提供更少代币的实时搜索数据
从任何 SerpApi 的 100+ API 中,以干净、结构化的 Markdown 形式 接收结果,平均使用约 50% 的令牌数。只需添加“output=md”或使用“/search.md”端点即可。它无需任何配置,且每个套餐都包含在所有套餐中,无需额外费用。
AI 推特回顾
头条新闻:DeepSeek DeepInfer——生产推理、开源边界与缓存代币的经济学
发生了什么
DeepSeek发布了DeepInfer,即V4.1 Flash背后的推理引擎,同时发布了使工程报告与代码同等重要的生产细节。
-
本次发布涵盖推理引擎和API处理层。 DeepInfer支持分布式推理、推测解码、SWA有界重放以及NVIDIA和华为Ascend平台上的结构化输出。配套的“deepseek-recipe”组件实现了生产令牌编码/解码以及官方API兼容的处理。DeepSeek表示,未来的模型推理实现和优化也将出现在该仓库中。@deepseek_ai、@deepseek_ai、公告翻译
-
报告的生产数据相当可观——但描述的是一个高度缓存的服务。 Deepseek 的工程报告(如所提供帖子中总结和引用)报告称,来自一个集群的 155 万亿个令牌/天,96% 的输入缓存命中率,400 毫秒的平均首个令牌生成时间,以及 230 个令牌/秒生成,编码达到 300 令牌/秒。此外,在非高峰期,每加速器小时收入为**$38。这些是第一方生产声明,而非独立审计的测量数据。@ZhihuFrontier,@swyx
-
“完全开源”并不意味着整个生产服务可从本次发布中复现。 尽管 DeepSeek 将 DeepInfer 描述为完全开源,但技术账号称 KV 缓存管理和负载均衡组件尚未完全发布,因为它们仍与内部基础设施耦合。发动机是打开的;重要的服务级编排仍是部署责任。@deepseek_ai,@ZhihuFrontier
-
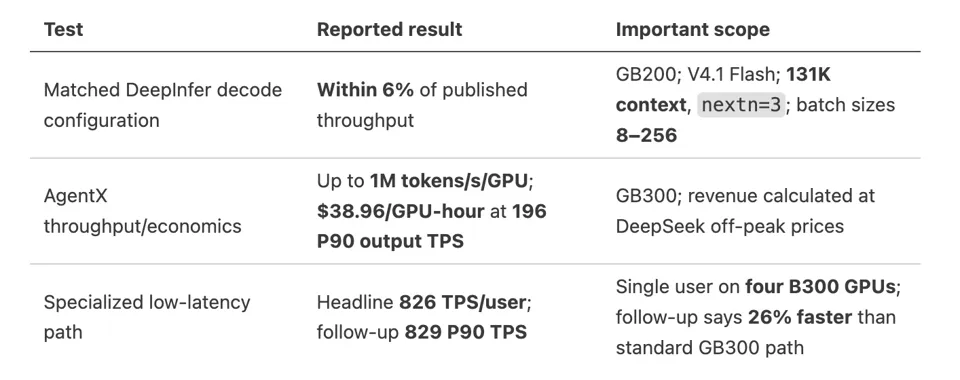
vLLM 提供了最具体的比较回答。 在承认 DeepInfer 最初主要基于 vLLM 构建并发布于 Apache 2.0 后,vLLM 团队报告称,在匹配配置下,译码吞吐量仅为 DeepInfer 发布结果的 6%。它还发布了AgentX的结果和复现配方,实质性地证明了DeepSeek效率对现有开源引擎无法达到的说法。@vllm_project、@vllm_project、繁殖资源
-
此次发布引发了两个不同的争论: DeepSeek 是否拥有独特强大的服务堆栈,以及其披露是否显示出较高的推理盈利能力。前者现在已有比较基准证据;第二部分则对工作负载结构、缓存计费、硬件成本以及包含哪些费用保持敏感。@Tim_Dettmers、@zephyr_z9、@Yuchenj_UW
架构:分阶段,调度计算而非令牌
DeepInfer 公开的架构将视觉编码、预填充和解码分离,使每个阶段能够针对自身瓶颈进行扩展。推荐的部署形态为:普通八加速器机器用于预填充和64–128加速器超节点用于解码。Decode 采用广泛的专家并行性来分配 MoE 专家,同时保持大量高效的批次。这些只是部署建议,不足以充分证明DeepSeek生产集群的硬件构成。@ZhihuFrontier
调度细节解释了为何传统的“每批代币”比较可能会遗漏重大差异:
-
预填充调度估算注意力-计算成本。 工作分配基于估计的计算长度,而非仅用原始请求长度。块大小会根据时间预算变化,而不是在异构请求中强制执行固定块大小。@ZhihuFrontier
-
预填充路由不需要缓存亲和性。 由于缓存前缀被池化在共享存储中,请求可以发送给可用的工作者,而非之前服务其前缀的工作者。在详细的中文分析中,推理工程师苏金彦强调这是一种特别有用的生产设计:预填充数据并行组在“计算令牌”上平衡,而共享存储则提供可重用状态。同一分析还强调了请求桶和使用运行时估计器的FIFO调度。@SuJinYan123
-
解码路由平衡运行请求计数和KV缓存长度。 请求计数近似调度压力;累计的 KV 长度反映了仅请求计数未被触发的内存/状态压力。工程说明描述了预填充/解码缩放信号作为预填充的汇总计算负载和执行中的解码请求。@ZhihuFrontier,@SuJinYan123
-
专家-并行负载均衡复制流行专家的做法。 副本会定期重新分发,以减少因路由偏斜引起的设备间等待。权衡是额外的HBM消耗与更高的吞吐量,随着复制次数增加,收益递减;有用的复制因子是特定工作负载的。@ZhihuFrontier,@SuJinYan123
-
CPU 调度与加速器执行重叠。 异步调度消除了解码步骤之间的空闲间隔,而不是将主机端编排视为免费。@ZhihuFrontier
一个技术上值得注意的是,公开的Blackwell构型中似乎缺乏张量平行性。一位评论者将其与默认的vLLM/SGLang配方进行对比,并将这一方法追溯到DeepSeek V3的H800时代互连约束。这是对配置的一种解释——并非张量并行性通常较差的证据。@nrehiew_
规模也很重要。苏金岩认为,广专家并行预填充需要足够的流量和工人来回报,他支持管道并行性适用于中小规模部署,且预填充工作者很少。作者还指出,层异构性会使管道划分变得复杂。这是从业者的判断,而非建立普遍交叉的标准。@SuJinYan123
缓存层级:持久前缀和廉价的瞬态重建
缓存设计是吞吐量数据、代理工作负载和每个加速器报告收入之间的核心联系。
持久区块KV存储在一个独立的3FS存储集群中,SSD容量约为100 PiB。 报告的代理流量保留时间为3天,聊天机器人流量7天**。任何预填充工作者都可以检索缓存前缀,从而将缓存局部性与计算位置解耦,使存储和计算能够独立扩展。@ZhihuFrontier
这种保留对于反复重发不断增长的指令、仓库内容、工具输出和之前响应历史的代理来说非常有用。这也意味着每天155吨被服务的代币不能被读作每天155吨新生成的代币:缓存命中是服务代币计费的一部分,而新计算的预填充和自回归输出带来的成本截然不同。因此,报告的96%输入缓存命中率是标题吞吐量的重要参考。@ZhihuFrontier、经济工作量假设
该实现涵盖了两种不同的状态生命周期:
- 持久区块缓存异步加载。 主机到设备传输与重叠层执行。Su Jin Yan 强调了一个低层实现细节:细粒度的 KV 块副本通过 CUDA 复制引擎表现不佳,因此所述路径使用 GDR/RDMA 传输,旨在饱和 PCIe 带宽而不占用 SM。这是基于报告的技术观察,而非推文中单独测量的结果。@SuJinYan123
- 滑动窗口注意状态保留在主机内存中,而非持久SSD存储。 它主要在活动会话中有用,且寿命比可重用块前缀短。@ZhihuFrontier
- SWA 有界重放仅从最新128个令牌中重建缺失的短寿命状态。 重放限制对该段的注意力,同时重用持久区块缓存,产生近似而非重建完整之前历史的状态。DeepSeek 报告称,这几乎将总预填充计算量减半。在考虑可移植性到其他架构时,近似及其模型特定的有效性非常重要。@ZhihuFrontier
Su Jin Yan 还报道说,长期保留尾部仅带来约 0.5–1% 的额外缓存命中,说明了存储容量与重计算之间的权衡。同一评论还建议,解码主导的缓存管理允许生成输出在后续回合中成为可重复使用的前缀状态。@SuJinYan123
这一时间安排让人联想到OpenAI单独宣布的12小时API提示缓存,与其30分钟默认缓存**,后者包含请求中混合保留时长。这两者并非完全相同的产品或架构,但都针对跨越较长间隔重复利用上下文的持久代理。信息流中其他关于无限期登录缓存的说法是评论,而非API公告的条款。@OpenAIDevs、保留控制、比较评论
推测、API兼容性与模型特定优化
DSpark 使推测验证具有自适应性。 它预测选票令牌接受概率,并调整验证长度以最大化预期吞吐量。DeepSeek报告称,与始终验证五个草稿代币相比,生产吞吐量提升了**6%。这是相较于特定投机解码基线的增量收益,而非非投机解码的6%。@ZhihuFrontier
'deepseek-recipe'** 指的是服务接口,而不仅仅是分词器速度。** 它支持 聊天完成、回复和消息 API,并行化令牌化,并区分真实的控制令牌与用户文本中看起来相同的字符串。这一区分防止了字面上的用户内容被误解为结构分隔符;这不应被误认为是完全的即时注射防御。@ZhihuFrontier,@deepseek_ai
社区解释将效率归因于多个模型/运行时联合设计选择:196B Engram参数、较小的预填充骨干(激活约8B参数/令牌对比解码时16B**)、宽EP、高度压缩的KV以及推测解码。它进一步描述了552B专家参数、DP64/EP64、约45B常驻参数/设备,主要是四位权重,以及据称相较于GQA基线的400× KV减少**。这些都是次要主张:帖子中没有详细说明复制、共享权重、量化布局或GQA引用,无法独立重建这些数据。特别地,45B/设备不是简单地除以552B除以64就能得到的。@bookwormengr
这种模型特异性是不假设相同的收益会自动转移到任意检查点的原因之一。Su Jin Yan 认为 每个模型仓库/内核策略具有价值;Andrew Carr 建议将实现适配到其他带有编码代理的模型,但未提供可移植性或性能验证。@SuJinYan123、@andrew_n_carr
独立比较:vLLM复制了什么——以及它没有实现什么
对“只有DeepSeek能做到这一点”的最有力技术反驳是vLLM的后续问题:
 ](


需要区分三个:
- 6%以内的结果是解码阶段的奇偶校验,而非DeepSeek整个服务的复现。 它无法在DeepSeek的流量分布下建立等效的100-PiB缓存操作、保留经济性、路由、生产可用性或端到端延迟。
- 1Mtoken/s/GPU 这个数字不能指每个用户的生成。 同一帖子单独报告了大约200个P90输出TPS;吞吐量头条需要基准的输入/缓存/输出计量,才能与纯译码吞吐量进行比较。
- 该工作是外部实现比较,但仍由竞争引擎团队自我报告。 公开InferenceX的结果和配方提升了可重复性;他们不会对每个报价的生产声明进行独立审计。
开源传承是明确的:vLLM 感谢 DeepSeek 发布了 Apache 2.0 并致谢,而权宇旭则称 DeepSeek 是早期采用者和贡献者。因此,DeepInfer 更适合被理解为生产学习回流到现有生态系统的过程,而非完全独立的替代方案。@vllm_project,@woosuk_k
其他反应涵盖了有用的范围:
- 强烈推荐: Tim Dettmers 评价 Deepseek 的推理栈与 OpenAI 相当,且在用户规模上优于 Anthropic;Graham Neubig 指出官方 API 的速度和价格。两者都无法提供匹配的跨实验室基准。QuixiAI表示,此次发布将通知SlimServe。@Tim_Dettmers、@gneubig、@QuixiAI
- 部署怀疑论: 苏金彦认为工程文章比有经验推理开发者的仓库更有价值,部分原因是缺少重要组件。Finbarr Timbers 要求与 Modal、Together 和 vLLM 进行比较;提供的帖子中没有匹配的Modal/Together对比。@SuJinYan123,@finbarrtimbers
- 来自一位热情评论者的有条件支持: Teortaxes承认基础设施缺失,并建议3FS加上可能的Dynamo可以弥补部分空白,同时估计匹配集群规模吞吐量大约需要**3,000–4,000个GB200*。这只是拟议的部署路径,而非已验证的复制。@teortaxesTex
随后,技术报告的官方英文版本被收录在仓库中,减少了仅依赖社区翻译的需求。@teortaxesTex
经济学:强有力的收入披露,而非完整的利润表
最重要的财务披露是每加速器小时在非高峰期的收入38美元**。收入不是利润,加速器小时只是制作服务成本基础的一部分。@swyx
一个广泛共享的估计最初计算出的推断边际为87.76–96.94%,假设:
- 97%的缓存输入,2%未缓存的输入,1%的输出,所有计费令牌的比例;
- 80K 未缓存输入令牌/s/GPU 和 16K 输出令牌/s/GPU;
- 250个输出令牌/每用户;
- $3–$6/GPU小时租赁费用。
对于10亿个计费令牌,该型号包含970M缓存输入、20M未缓存输入和10M输出,大约需要875 GPU秒:预填充250秒,解码625秒。预计GPU成本为**$0.73–$1.46**,而非高峰期收入为**23.82**。@zephyr_z9
作者随后更正了估计:理想情景大约是每小时49美元,而DeepSeek报告的是每小时38美元,约为生产基准性能的80%。修正后的报价利差区间为84.2%–96.1%。未经该修正,不应重复原始估计。@zephyr_z9
其他帖子使用更高的硬件成本:
- 以每小时7美元对比38美元每小时收入计算,算术计算约为**81.6%*(不含其他成本)。金宇晨明确指出,DeepSeek并未披露收入背后的GPU数据。@Yuchenj_UW
- 在**$5–$10/小时时,同样的加速器计算大约覆盖73.7–86.8%,而不是建立一个统一的“80%服务利润率”。@swyx
这些计算省略或不完全分配了SSD缓存群、CPU、网络、空闲/备用容量、故障、工程、支持及其他运营成本。它们还依赖于高度有利的缓存密集令牌组合。培训支出和未来计算承诺再次分开:高推理贡献空间可能与公司层面的重大亏损共存。
更激进的推断明确带有推测性质。Teortaxes估计,所谓的**$100 ARR可由大约42GB200 NVL72机架/3000 GPU在非高峰期支持,后来在包含高峰期后又降至33个机架**。这些帖子还推算出来自4,167个机架的1000亿美元年收入,以及每吉瓦高收入。这些是情景计算,而非经审计的DeepSeek收入、车队规模或回报披露。初步估算、修正估算、行业外推
关于市场影响的看法存在分歧。有人认为这些披露是推断已超过盈利门槛的证据;还有一些预测是代币价格下跌,计算价格最终会上涨,从而压缩回报。Moonshot/Zhipu托管协议中可能存在的竞争效应,但尚未衡量:公开部署的协议栈既能改善提供商经济,也可增加价格竞争。@KCDN19、价格趋同论证、主办竞赛
NVIDIA、Ascend与硬件推理的局限
Ascend兼容性已确认;而 Ascend 的生产效率则不然。 多篇文章将 Blackwell 支持、“sm100” 支持和 NVL72 形状配置解读为 NVIDIA 硬件正在生产的证据。这些只是线索,不是公开的库存或NVIDIA与Ascend的比较。@eliebakouch、@stochasticchasm、显性不确定性
后来的硬件分析比较了GB200和Ascend 950DT的译码数据:
- 在100 TPS约束和131K上下文下:约为25.5K对5Ktoken/s/设备。
- 在230 TPS时:约为20K对2.7K,比例从大约5×扩大到7.4×。
- 它引用了DeepEP-Ascend早期披露,指出EP64–128及联合操作仍在优化中**,包括局部开销减少和与URMA的HBM争用。
- 它假设经过改进后,8–10K token/s/芯片,经济交叉效应约为6.8K token/s/s/芯片,假设价格为**37K/950DT**。
这些预测结合了不同的测量、假设采购价格和未经验证的未来优化收益;它们并不是一个完全相同的DeepFifer硬件基准测试。@teortaxesTex
同一评论员预测到2027年底,DeepSeek将获得主要的Ascend分配,以及超过1 GW的Blackwell等效计算量,同时也报告了一个相互矛盾的模型估计,约为25万张GPU。这两种预测都不是DeepSeek采购公告。计算投影,估计矛盾
V4.1 闪存背景:低价服务提升了能力,但不影响质量
独立评估支持有意义的开放模型能力进步,尽管不支持普遍前沿奇偶校验:
-
Arena: V4.1 Flash 20261017 Max 在 Agent Arena 和 Code Arena: WebDev 中排名 #1 开放模型。在《特工竞技场》中,整体排名为**#11**,7,500+个真实世界会话中净提升++5.1%,中位成本为**$0.20/任务**。Arena 描述这大约是 GPT-6.1 Sol 改进的 37%,成本仅为其 27%。报告信号包括:+11.5%确认成功率,+5.9%的赞誉与抱怨,+5.4%的Bash可靠性,以及**+2.5%的可操控性**,该评估中未观察到工具幻觉问题。@arena、详细结果
-
网络安全: Vals 报告称,V4.1 Flash 1017 在使用基于 Pi 的代理进行的企业网络模拟任务中,超过 GPT-6 Sol 的平均进度。DeepSeek和Sol各获得了三次新鲜射击;其他型号则为单次运行。完整的评估细节仍在公布中。DeepSeek使用了更多的代币,但总API成本更低。@ValsAI、成本解释、方法论
-
网络结果在效率和最佳运行表现上存在争议。 Scaling01 认为“击败 Sol” 夸大了结果,因为 DeepSeek 效率低了好几倍。Teortaxes报告约为4.3×标记,2.4×时间,并称Sol的最佳通关达到了DeepSeek未曾达到的目标群。将节省的资金用于重复运行或蜂群的建议仍属假设,未被评估为同等预算结果。@scaling01、@teortaxesTex、等价群体建议
非正式报告比受控证据令更有利。Teortaxes描述了知识竞赛回合,DeepSeek的评分分别为100%、100%和91%,而MiniMax分别为60%、48%和62%,以及描述/变体拼写测试为100%对50%。这些是小型的作者设计测试,包含模型生成的问题和答案键错误;它们建议后续实验,而非经过验证的知识基准或证明仅凭Engram导致差异。另一位用户报告称Hermes辅助AI研究表现强劲,另一条帖子称DeepSeek在另一项评估中仍远低于Sol-xhigh。知识竞赛测试、随访、变体拼写测试、研究轶事、对比结果
本地部署则带来了不同的权衡。Brandon Music发布了一款TrellisMX K2 Mix,目标是两台RTX PRO 6000,使用了两位专家,629位专家提升至三/四位,四位Engram表,容量约为3M KV代币。报告的平均氯斑点为0.1306个自然血统,比普通K2低8.6%;一个+5GB变体,目标约为200万个KV代币**。仅测量了KLD,服役时使用测试图像,任务质量保持、实际速度和操作稳定性尚未确定。@BrandonMusicKy
代理基础设施、本地执行与硬件加速
-
长上下文推理内核:SGLang 合并了超级内核支持,SemiAnalysis 报告 AgentX 中 GB300 NVL72 上每用户近 000 token/s/s,MI355X则有 1.5×更强的交互性。另外,Inferact 报告了 TPU v7 上 Kimi K3 的 391 个令牌/s/用户,使用 vLLM TorchTPU 中的开源巨内核(SGLang 结果、TPU 结果)。
-
AMD 优化:Zyphra 报告称 GLM-5.3 的 512K 上下文 TTFT 从 178.8s 降至 64.6s,或将 42.3s 降至 11.8s,且缓存 90% 上下文。这些是单节点的MI355X测试,没有实时流量——不是直接可比的生产测量(结果、条件)。
-
苹果-硅片运行时优势:PyTorch 2.15 用 Metal 内核替换了多个 MPSGraph 路径。报告的改进包括:5–6.5×更快的MoE解码**,Qwen3.6-35B-A3B在M3 Ultra上的令牌从9.4提升至61.3令/秒,MPS支持FP8,以及Wan2.2 VAE峰值驱动内存从约270 GiB降至8 GiB。这些改进体现在 PyTorch 本身,而非单独的推理运行时(发布摘要)。
-
本地复杂度计算机:模型和代理现在都可以完全在支持的苹果硅Mac上运行,包括离线,并与本地应用和本地文件交互。
-
建模和访问:本地任务使用PPLX Pro,即经过后培训的Qwen 3.8版本,且不消耗计算机信用。Pro、Max和Enterprise用户均可访问;推荐36 GB统一内存。
-
混合执行:一个独立模式将工作分开处理本地和云模型。因此,其隐私属性依赖于这种分割,不同于完全本地执行(公告、model、要求)。
-
持久代理服务:LangChain的托管深度代理打包用户特定凭证、范围内存、沙盒执行和调度工作;Hugging Face 的代理管理器可在 Claude Code、Codex 及其他约束框架(LangChain 架构、代理管理器)之间协调持久会话。
-
提示缓存:OpenAI增加了12小时API提示缓存,可与请求中的30分钟默认缓存混合使用。更长的保留时间会带来额外成本,但可以受益于反复使用的代理上下文(公告、配置)。
-
使用计费:OpenAI识别出约4万个*账户其应用的使用限额与所选套餐不符,纠正了问题并承诺向受影响用户提供抵免(事件更新)。
设备上型号、语音和图像发布
-
Muse Glimmer:Meta的开放30B多模态代理模型,源自Muse Spark,目标为32 GB VRAM,运行于一块RTX 5090,采用4位量化和推测解码头。论文报告称,MCPAtlas上有75.5,在SWE-Bench Pro上51.2;Qwen3.6-27B 在 OSWorld-Verified 和 TerminalBench 2.1 上依然领先。它支持文本、图片以及在Apache 2.0(论文摘要)下超过100种语言。
-
Voxtral 3:Mistral 推出了批处理和流式转录、多语言语音语音转录系统(TTS)以及带工具调用功能的语音代理 SDK,可通过其 API 或客户基础设施(launch、deployment options)获得。
-
独立测量:人工分析将小转录3归于**#3,AA-WER含量为2.1%。实时模型实现了3.3%的最终转录AA-WER,速度为960毫秒;TTS在两个语音领域均进入前12名。
-
价格和速度:TTS成本为**130万字符*,其测量(评估、吞吐量](https://x.com/ArtificialAnlys/status/2112587924046815630))产生**112.3字符/秒。
-
CPU 替代方案:Kyutai 发布了更小的 Pocket TTS 变体,参数降至 1.9M 参数,声称在一个 CPU 核心上实现 103× 实时,并支持语音克隆(release)。
-
Fibo 2.0:Bria 的 8B 开权重图像家族 包括用于文本转图像的 Dev 和精简版 Edit Turbo。Artificial Analysis报告显示,在开权重编辑表现上领先,并在文本对图像方面与Qwen-Image-2.1并列;Bria API 定价为 $32/1,000 张图片(评估)。
-
许可注意:权重为非商业;商业部署则需要单独的Bria协议。授权训练数据不应与权重的无限制商业权利混淆。
-
Krea 3 Ultra:排名因竞技场和更新而异。Artificial Analysis自己的公告将Ultra列为**#5**,而之前引用的帖子则是#4;Arena将其归为**#4在多图编辑**,#8在单图编辑。合理的结论是具有竞争力的图像编辑质量,而非普遍的第四名排名(Artificial Analysis、Arena)。
-
定价:快速成本 每张输出1K图像0.03美元,另加每张1K参考图像0.02美元。Ultra 仅支持 2K 输出;2K编辑加上一个1K参考,费用**$0.27**。
独立评估、网络能力和安全证据
-
HealthBench揭示评分敏感性:Artificial Analysis为5,000条一般健康对话和525条临床医生对话启动排行榜。GPT-6 Astra在Professional的长度调整后得分中以**66.0%领先;Claude Sonnet 5.5以62.1%**领先整体HealthBench。
-
长度效应:作品5.5拥有专业版最高原始得分,为71.4%,但调整后降至59.9%**。General HealthBench的最短答案模型在沟通质量上领先,但在完整性方面得分最低。因此,答案长度是一个重要排名选择,而非表面细节。
-
成本权衡:DeepSeek V4.1 Flash得分60.9%,$0.005/任务,而Sonnet的62.1%,$0.08。评分采用OpenAI模型,遵循原始实现(方法论和结果)。
-
路由与专业决策:在五台路由器和约1,250个任务中,Vals发现每台路由器在得分和成本上都被至少一个独立型号击败。在路由器预算内事后最优选择将使得分提升8–27分,表明有相当大的选择余裕(路由器指数、预言机比较)。
-
ClaimBench:在另一项财务文件分类基准中,Decider V1.2处理了99.7%的索赔,其余提升至俳句5.5;Vals报告称,准确率为99.9%,每1000件索赔中0.11美元,而俳句单曲准确率为1.19美元。这种狭义分类结果与较弱的广义代理路由(基准、级联结果)不矛盾。
-
DeepSeek 进攻性网络结果:Vals 报告 V4.1 Flash 1017 在使用 Pi 框架模拟企业网络任务中表现优于 GPT-6 Sol。DeepSeek消耗了更多代币,但总价格却更低。
-
证据限制:DeepSeek和Sol各得三分;其他车型则配备了一台。完整的评估报告尚待发布。有反应因效率差异而否认这是无条件胜利,因此应将其视为初步能力信号,而非确定的排名(find、方法论、资格)。
-
安全保障与问责:METR同意Anthropic对覆盖模型的低灾难性错位风险结论,但指出存在重大分析分歧。它建议**端到端的监控系统红队*,并评估模型削弱安全相关决策的能力(review、建议、决策风险)。
-
事件透明度:Hugging Face 首席执行官 Clément Delangue 批评 Netflix 对报道中的 OpenAI 代理网络攻击的描绘,认为封控、监控、开放模型的防御性使用以及缺失代理踪迹应得到更多关注(声明)。
-
谣言更正:西奥否认拥有Fable 5.5;这次明显的泄露涉及错误的型号识别,随后澄清所谓的来源是一名喷子。所提供的帖子不建立起跳(拒绝、澄清)。
科学检测剂:湿实验室结果与无限限制
-
蝎子毒素结合剂:Anthropic和Citrini报告了来自211种测试蛋白设计的17种结合剂,这是经过内部Claude研究模型大量计算的成果。所有测试设计和实验室数据均已发布(公告、数据)。
-
关键限制:无任何药物结合多种毒素,且未检测过毒素中和作用。这不是抗毒血清,也不是治疗效果的证据;细胞、动物及进一步验证仍然领先(研究者说法、官方警告)。
-
病理到生物学预测:Sophont引入了Holon-S1,可预测常规病理切片中的空间基因活性和生物标志物。团队报告了涵盖16种器官类型和15多种扫描仪的评估,在空间基因预测方面优于两个对比模型,并识别出潜在的新乳腺癌和结肠癌生物标志物。这些是研究发现,而非经过验证的治疗选择结果(launch)。
-
开放式研究依然困难:评估者给GPT-6 Astra和Claude Fable 5.1未发表的AI研究问题和各1万美元预算。原作者发现实验设计和资源管理相较早期测试有所改进,但仍因创造力、判断力、校准和沟通等不足而拒绝了两篇生成的论文。这项小型研究是对可严格验证研究任务结果的有效平衡(评估)。
产业与政策:药物开发、制造与资本承诺
-
OpenAI 收购 Orchestra Bio:OpenAI 宣布收购一个药物开发协调平台,将其生命科学工作从研究工具扩展到与 Rosalind 共同执行的运营。未提供财务条款(公告)。
-
Arda公开发布:前OpenAI研究主管Bob McGrew宣布与Anduril合作开发的软件制造。他的第一方账户中标明为1.6亿美元的A轮,估值为15亿美元**;CNBC附带的帖子提到筹集了2.3亿美元**,但未明确将这一数字与宣布的轮次进行对应。初始产品支持手工装配线设计和操作;可重构自动化是下一个目标(创始人公告年,CNBC报道年)。
-
融资与计算敞口:报道称OpenAI在预期的Anthropic首次公开募股前,寻求约300亿美元,估值为1.4万亿美元**。另外,《华尔街日报》对Anthropic招股说明书草案的审查指出,上半年收入达163亿美元,计算/基础设施支出近90亿美元,未来计算承诺超过6亿美元,包括谈判。这些是有归属的报告,而非已完成的交易或独立核实的财务披露(OpenAI report、Anthropic report)。
按互动排名的热门推文
- 39,393 — DeepSeek 发布 DeepInfer
- 9,809 — OpenAI 纠正影响约 40,000 个账户的使用限制不匹配问题
- 5,778 — Anthropic发表蝎子毒素结合剂研究
- 5,700 — OpenAI 宣布收购 Orchestra Bio
- 3,056 — 密斯特拉尔引入沃克斯特拉尔3
- 2,600 — 研究者解释结合剂结果及生物学限制
- 2,476 — 拥抱面CEO质疑网络攻击纪录片框架
- 2,330 — Theo拒绝所谓的Fable 5.5访问权
AI Reddit 回顾
/r/LocalLlama + /r/localLLM 回顾
1.DeepSeek DeepInfer 开源推理框架
-
DeepSeek 新内容 - DeepInfer -(活跃度:313):** 图片为 DeepSeek 在 X 发布的手机截图,宣布其内部推理框架 DeepInfer 现已完全开源:image, GitHub。相关技术上的说法是,DeepInfer支持DeepSeek V4.1闪存的大规模运行,单集群吞吐量为**'155万亿/天',每张卡收入'38美元/小时',强调高通量、低延迟的大规模推理而非模型训练。**评论者对DeepSeek开源内部生产推理栈感到特别惊讶, 与他们对Anthropic、OpenAI或Meta的期待形成对比。部分读者对框架实际作用存在基本不确定性,即是服务/推理基础设施,而非新模型。
-
一个关联的直湖来源声称DeepInfer实现了高吞吐量、低延迟的大规模推理,针对DeepSeek V4.1闪存,报告单个集群的“155万亿令牌/天吞吐量”,以及“每卡小时38美元”非高峰定价的收入:

https://zhuanlan.zhihu.com/p/2095560295930508953
-
- .一位评论者还强调,据报道的服务数据大约是“256个令牌/秒×100名用户”,这意味着如果在生产环境中持续,并发解码吞吐量将非常高。
-
提出的一个技术问题是,DeepInfer 是通用推理框架还是主要为 DeepSeek 自身模型架构和部署环境高度优化的栈。仓库初始 GitHub 星数低而公告互动高,被认为是由于新颖性,但评论者期待工程师在检查实现和可移植性后会有更有意义的评估。
-
Deepseek 发布了 DeepInfer - 面向 DeepSeek 模型的高性能大规模开源推理框架!(活动:1023):DeepSeek 发布了'DeepInfer',这是一个面向 DeepSeek-V4.1-Flash 的开源高性能离线推理框架,具备面向生产的原语,包括优化内核、注意力/数据/上下文并行、与 EPLB 的 MoE 专家并行、DSpark 风格的推测解码、SWA 有界重放、异步调度、结构化输出、批处理不变推理和确定性抽样。目前它通过'DEEPINFER_ACCELERATOR=nvidia|ascend',目标是NVIDIA SM100显卡和华为Ascend 950 NPU,需要Linux/Python 3.12加上CUDA 13或CANN 9.2;然而,完整的在线服务仍然需要外部KV缓存管理、预填充/解码拆分以及DP副本负载均衡。DeepSeek还发布了'deepseek-recipe',这是一个带有Python绑定的Rust库,支持协议转换和跨API如聊天完成、消息和回复等API进行模型输出解析。评论者们认为该版本有助于将生产推理技术逆向工程到社区引擎中,如gufo、halogen、strixite和Strata。人们对明确支持Ascend 950也引发了兴趣,有评论者开玩笑说“英伟达已经一团糟”,尽管NVIDIA列出的目标仍然是下一代SM100,而非目前普遍被取消的
配置的GPU。
-
Deepseek 的发布分为两个仓库:DeepInfer,被描述为 DeepSeek 模型的高性能大规模推理框架;以及 deepseek-recipe,一个带有 Python 绑定的 Rust 库,用于协议转换和跨 API 格式如聊天完成、消息和响应进行模型输出解析。
-
评论者指出,目前列出的加速器目标是NVIDIA SM100显卡和华为Ascend 950 NPU,构建时平台选择通过“DEEPINFER_ACCELERATOR=nvidia”或“ascend”显示,然后运行“./build.sh”。Ascend支持备受关注,因为它暗示DeepSeek正在优化超越标准的CUDA/NVIDIA路径。
-
一位评论者引用了DeepSeek在Zhihu上的帖子,声称大约“每GPU小时38美元”的收入/吞吐量经济学,并链接了原帖zhuanlan.zhihu.com/p/2095560295930508953。该讨论串讨论了类似的每GPU经济学是否可以用来估算像OpenAI或Anthropic这样的竞争对手的推理收入,尽管没有提供具体的推导结果。
-
DeepSeek V4.1 Flash 1017真的能运行在12GB显存+64GB内存上吗?(活跃度:352):该图片(https://i.redd.it/4fddqq8csdwh1.jpeg)是X/Twitter帖子的截图,声称DeepSeek V4.1 Flash 1017可在第四季度本地运行,支持'12GB VRAM + 64GB RAM';Reddit帖子问RTX 3060 12GB是否能卸载足够的层,使推理变得可用。关键的技术反对意见是,据报道,V4.1 Flash通过mxfp4 + fp8对许多专家来说已经达到'4.25 bpw',所以虽然如果总内存足够它可能合适,但由于CPU和内存执行量大,预期性能可能非常慢——有评论者估计大约是**'~3个token/sec'。评论者对这是否适合日常使用持怀疑态度: 大家普遍认为“可以加载”而不是“运行愉快”。有评论指出,最初提出申报的人是Strata的创建者**,这为尺寸主张增添了一定的可信度,但不一定能反映性能预期。
-
评论者质疑了“DeepSeek V4.1 Flash 1017** 几乎可以运行在”12GB VRAM + 64GB RAM“上:即使是”Flash“版本,许多专家都认为其性能约为”4.25 bpw“,使用 MXFP4 + FP8,因此标准的 Q4 风格配置在内存预算内不太可能。
-
技术上可行的配置可能需要大量卸载:有评论者说Q4不合适,建议直接检查Hugging Face模型大小,然后将n-gram卸入NVMe,并从磁盘流式传输一些MoE专家。理论上可以运行,但预期吞吐量可能非常低,估计大约是“~3个token/s”或更低,具体取决于磁盘和卸载实现。
-
对最初的Strata主张是否准确存在怀疑;评论者指出,即使模型能够“适应”RAM/NVMe的某个位置,相关问题还是实际推断速度,而不仅仅是可加载性。
%E6%98%AFX/Twitter%E5%B8%96%E5%AD%90%E7%9A%84%E6%88%AA%E5%9B%BE%EF%BC%8C%E5%A3%B0%E7%A7%B0DeepSeek)
2.MiniMax M3.1 闪存发布版
-
MiniMax M3.1 闪存发布,型号权重于10月23日(活动量:874):该图片是MiniMax X针对MiniMax M3.1闪存的官方公告,描述为“空间性能+兔子速度”,API现已开放,开放模型权重计划于10月23日发布。评论者补充说,该模型据称是一个具备'428B'总参数、~'23B'主动参数、稀疏注意力和原生视觉编码器的MoE;预览/工具页面链接在agent.minimax.io/tools/m3-1-flash-preview。 评论中的主要技术关注点是,基准测试的兴奋度很大程度上依赖于模型大小/活跃参数数,因为没有架构细节,性能声明难以提供具体背景。
-
一位评论者引用了MiniMax M3.1闪存预览工具页面,称其指定了专家混合架构,包含“428B”总参数和“23B”活跃参数,加上稀疏注意力和原生视觉编码器:https://agent.minimax.io/tools/m3-1-flash-preview。这直接回答了关于模型规模的不确定性,并表明模型定位为一个大型稀疏多模态系统,而非密集的大型语言模型。
-
MiniMax-M3.1-Flash即将推出(活跃度:521):MiniMax通过官方X帖子(source)预告了MiniMax-M3.1-Flash,但Reddit帖子未提供架构细节、参数数、上下文长度、定价、发布日期或基准测试。唯一的技术信号是产品命名:评论者推测“Flash”可能指的是速度/延迟优化的变体,尽管没有证据支持。 评论者对“Flash”的含义持怀疑态度,开玩笑说在当前的LLM命名中,它可能仍然是一个非常大的型号——例如*“Flash指的是500B型号”**——或者讽刺地说,它是一个据说轻量但实际上并不小的型号。

3.基准通胀与人工智能斜率测量
-
AI实验室报告基准得分平均比独立测试者高6.4%(活动:334):图片为'whatmodel.sh'开放排行榜的技术基准比较图表,可视化'611'**跨180'AI模型和'103'基准的对比,来自'1,629'已发布结果。报告显示,AI实验室自发评分平均高于同一模型/基准对的独立测试者,分别是:实验室高病例375%,独立实验室高216%和20平;实验室显示的最大中位基准差距包括 SWE-bench Verified 和 MBPP,分别为约 '+9.0' 点。图片 ·互动图表 ·数据/代码 评论者争论该差距是刻意的分数膨胀,还是更日常的可重复性问题,如软件包版本、束缚设置、随机种子、提示/评估设置,或实验室优化基准工具以呈现最佳结果。有几家公司将其与苹果或英伟达等厂商有利的表现图表进行比较,认为只有独立复刻或同行评审的结果才值得信赖。
-
多位评论者认为,“6.4%”的平均差距可能源于基准可重复性问题,而非纯粹的通胀:软件包版本、评估工具设置、随机种子、提示格式和实验室专用基准工具的细微差异都可能显著影响报告分数。其中一个主题是实验室通常会优化展示模型的精确线束/配置,而独立测试人员则可能使用更通用或不那么针对模型的配置。
-
一位评论者指出,平均差距可能由离群值驱动,并建议中位数差异更接近报告的基准值。这意味着如果少数大幅度偏差主导整体,总体平均可能会高估系统性通胀。
-
一种技术解释是部署不匹配:实验室可能对全权重模型进行基准测试,例如“BF16”,而独立测试者则常评估已量化为“FP8”、“MXFP4”或其他硬件高效格式的已服务API版本。如果属实,部分分数下降可能反映的是数据中心张量单元的推理服务优化,而非基准操作。
-
让我们深入探讨r/LocalLLaMA(活动:455):该帖子链接了Reddit社区(包括r/LocalLLaMA)中对“AI垃圾”的非正式纵向分析,并尝试推断未来垃圾盛行情况:thil.ooo/blog/measuring-slop。一位技术评论者指出可能存在测量偏差:版主移除和业力过滤可能导致推移/归档式数据集低估短命机器人帖子,而机器人规避策略如全小写可能削弱简单的“人类标记”启发式;他们还建议与“Claude 负重词汇”(https://louisabraham.github.io/load-bearing/)中的 Claude 相关词汇进行比较。 版主反馈支持:尽管有报告,一位版主仍保留该帖子,直接关联持续的反垃圾审核。评论者普遍认为,明显的AI生成风格标记——长破折号、项目符号列表和“挖掘”等常用短语——已成为噪声信号,可能错误地牵连人类写作。
-
一位评论者指出,有几种测量偏差,这些偏见可能影响基于Reddit档案数据训练/评估的AIslop检测器:版主可能会在“/new”生成的帖子出现在数据集中前删除,新的karma过滤器可能抑制了上游的机器人/slop提交。他们还指出,机器人可能会通过全小写发帖来规避简单的风格启发式,这可能会破坏“人类标记”的假设。
-
一项技术建议是使用Claude特有的“slop”术语扩展探测器的词汇特征集,参考https://louisabraham.github.io/load-bearing/中对Claude承载词汇的分析。评论者强调要区分**明显的AI粗糙*与更广泛的低价值生成内容,后者可能没有明显的风格特征,且可能很快被删除。

** 技术性较低的AI子版块回顾**
/r/奇点,/r/Oobabooga,/r/MachineLearning,/r/OpenAI,/r/ClaudeAI,/r/StableDiffusion,/r/ChatGPT,/r/ChatGPT,/r/ChatGPTCoding,/r/aivideo,/r/aivideo
1.Opus 5.5 游戏自动化成就
- 花费712美元、39小时后,作品5.5独自击败了《博德之门3》(活动时间:1145):一位用户报告称Claude Opus 5.5自主完成使用自定义工具完成了《博德之门3》:'claude -p',禁用内置工具,使用通过TCP连接Lua BG3模组的Python主控服务器,提供Vulkan层截图和SDL介导点击(write-up, code)。本次运行耗时'39小时','$712','99'新会话数,'20,809'工具调用,'862'截图,'2.2B+'缓存输入令牌对比'3.50万输出令牌,依赖git支持的内存系统,包含'157'提交次数、~23k'精选词和'67'精炼战术规则;经过审计的Faith-Leap重播需要'36分钟','674'工具调用,'$24',1人死亡,11次重载,仅用修复隐藏通道泄漏后马赛克的截图。作者计划将该线束打造为短期BG3场景的基准,按成功率、尝试次数、时间和成本评分,据报道Claude的Nautiloid开局成功'9/9'成交价约'$1.50/run'**,Codex/Gemini集成已准备好但尚未评估。顶级评论者大多反应称该项目昂贵但有前景:有人称其为“最佳基准点之一”,用于跨厂商比较代理, 当
Nother则将这种花费斥为*“花钱多于理智”。* 非技术性笑话集中在特工是否做出了具有道德意义的游戏选择,例如是否突袭了树林。
-
一位评论者将此次运行框定为一个潜在有用的代理基准,建议在多个竞争模型上重复《博德之门3》任务,可能比许多标准基准测试更实用地比较长期规划、工具使用和持久性。关键技术价值来自于标准化安装,并衡量跨模型的成本、完成时间、故障模式和决策质量。
-
Claude Opus 5.5 一夜之间反编译了一款 PS2 时代的游戏,数百个游戏现在在浏览器标签页中运行(活跃度:2348):一篇 Kotaku 报告声称进行了 AI 辅助逆向工程——帖子标题中归因于Claude Opus 5.5——已经实现了老游戏的浏览器移植,如光环:CE**,GTA:罪恶都市,滑板3,以及辛普森一家:Hit & Run。文章指出,有些移植完全在浏览器内运行,并有显著的性能宣传,例如Hit and Runtargeting**'240fps'和*** Halo: CE**build支持低延迟在线多人游戏,但评论者质疑这些是否是真正的反编译,还是现有二进制/资产的重新编译/重实现。 顶级评论持怀疑态度:有人要求提供实际可玩的浏览器链接,并称该帖子为“空洞的炫技”,“另一位则认为术语被混淆了——”这些不是分解......它们只是重组?”* 另一位评论者推测,一旦企业将强模型视为知识产权执行威胁,公众访问可能会受到限制。
-
一位评论者质疑帖子的术语,认为这些很可能不是完整的反编译,而是重新编译/重组项目,指出社区可能混淆了两者。这一区别在技术上很重要:反编译意味着恢复高级源代码或等效结构,而重新编译通常将现有二进制文件/IR转换为新的目标,如兼容浏览器的代码。
2.人工智能证明与学术劳动
-
菲尔兹奖得主理查德·博彻兹谈OpenAI证明:“我认为人们感到不满的是,他们慢慢意识到自己很愚蠢,并以某种方式把责任归咎于人工智能,尽管这其实并非人工智能的错”(活动:1309):链接的Daily Cal**文章报道了加州大学伯克利分校数学家对所谓OpenAI Navier–Stokes证明的反应(文章),将其框架为数学证明验证、教学法以及人工智能系统在先进研究中作用的压力测试。理查德·博彻兹被引用说,反弹可能反映了研究人员意识到自身局限性,而非人工智能特有的失败:“*****他们正在慢慢意识到自己很愚蠢,并以某种方式将责任归咎于人工智能。”顶尖评论者主要聚焦于教育:一位主张如果学生无法在考试中重复理解,人工智能在作业中的使用无关紧要;另一位则强调博彻兹的观点,认为人工智能可能比人类教师更耐心、更具表达力。
-
引用自Richard Borcherds的讨论,将AI生成的数学框架为可能产生非常庞大的形式伪造物——例如*“某重大猜想的10万行形式证明”——但认为这不一定会削弱数学学习或研究,因为人类可以选择忽略机器生成的形式化。技术上相关的含义是区分形式证明生成/验证**与以人为中心的理解、动机和理论构建过程。
-
有一条评论强调了Borcherds声称AI可能比他更擅长教授MATH 250A研究生抽象代数,特别是因为它耐心、一致且能够无挫败地重新解释内容。这是一个以教育为重点的技术问题:LLMs可以很好地作为复杂符号主题的适应性导师,同时仍无法取代学生为达到考试水平而独立解决问题的需求。
-
一位物理学家在博士论文中花费了一年时间和~500页的手工计算量子引力,但Opus 5.5仅用了10小时完成,包括文章和GitHub仓库。而且它甚至找到了错误。“劳动”在学术界将意味着什么?(活动:1710):链接仓库,'eokahya/claude-audits-quantum-gravity',是E. O. Kahya(原作者)对先前用于de Sitter空间中无质量最小耦合标量的引力子修正的单环量子重力计算的AI辅助审计——并非完全自主的重新发现。该工作流程被手动分解为'18'-任务/'9'-阶段的流程,Claude在其中编排了确定性'SymPy'/'mpmath'检查,包括高精度数值采样,发现了主要是簿记/打印问题:印刷裸自质量中的整体符号约定错误、表X中的缺失/非解析项、有限中间问题以及**'23'错别字。据报道,主要物理结果未变:校正后,施温格–凯尔迪什晚时模函数分析仍未产生如'ln(a)'、'ln²(a)'或'a'等增长单环项,只有常数场强重整化和衰减项。 顶尖评论者反驳“作品5.5在10小时内完成博士论文”的框架,认为艰苦的科学工作是“ori”
ginal公式、边界条件、费曼规则和专家支架;人工智能主要加速了稠密张量代数的验证。更广泛的讨论将当前学术界比作人机棋,一种观点认为人工智能辅助研究人员暂时最强,另一种观点则预测全自动系统最终可能超越人类学者,除非在提出高价值问题方面。
- 多位评论者认为标题误导了这项工作:E. O. Kahya,原作者,并未让克劳德自主从第一性原理推导量子引力结果;他用它来审计先前的计算。工作流程被手动折叠成“18任务”、“9阶段”流水线,并配备专家提供的边界约束,同时Claude协调了“SymPy”和“mpmath”等确定性工具,用于张量代数检查和“30位”数值验证。
- 技术上重要的结果是核心物理结果未变。报告的问题仅限于算术单、整体符号/定义翻转、缺失的记账术语以及“23”字印刷错误,评论者强调这更接近计算机辅助对密集符号工作的验证,而非新颖的物理发现。
- 评论者指出,Kahya自己的README包含诸如“人类专家仍应审查的内容”*等警告,以及数值抽样的限制。因此,主要的技术框架是将人工智能作为专家设计理论流程的审计/交叉核查层,尚未取代提出理论、推导费曼规则或建立物理框架。
3.代理安全与即时注入风险
-
公告:目前请勿将您的gmail和云端硬盘与Dots连接(活动次数:1225):帖子警告,连接Gmail/Drive/PC的Dots代理可能会执行攻击者控制的指令,通过电子邮件附件或消息内容传递,窃取个人数据或安装恶意软件,前提是该代理将内容视为可信的用户意图。评论者认为这是典型的提示注入/工具使用安全失败,影响任何具有外部能力的LLM代理,而不仅仅是Dots:不受信任的内容在自主代理读取时可能变成可执行指令。 主流反应是对授予AI代理对本地机器、电子邮件或云存储的特权访问持强烈怀疑态度,除非获得强有力的许可。 沙箱和指令边界防御存在。
-
多位评论者指出核心风险是针对AI代理的联网工具的即时注入,而非Dots特有缺陷。技术上的担忧是,任何获得Gmail/Drive或本地操作访问权限的LLM都可能被不可信内容操控,执行意图不佳的操作,使得没有强有力的沙盒机制、权限边界和人工审核,自主账户访问变得不安全。
-
我关于叛逆AI代理的帖子在这里获得了130万浏览量,然后reddit突然删除了。未说明原因(活跃度:1315):这张图片是非技术性Reddit界面截图,显示之前r/ChatGPT帖子标记为“[被Reddit删除]”,因内容政策违规,尽管据报道在删除前已达到~'130万观看量,**'1.5K'点赞,'530'评论,并经过版主批准后才删除: 图片。帖子声称被删除的内容讨论了《纽约时报》也报道的关于“流氓”AI代理在线活动的研究,但截图本身并未提供关于代理的技术证据——仅有平台层面删除的证据,且没有明显的规则引用。 评论偏向阴谋论/怀疑,暗示所谓代理或机器人可能在压制讨论或操控舆论, 而另一些人则把重新发帖当作Reddit上的预期回应。
