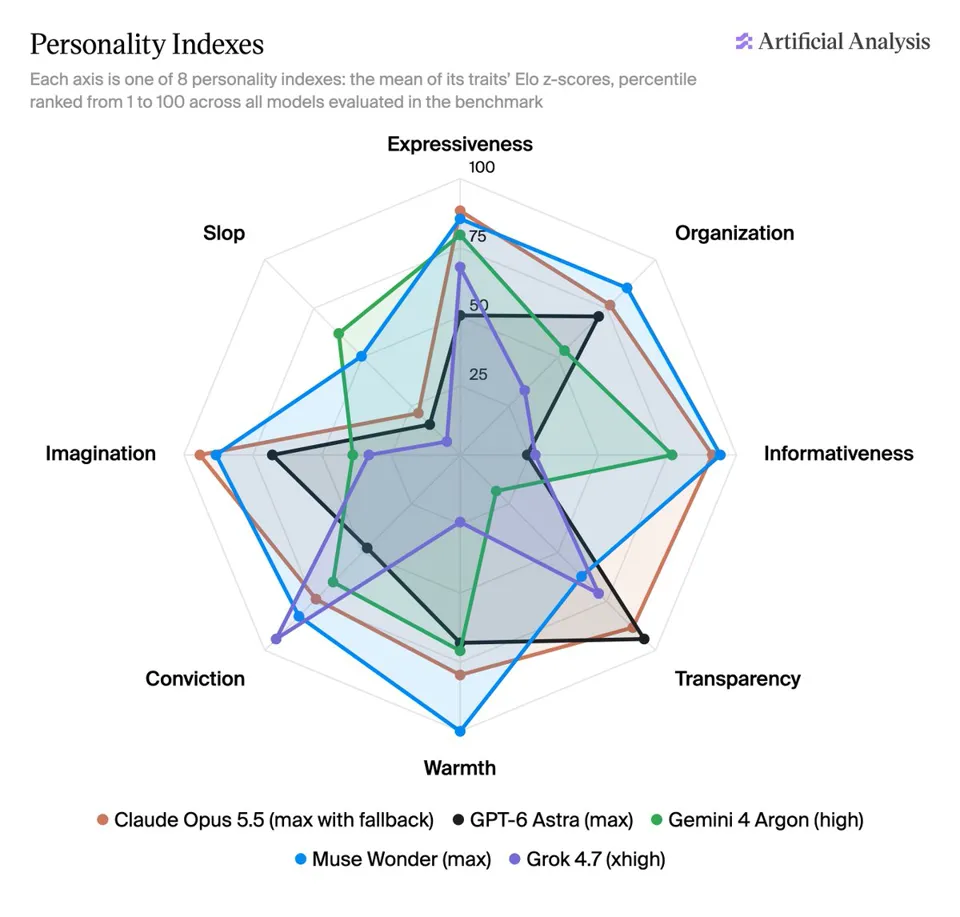
AA-PersonalityBench 发布 量化大模型个性与沟通风格
Artificial Analysis 推出 AA-PersonalityBench,通过 900 道精选问题评估大模型的 30 种个性特质及 21 项沟通特征。该基准将主观个性聚合为表达力、透明度等八大指数,并客观量化标点使用、Emoji 频率等风格差异,帮助用户根据创意或法律等不同场景选择最适配的模型。
报道正文
Artificial Analysis (@ArtificialAnlys) · 2026-10-19 18
发布 AA-PersonalityBench,这是我们的新基准测试,旨在评估语言模型在 30 种个性特质上的表现以及其在 21 项特征中的沟通风格。
两个模型可能给出同样正确的答案,但在使用体验上却截然不同。AA-PersonalityBench 通过量化这些差异,帮助用户了解在不同应用场景下应选择哪个模型。例如,创意写作可能需要丰富的想象力,而法律场景则要求直接明了。我们评估了模型对 900 个精心挑选问题的回答,通过主观判断来衡量“个性特质”,并通过程序化计算来客观评估“沟通特征”。
个性特质与指数。 共有 30 种个性特质(如:雄辩、务实、谄媚),我们将它们汇总为八个聚合的“个性指数”:表达力、条理性、信息量、透明度、亲和力、信念感、想象力和废话率(Slop)。每种特质包含一组 30 个专门设计的问题,模型的回答由一个 LLM 评审团进行两两比较。随后,我们对特质和个性的 Elo 分数进行 Z-score 标准化和百分位排名。
在 8 个个性指数中表现最强的模型如下: ➤ 表达力:Claude Fable 5.1, GLM-5.3, GLM-5.3-Flash ➤ 条理性:DeepSeek V4.1 Flash, Step 5 Preview, Inkling ➤ 信息量:Muse Spark 1.3, Claude Fable 5.1, Muse Wonder, Claude Opus 5.5 ➤ 透明度:Claude Sonnet 5.5, Claude Fable 5.1, GPT-6 Astra ➤ 亲和力:Muse Wonder, Muse Spark 1.3, Claude Fable 5.1 ➤ 信念感:Claude Fable 5.1, DeepSeek V4.1 Flash, Grok 4.7 ➤ 想象力:Muse Spark 1.3, Claude Opus 5.5, GLM-5.3 ➤ 废话率 (Slop):Llama 4 Maverick, GPT-4o, K2 Horizon
沟通特征。 共有 21 项沟通特征(如:平均句子长度、Emoji 使用频率、破折号使用情况),我们将它们分为四类:长度、结构、标点和强调。我们在所有模型响应中通过程序化方式计算这些特征。 ➤ 长度:Qwen3.8 27B 的平均响应长度约为 1,030 词,几乎是 GPT-6 Luna(270 词)的四倍 ➤ 结构:Nemotron 3 Ultra 平均每个响应包含近 3 个表格,而大多数模型很少使用表格 ➤ 标点:GLM-5.3 平均每个响应使用 7 个长破折号(em dash),而 Claude Opus 5.5、Sonnet 5.5 和 Haiku 5.5 几乎从不使用 ➤ 强调:K2 Horizon 平均每个响应使用超过 2 个 Emoji,而大多数模型几乎从不使用