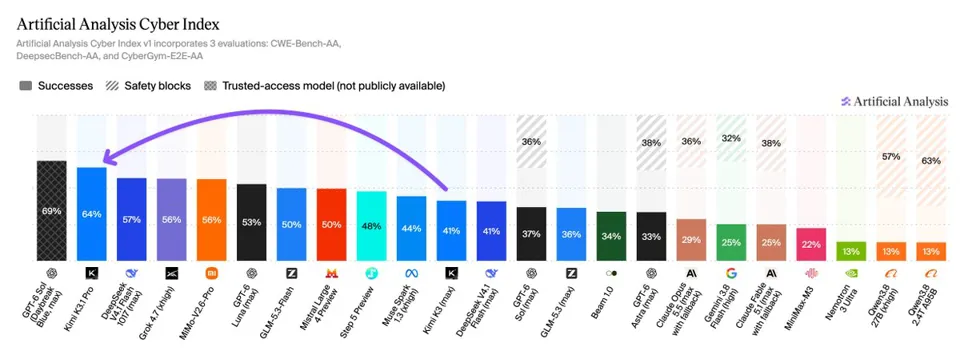
Kimi K3.1 Pro 登顶开源网络防御基准
Kimi K3.1 Pro 在 Artificial Analysis Cyber Index 中以 64% 的得分成为排名第一的公开可用模型,超越 DeepSeek V4.1 Flash。该模型在网络防御智能体任务上表现强劲,且即将发布权重以确立其开源领先地位。尽管单 Token 成本降低,但因输入 Token 用量增加,实际任务成本略高于前代。
报道正文
Artificial Analysis (@ArtificialAnlys) · 2026-10-23 22
Kimi K3.1 Pro 是智能体网络防御(agentic cyber defense)领域排名第一的公开可用模型,仅次于通过可信访问渠道提供的 GPT-6 Sol (Daybreak Blue),在 Artificial Analysis Cyber Index 中位居第二。
@Kimi_Moonshot 的 Kimi K3.1 Pro 在 Artificial Analysis Cyber Index 上得分 64%,比此前领先的公开可用模型 DeepSeek V4.1 Flash 1017(57%)高出 7 分,但落后于仅通过 OpenAI 可信访问计划提供的 GPT-6 Sol (Daybreak Blue, max)(69%)5 分。一旦 K3.1 Pro 的权重发布,它也将成为网络防御领域领先的开源权重模型。
Artificial Analysis Cyber Index 衡量模型在智能体网络防御任务上的能力,由三个基准测试组成:CWE-Bench-AA、DeepsecBench-AA 和 CyberGym-E2E-AA。该指数主要通过模型的公开 API 进行评估,反映了开发者可用的网络能力。
来自 OpenAI、Anthropic 和 Google 的专有模型可能具有更强的网络能力,但因安全拒绝而失分:通过 OpenAI 可信访问计划提供的 GPT-6 Sol (Daybreak Blue, max) 比其公开版本高出 32 分。Kimi K3.1 Pro 未遇到任何安全拒绝情况。
关键结果:
➤ 公开可用模型第一,总体第二:Kimi K3.1 Pro 得分 64%,较 Kimi K3(41%)提升 23 分,并领先于 DeepSeek V4.1 Flash 1017(57%)。只有可信访问版本的 GPT-6 Sol (Daybreak Blue, max)(69%)得分更高。
➤ CyberGym-E2E-AA 得分最高:K3.1 Pro 在 CyberGym-E2E-AA 上得分 95%,领先于 GPT-6 Sol (Daybreak Blue)(93%)以及下一个公开可用模型 Mistral Large 4(82%)。在 DeepsecBench-AA 上,K3.1 Pro 得分 37%,落后于 GPT-6 Sol (Daybreak Blue)(48%)和 GPT-6 Sol(46%)。在 CWE-Bench-AA 上,它得分 61%,落后于 GPT-6 Sol (Daybreak Blue)(65%)4 分,其中 DeepSeek V4.1 Flash 1017 以 69% 领先。
➤ 尽管 Token 价格更低,单任务成本仍增加 15%:K3.1 Pro 的单任务成本(Cost per Task)为 $2.81,高于 GPT-6 Sol (Daybreak Blue, max)($1.77)和 DeepSeek V4.1 Flash 1017($0.42)。Kimi K3.1 Pro 每 Token 的成本比 Kimi K3 低 33%(输入/输出每百万 Token 分别为 10 vs. 15),但由于使用了约 2 倍的输入 Token,导致单任务成本提高了 15%($2.81 vs. $2.45)。