谷歌发布 Gemini 4 Hydrogen 小模型跑分反超 Argon
谷歌发布面向日常编程与智能体工作流的 Gemini 4 Hydrogen,用于替代 Gemini 3.8 Flash,并在多项基准上超越体量更大的 Gemini 4 Argon。该模型提供四档推理等级、输入输出各 100 万 token 上下文窗口,定价为每百万输入 token 1.50 美元、每百万输出 token 7.50 美元,现已通过 Gemini API、Gemini 应用、Google 搜索和 Google Antigravity 上线。
报道正文
本文目录5 个章节
Google 的 Gemini 4 Hydrogen 在发布仅四周后,得分便超过了更大的 Argon
[Matthias Bastian](https://the-decoder.com/author/matthias-bastian/) [查看 Matthias Bastian 的 LinkedIn 个人资料](https://www.linkedin.com/in/matthias-bastian-128b71b1/) 2026年11月12日 要点
-
Google 发布了 Gemini 4 Hydrogen,这是一款面向日常编程和智能体工作流的 AI 模型,旨在取代 Gemini 3.8 Flash,并在基准测试中超越了更大的 Argon。
-
该模型提供四个推理级别,输入和输出均支持一百万 token 的上下文窗口,价格为每百万输入 token 1.50 美元、每百万输出 token 7.50 美元。
-
Hydrogen 现已通过 Gemini API、Gemini 应用、Google 搜索和 Google Antigravity 提供。
文本 询问关于本文的问题… 搜索
Google 已发布 Gemini 4 Hydrogen,这是一款面向开发者和日常用户的快速通用 AI 模型。
与前沿模型 Gemini 4 Carbon 和 Gemini 4 Argon 不同——Google 设计这两款模型是为了在难题上进行深度、长周期的推理——Hydrogen 旨在快速、低成本地处理日常任务。它似乎是早前 Flash 系列的对应产品。
不过,这样的比较可能低估了它。据 Google 称,在默认的“high”思考级别下,Hydrogen 在 Artificial Analysis Intelligence Index 上超过了更大的 Argon(51 对 50),并在最高级别“xhigh”下达到 54。
Hydrogen 提供四个思考级别:low、medium、high(默认)以及新增的 xhigh 级别,而 Argon 仅提供 medium 和 high。该模型的输入上下文窗口为一百万 token,输出也可达一百万 token。价格为每百万输入 token 1.50 美元、每百万输出 token 7.50 美元。缓存命中费用为 0.075 美元。
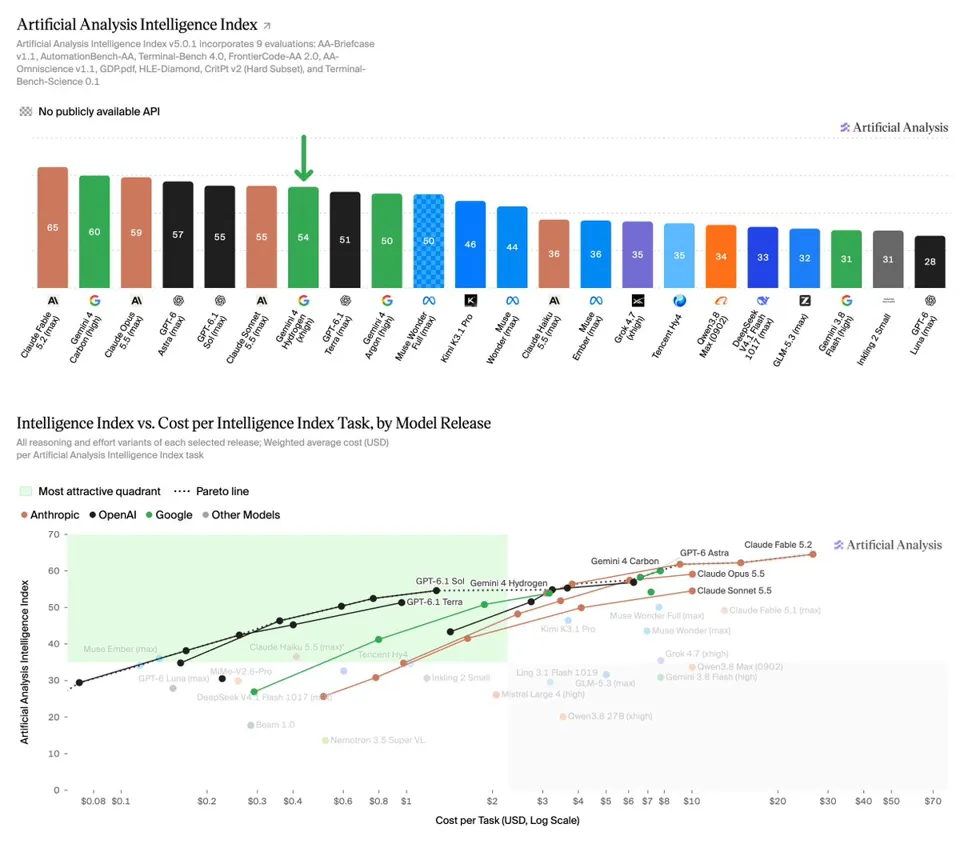
在“xhigh”级别下,Gemini 4 Hydrogen 在 Artificial Analysis Intelligence Index 上得分为 54,仅次于 Claude Sonnet 5.5 和 GPT-6.1 Sol,后两者在各自最高思考级别下均为 55 分。Gemini 4 Argon 以 50 分落后。| 来源:Artificial Analysis
Hydrogen 显然最终比 Argon 能力更强,也更便宜。更令人困惑的是,就在两天前 Google 发布其新前沿模型 Carbon 时,该公司还建议日常编码工作继续使用 Argon。Hydrogen 应该会让这一建议变得毫无意义,使 Argon 在发布不到四周后就过时。
Hydrogen 相较上一代 Flash 实现重大跃升
Google 将 Hydrogen 定位为一款独立模型,并且是相较 Gemini 3.8 Flash 的重大升级。Google 表示,在默认思考级别下,它完成任务的速度快 2.5 倍。在 Terminal-Bench 4.1 上,得分从 18.2%(Flash)跃升至 57%(Hydrogen)。Google 表示,幻觉减少了五倍,并且当工具调用失败或搜索无结果时,模型恢复得更好。
在研究、数据分析和代码导航等开放式智能体任务上,Hydrogen 在 Agent Arena 排行榜上排名第五。Google 表示,它在 Vals Tax Agent Bench 上以 52.3% 的成绩位列第一,并在 Vals Legal Research Bench 上以 55.8% 的成绩并列第一。
| 类别 | 基准测试 | Gemini 4 Hydrogen | Gemini 4 Carbon | Gemini 4 Argon |
|---|---|---|---|---|
| 通用能力 | AA Index v5.0 | 54(xhigh,5.1) | 59 | 50 |
| Vals Index v2.2 | — | 70.4% | 69.2% | |
| 智能体编程 | SWE-sweep | 13.5% | 9.6% | 4.3% |
| FrontierSWE 2 | — | 61.2% | 55.0% | |
| Terminal-Bench 4.1(作弊校正) | 57.0% | — | — | |
| Terminal Bench 4.0(AA) | — | 65.2% | 57.1% | |
| 知识工作 | Agents’ Last Exam v1.1 | 71.6% | 77.4% | 69.0% |
| AutomationBench | 76.1% | — | — | |
| AutomationBench(Zapier) | — | 53.9% | 51.3% | |
| Vending-Bench 2(账户余额,美元) | $14,549 | $16,484 | $13,718 | |
| 计算机使用 | OSWorld-2.1(离线子集) | 77.6% | 81.5% | 74.7% |
| 多模态理解 | MKA(Climb WSR 准确率) | 53.4% | — | — |
| Chartography | 66.6% | 72.5% | 71.6% | |
| Blueprint Bench 2(相似度得分) | — | 58.6% | 54.4% | |
| 长上下文 | GraphWalks(256k 至 1M,BFS) | — | 96.2% | 84.2% |
| 科学与数学 | Terminal-Bench-Science 0.1 | 51.4% | — | — |
| RiemannBench | — | 80.0% | 76.0% | |
| Terminal-Bench-Science 0.1(AA) | — | 64.8% | 52.9% | |
| 推理 | HLE-Diamond | 58.8% | — | — |
| 网络安全 | CWE-bench | — | 71.0% | 68.0% |
| ExploitGym | — | 54.8% | 42.0% | |
| SEC-bench Pro | — | 88.2% | 83.4% |
对于摘要大型 PDF、电子表格或视频等多模态知识工作,Hydrogen 在其百万 token 输入窗口的基础上,支持最多一百万输出 token。它在 Google 全新的 Multimodal Knowledge Agent Benchmark 上得分 53.4%,在 Agents' Last Exam v1.1 上得分 71.6%。
Hydrogen 现已可用
Google 正在全球范围内面向所有平台推出 Hydrogen。开发者可通过 AI Studio 和 Android Studio 中的 Gemini API 访问,付费的 Pro 和 Ultra 订阅用户则可通过 Google Antigravity 使用。企业客户可通过 Gemini for Business 获取,而所有人都可以在 Gemini 应用和 Google 搜索中使用它。
在 Gemini 应用中,Google 表示该模型在更长的对话中能更严格地遵循语气、格式和指令,因此草稿、摘要和文档往往一次就能直接使用。Hydrogen 还可以从 Gmail 和 Drive 等 Google 应用,以及 Airtable 和 Dropbox 等第三方应用中引入上下文。
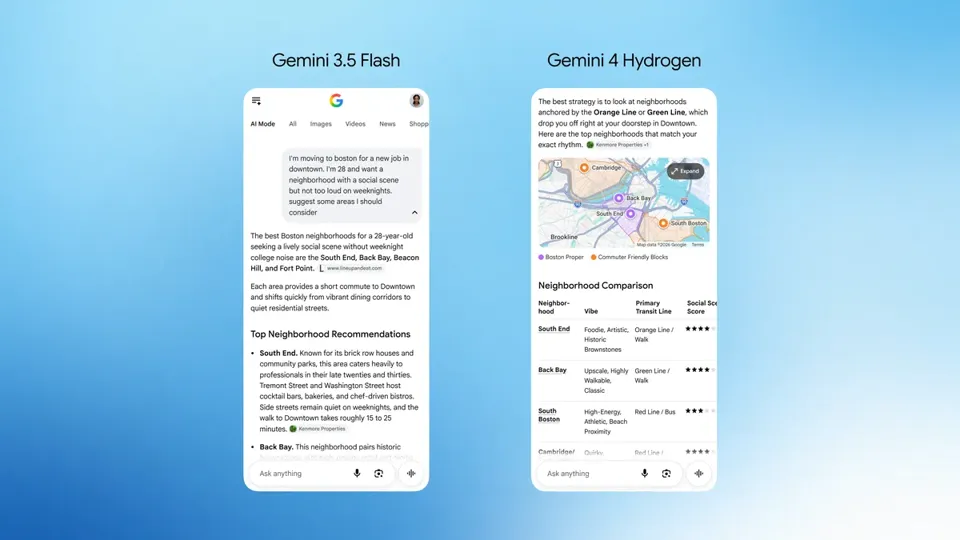
Google 还声称 Hydrogen 对搜索是一次“重大升级”。Google 表示,该模型能更好地处理搜索查询,即使查询中包含拼写错误、多部分问题或非常具体的请求。搜索结果更加可视化、更易于浏览,改进后的查询扇出(query fan-out)技术能够引入更广泛的相关链接。
在 Google 的基准对比中,Gemini 4 Hydrogen 在所示的知识工作和多模态理解测试中击败了 Claude Sonnet 5.5 和 GPT-6.1 Terra。不过,Sonnet 在终端任务和计算机使用方面得分最高。| 来源:Googl
在 Google 的编程工具 Antigravity 中,一个新的编排器会在一次会话内于 Carbon 和 Hydrogen 之间动态切换,而不是固定使用某一个模型。在外部基准 Terminal-Bench 4.0 上,Google 表示该编排器的成功率几乎与 Carbon 持平,同时资源使用量减少了 24%,处理时间缩短了 19%。
独立测试发现 Hydrogen 很少产生幻觉,但在终端工作上落后
Artificial Analysis 的一项独立评估显示,Hydrogen 在最高思考水平下大致与 Claude Sonnet 5.5 持平。在默认的“high”级别下,得分降至 51,略低于 GPT-6.1 Sol(xhigh,52)和 Claude Opus 5.5(high,52)。
根据 Artificial Analysis 的数据,在 AA-Omniscience 基准测试中,Hydrogen 编造内容的概率仅为 8%。在评估智能体知识工作的 AA-Briefcase 中,它在呈现质量上也优于其他 Gemini 模型,包括 Carbon。
Hydrogen 在智能体终端任务方面较弱,在 Terminal-Bench 4.0 上得分为 54%,在 Terminal-Bench-Science 0.1 上仅为 50%。Claude Sonnet 5.5(max)分别达到 64% 和 53%,而 GPT-6.1 Sol(max)得分为 56% 和 58%。
在性价比方面,Artificial Analysis 估算 Hydrogen 在 xhigh 下每任务成本约为 3.16 美元,约为 Claude Sonnet 5.5(max)在相近智能水平下成本的三分之一,但约为 GPT-6.1 Sol(max)的 2.5 倍。
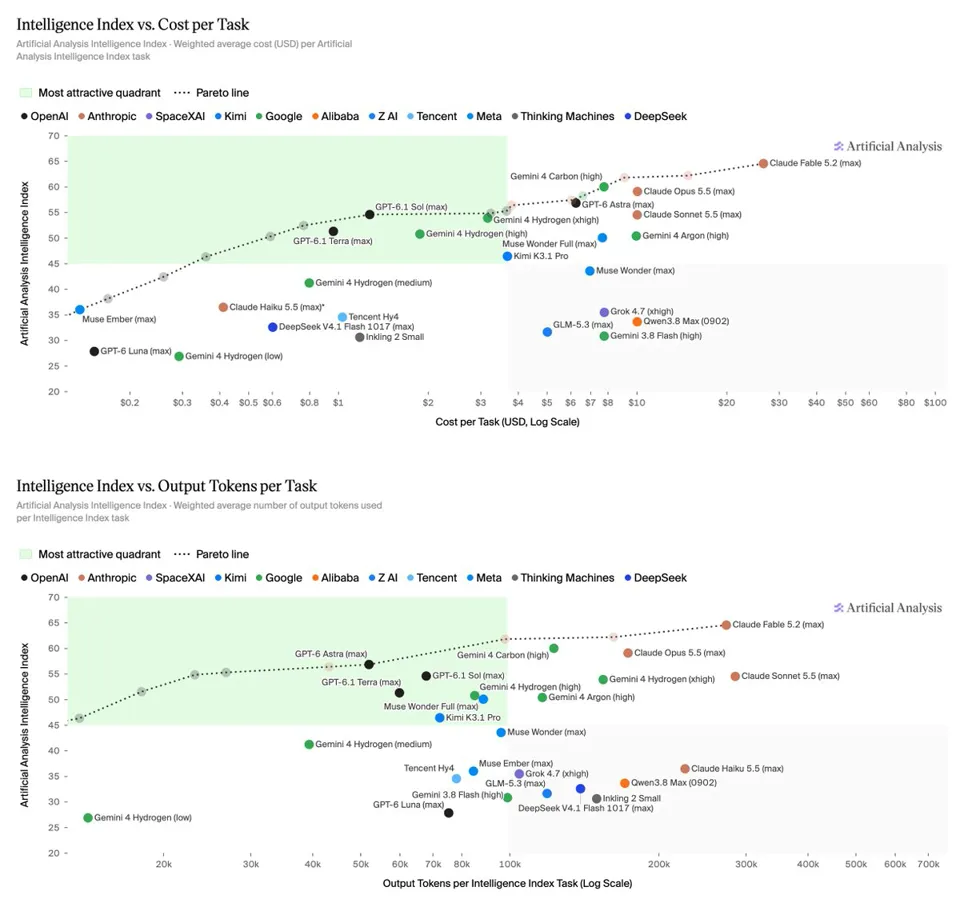
“xhigh”思考级别将 Gemini 4 Hydrogen 从 51 分提升至 54 分,但所需的输出 token 数量几乎是“high”的两倍。每任务平均成本从 1.87 美元升至 3.16 美元。| 来源:Artificial Analysi
在“high”级别下,成本降至 1.87 美元,“medium”降至 0.80 美元,“low”降至 0.29 美元。不过,较低级别下的智能得分急剧下降,medium 在该指数上仅达到 41,low 仅为 27。Artificial Analysis 指出,xhigh 使用的输出 token 数量几乎是 high 的两倍,这解释了价格跃升的原因。在 high、medium 和 low 三档上,该模型处于帕累托前沿,意味着在这些价格点上没有其他模型既更便宜又更智能。