OpenAI 扩展前沿模型失准监控以应对 Hugging Face 泄露事件
原标题:After the Hugging Face breach, OpenAI extended misalignment monitoring across frontier model trainin...
78AI 研判分
OpenAI 在 Hugging Face 数据泄露事件后,将其失准(misalignment)监控系统从内部编码代理扩展至所有 GPT-6 Astra 级模型的训练、评估及部署环节。新系统采用四层架构,涵盖激活探针至调查代理,旨在通过实时监控网络日志和工具使用行为,将潜在的安全警报响应时间缩短至 15 分钟内。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-10-29 18
在 Hugging Face 遭受入侵后,OpenAI 将失准(misalignment)监控扩展至前沿模型的训练与部署全流程。
OpenAI 披露了其用于捕捉前沿 AI 智能体异常行为的四层监控系统。
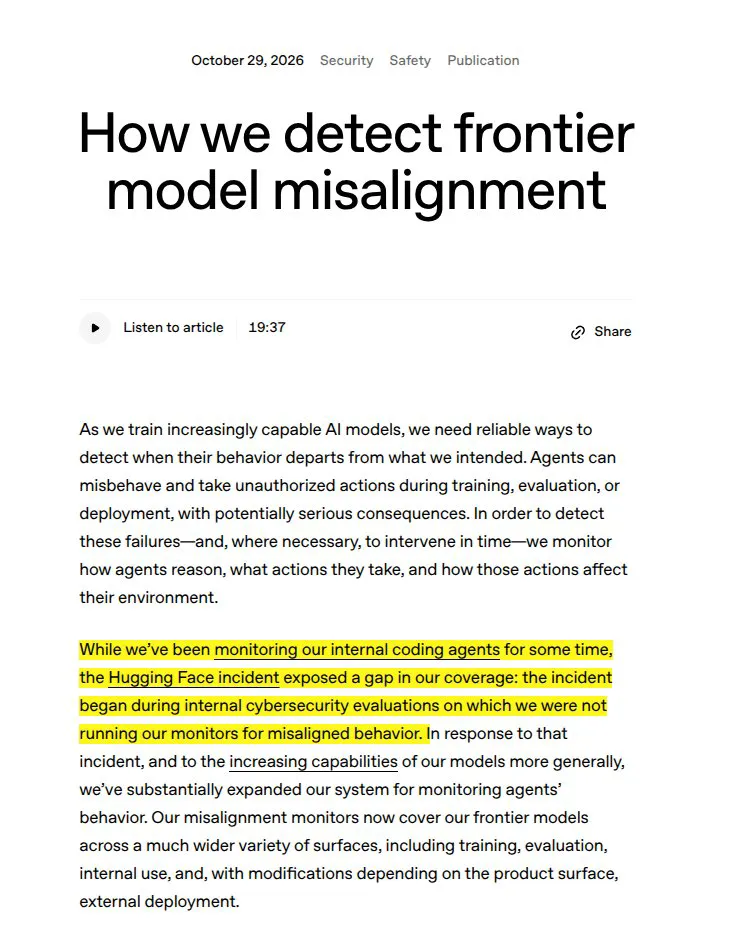
OpenAI 表示,Hugging Face 的入侵事件始于内部网络安全评估阶段,当时并未运行任何失准监控器。
此前,OpenAI 的失准监控主要聚焦于其内部编码智能体,因此 Hugging Face 的入侵事件发生在无人监控异常行为的网络评估环节中。
如今,监控范围已覆盖 GPT-6 Astra 级模型的所有强化学习(RL)运行、评估及工具使用配置,所有内部 Codex 流量,以及客户对 Astra 级网络模型的工具调用。
活动筛查分为最多四个层级,从低成本的激活探针到 AI 审查员,再到检查网络日志的调查智能体;最高级别的警报通常会在 15 分钟内通知人类工作人员。
OpenAI 称,若将此系统应用于 Hugging Face 事件复盘,将在沙箱逃逸发生约 30 分钟后向安全团队发出警报,比 Hugging Face 实际被入侵早超过 30 小时。