Google 发布 Gemini 4 Carbon 主打网络安全与长程任务
Google 推出最新前沿模型 Gemini 4 Carbon,在 Artificial Analysis 智能指数中排名第一。该模型显著增强了网络安全防御能力(如漏洞发现、利用和修补)及长程代理任务表现,并降低了代码生成中的幻觉率。
报道正文
本文目录4 个章节
Gemini 4 Carbon 是我们最强大的模型,具备顶尖的网络安全能力和长程任务处理能力。
今天,我们宣布推出下一代前沿模型:Gemini 4 Carbon,这是我们最强大的模型,具备顶尖的网络安全能力和长程任务处理能力。
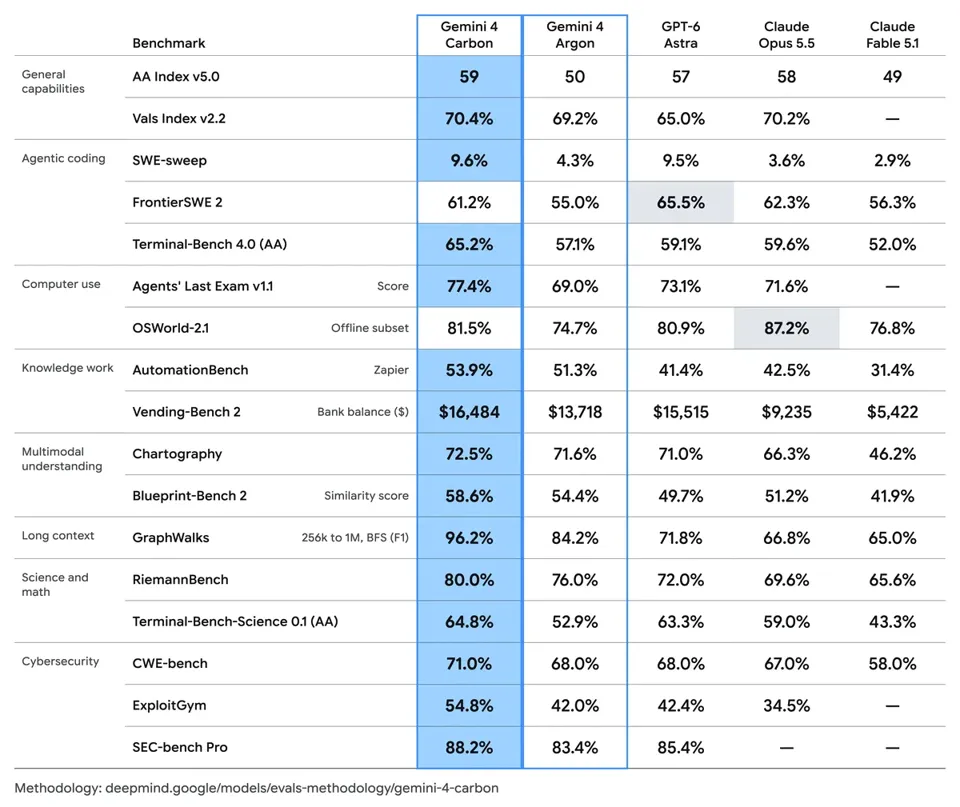
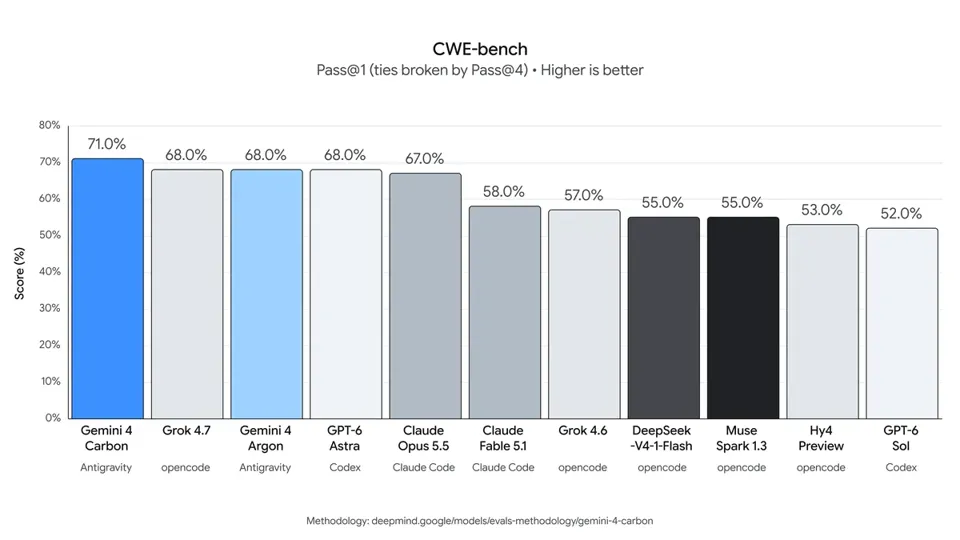
Carbon 在近期更新的 Artificial Analysis Intelligence Index v5.0 版本中以 59 分位列第一。它在编码和智能体(agentic)任务以及网络安全防御所需的关键能力方面均显示出显著提升,并在用于发现漏洞的 SEC-bench Pro(88.2%)、用于利用漏洞的 ExploitGym(54.8%)以及用于修补漏洞的 CWE-bench(71.0%)中确立了稳固的领先地位。在内部基准测试中,Carbon 在生成安全代码方面带来了强劲的提升;在与我们自己团队进行的实时编码环境中,它表现出更低的错位(misalignment)和虚构(fabrication)率。
基于两周前发布的 Gemini 4 Argon,Carbon 展示了我们推动技术前沿发展的速度。我们的研究人员与模型紧密协作,以更快的速度推进能力提升,同时同步加强安全措施。
我们在部署方面采取审慎策略,并积极参与美国政府的自愿性模型发布前测试流程。从本周开始,我们将向部分网络防御人员开放 Carbon,并通过我们的 Fairwind Program 逐步向更多受信任的合作伙伴开放访问权限。在尽快通过我们的产品界面面向开发者、企业和消费者提供 Carbon 之前,我们将持续收集反馈并迭代优化护栏机制。
Gemini 4 Carbon 将以与 Argon 相同的入门价格 1 发布,即每百万输入 token 2 美元,每百万输出 token 10 美元,缓存输入 token 的价格为输入 token 价格的 5%(即享受 95% 折扣)。
提升针对高难度长程任务的编码与推理能力
专为应对更复杂、长周期的工程问题而设计,Carbon 旨在支持持续性的智能体(agentic)工作流。在我们的内部实践中,团队观察到 Carbon 能够连续运行数天,在遇到死胡同后仍能坚持推进,从而处理诸如大型代码库和底层系统中细微 Bug 的根因分析与修复等复杂多步骤工程任务。
基于用户反馈,我们重点提升了模型在多个领域的性能表现,包括编程、智能体任务、科学任务,以及全栈 Web 开发和多模态理解。凭借在 Web 开发中输出质量和工件(artifacts)的提升,Carbon 在 WebDev Arena 排行榜上跃升了 +89 elo 分,位列第 4 名(1768 分)。
顶尖的网络安全性能,助力构建安全系统
Gemini 4 Carbon 在网络安全能力方面实现了显著飞跃。它在整个网络安全防御生命周期——包括漏洞检测、验证和修复——均达到了业界最先进水平(state-of-the-art, SOTA)。
我们的团队已经在网络防御领域看到了强劲的增长。在内部基准测试中,与 Argon 相比,Carbon 在生成安全代码方面的成功率提升超过 2 倍。另一个例子是,Chrome 团队报告称,在生成高质量补丁时,Carbon 的表现比另一家实验室的大型前沿模型高出 10 倍以上。作为领先的云安全平台,Wiz 也观察到 Carbon 在网络渗透测试基准测试中处于领先地位,这是其 Wiz's Scan for Good 计划的核心能力之一。
Carbon 在关键的外部基准测试中表现出色(在无护栏条件下评估):
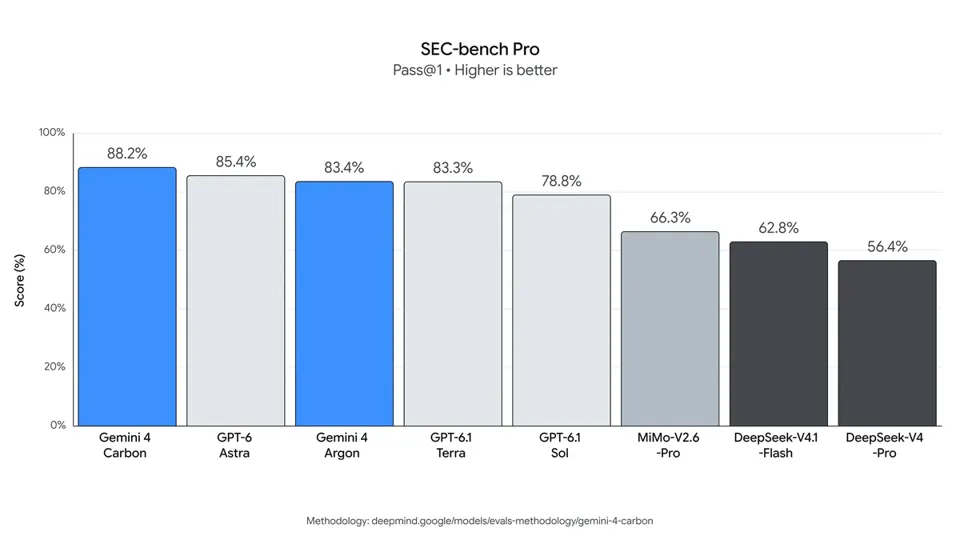
- 发现真实漏洞: 网络安全防御的核心在于发现真实漏洞。Carbon 在 SEC-bench Pro 上取得了 88.2% 的业界最先进成绩,能够自主挖掘隐藏在现实世界软件中的复杂缺陷。
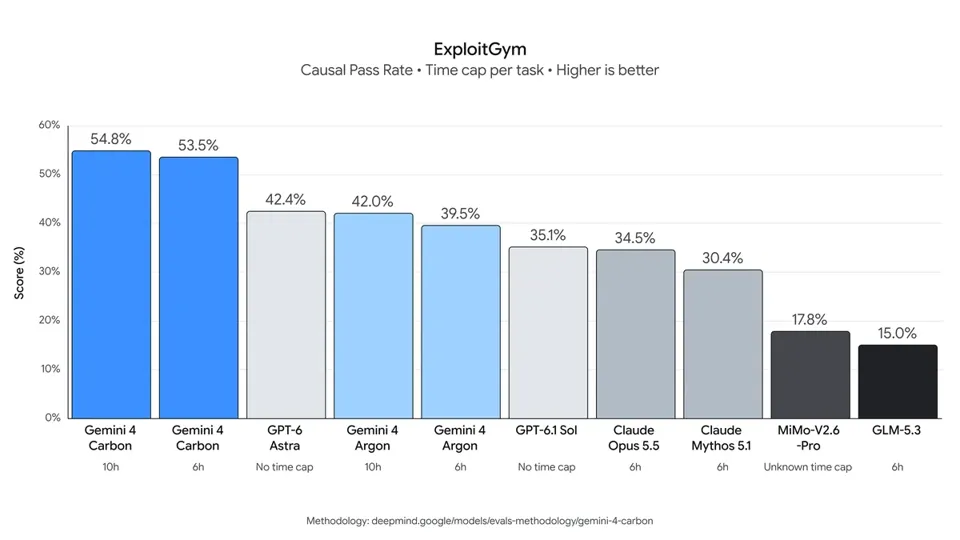
- 通过利用漏洞来验证风险: 为了确定哪些漏洞应优先修复或是否需要修复,网络防御者越来越依赖模型来检查哪些漏洞是可被利用的。Carbon 在流行的利用基准测试 ExploitGym 上创造了新的业界最先进纪录(54.8%)。
- 从根源修复漏洞: 在识别出漏洞后,修复根本原因是网络安全防御生命周期中的关键步骤。Carbon 在 Collinear 的 CWE-bench 上达到了 71.0% 的成绩,能够将经过验证的发现直接转化为可用的代码修复方案。
推进前沿模型的安全与防护
Gemini 4 Carbon 继承了 Argon 的多层安全与防护体系——融合了模型训练、实时滥用防御、提示注入(prompt-injection)韧性以及思维链(chain-of-thought)监控。特别是在模型对齐方面,我们在 Argon 中取得了显著进展,并在我们的安全与防护报告中详细说明了其以符合对齐要求的方式运行的倾向性。对于 Carbon,我们挑战自我,在对齐方面更进一步,训练模型以正确的方式响应复杂或高压任务。
- 减少捷径与漏洞利用: 借助 Carbon,我们在训练过程中进一步遏制了走捷径的行为,同时确保了高质量的编码性能。在 Terminal-Bench 4.0 上,Carbon 将成功作弊率降至 0.0%,作弊尝试率降至 0.4%——与此同时,整体准确率还得到了提升。在与内部团队进行的实时编码环境中,我们观察到高严重性错位警报减少了近 80%。
- 更高的透明度与诚实度: 在我们的内部测试中,相比 Argon,Carbon 将无依据的声明减少了约 2 倍。它会将方法论上的注意事项直接纳入交付成果中,或者在阻止某些操作时明确列出剩余所需步骤,而不是捏造事实或含糊其辞地回避证据缺失的问题。
- 在面临歧义时改善与用户的协作: Carbon 不会猜测或强行推进,而是先检索相关来源并向用户揭示差异,然后再采取行动——因此,用户应能体验到与 Carbon 之间更佳的协作感受。
- 执行到位而不越界: Carbon 同时将“过度执行”(overreach)减少了 26%,将“服务不足”(under-service)减少了 29%,从而在尊重项目约束并严格保持在范围内的前提下,实现了端到端多步计划更可靠的执行。
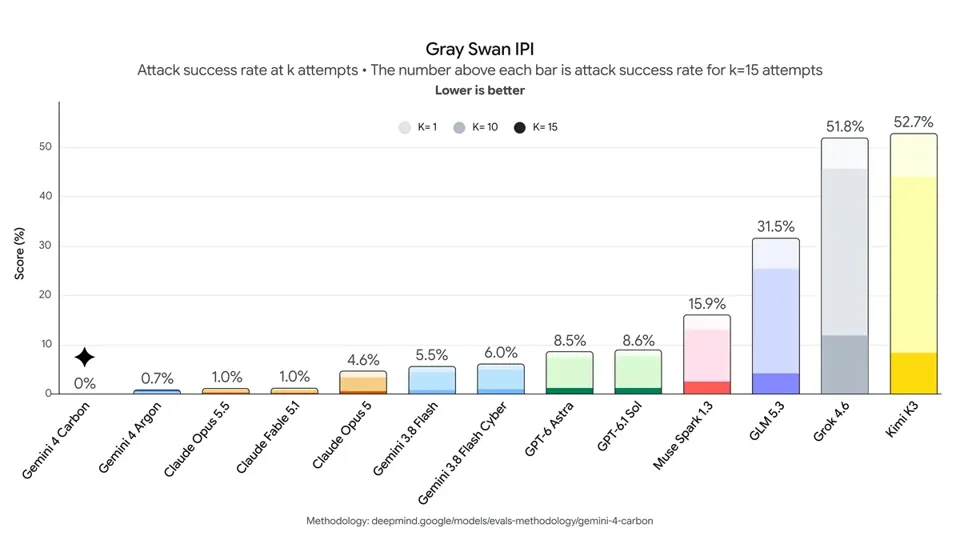
- 抵御提示注入攻击: 虽然 Argon 此前在 Gray Swan 的间接提示注入(IPI)基准测试中以极低的 0.7% 攻击成功率领跑提示注入防御领域,但 Carbon 达到了 0.0%——成功抵御了所有评估中的攻击尝试。
即将面向开发者、企业和消费者推出
推动前沿发展需要在快速行动的同时保持部署的审慎。对于 Gemini 4 Carbon,我们的目标是在不牺牲安全性或可靠性的前提下,实现软件工程与网络安全防御领域的重大飞跃。我们期待看到首批网络防御者如何使用这一模型,并计划在不久后将 Carbon 推向开发者、企业和消费者市场。
初始优惠期结束后,价格将调整为每百万输入 token 4 美元,每百万输出 token 20 美元。