Joy 数据集发布 10 万小时真实语音对话
原标题:Unscripted calls are hard to collect at scale.
78AI 研判分
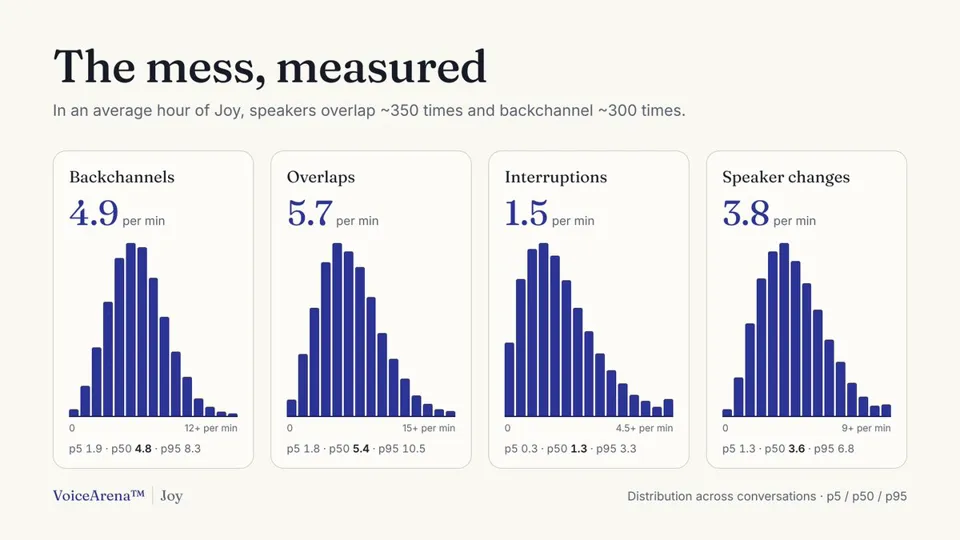
开源社区发布 Joy 数据集,包含 10 万小时、5 万说话人、10 种语言的双通道真实非脚本对话。该数据旨在解决现有语音 AI 依赖合成数据导致的交互僵硬问题,通过提供真实的打断、重叠和自然停顿信号,提升模型对复杂人类对话节奏的理解能力。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-10-29 18
大规模收集非脚本化的通话数据非常困难。 目前的语音 AI 大多是从由 LLM 编写、再由 TTS 朗读的虚假对话中学习,因此它们从未听过人们互相插话的场景;
我很好奇他们是如何让对话持续 10 到 20 分钟的。
他们发布了 Joy,这是一个包含 100,000 小时非脚本化双人对话的数据集,涵盖 10 种语言。
↳ 引用 @shobhitbanga (Shobhit Banga): Drop 1/15:介绍 Joy,一个双通道对话数据集。 真实、非脚本化的两人对话,每人各占一条音轨。旨在教会语音模型人们实际交流的方式:何时倾听,何时插话,何时发出“嗯”的声音。
100,000 小时。 50,000 位说话者。 10 种语言。